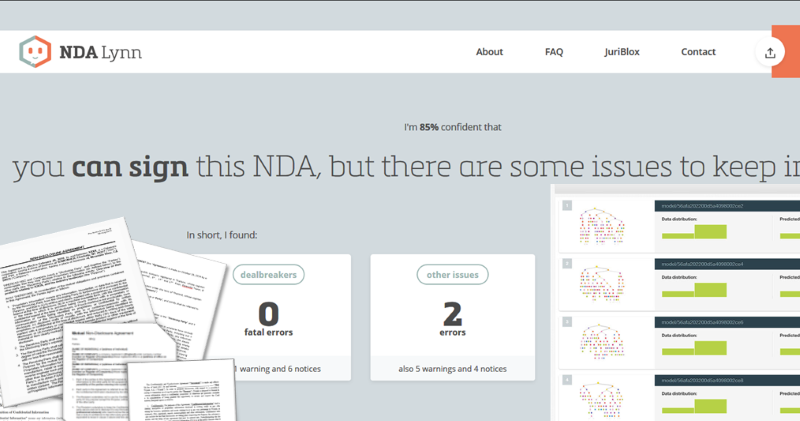
Van idee naar ontwerp, of hoe moet een lawyerbot nu werken? #ndalynnweek

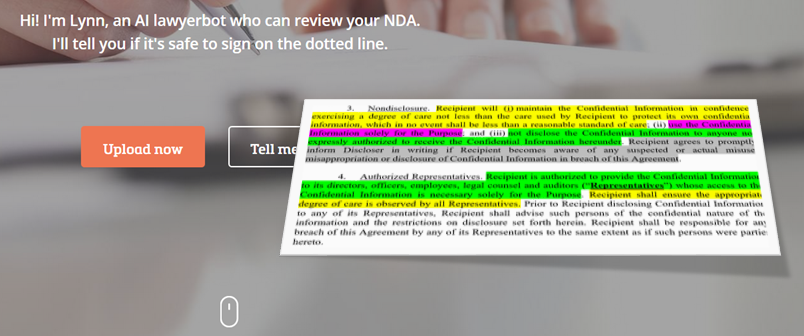
Goed, ik had dus een dataset en daarmee kon ik redelijke voorspellingen doen ook. Tijd dus om het héle ontwerp van Lynn eens te maken. Dan is gelijk de eerste vraag: wat moet Lynn dan precies doen? Nou ja, mij werk uit handen nemen. Ik wil niet meer lastig gevallen worden met “kan ik deze NDA tekenen”. Het doel van Lynn was dus: wees een site die zegt of je die NDA kunt tekenen. Document uploaden, geen gezeur, ja je kunt tekenen.

Ik had zo’n systeem nog niet eerder gezien. Bestaande systemen ondersteunen advocaten in hun praktijk. Het grote voordeel is dan dat ze sneller lezen en altijd even accuraat. Je krijgt dan een document met geel gemarkeerde secties waar iets raar mee is, en je weet dat de rest dan dus standaard is. (Het is ergens heel raar dat bedrijven elkaar doodgooien met teksten waarvan een robot al zegt, dit is standaard lekker laten gaan, maar dat is een andere discussie.) Maar je moet het zelf nog steeds lezen en uiteindelijk je conclusie trekken.

Zo’n advies, gewoon ja of nee zeggen. Hoe moet dat eruit zien. Uit mijn praktijk weet ik dat mensen vaak alleen vragen of er dealbreakers in staan. Grote dingen die heel pijnlijk zijn. Een hele lange termijn. Een boetebeding. Exclusiviteit of een concurrentieverbod. Dat werk. Als je die ziet, dan mag er niet getekend worden.

Dan zijn er nog andere dingen die best vervelend kunnen zijn maar niet perse een dealbreaker. Ja, jij zit in Nederland en men wil Taiwanees recht, dat is niet handig maar even serieus, gaat er echt een rechtszaak komen hiervan? Dat wil je dus wel wéten maar om de NDA daar nu meteen op af te keuren is ook zo wat. Ik noem dit de essentials.

En dan heb je nog de boilerplate, de volkomen standaard tekst die iedereen van elkaar overneemt maar werkelijk niets relevants bevat. Dat de kopjes informatief zijn. Dat de partijen verklaren te mogen tekenen. Dat dit de gehele overeenkomst is. Dat herkent Lynn echt vrijwel perfect (wat niet raar is, in veel gevallen zou een pure string vergelijking minstens zo goed werken) maar niemand wil het weten. Dat moet dus zéér terughoudend terugkomen in de uitvoer.

Met deze opzet komt het erop neer dat Lynn dus allereerst kijkt of er dealbreakers in het document staan. Zo ja, dan is het advies om niet te tekenen. Zijn er essentials met problemen, dan mag je tekenen mits je daar even naar kijkt. (Maar zijn het er te veel, wat ik maar even arbitrair definieer als 30% van de essentials) dan mag je alsnog niet tekenen. En de boilerplate die is er maar dat betekent verder niets. Niemand gaat een NDA weigeren omdat er niets staat over hoe informatief de kopjes zijn.

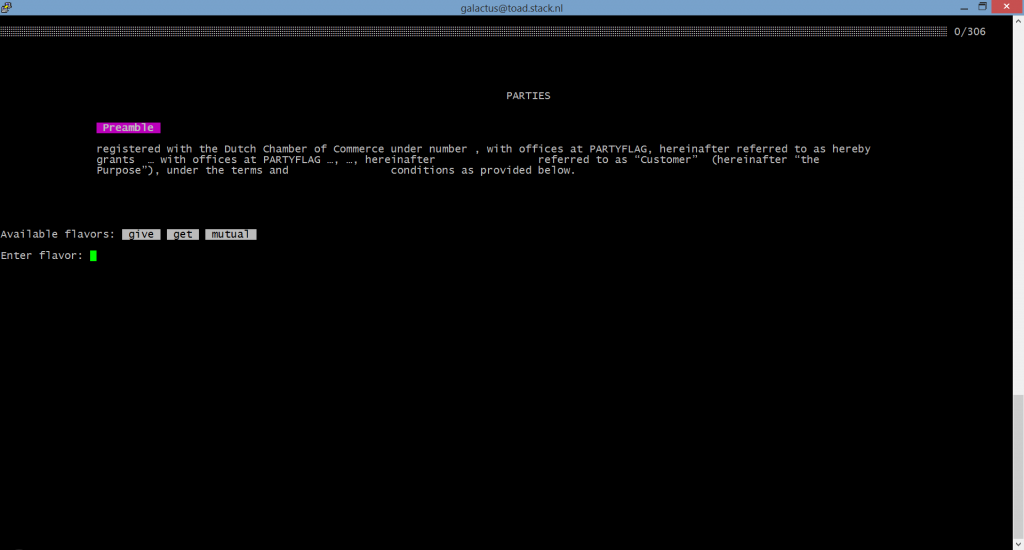
Bij bovenstaande zit wel nog een impliciete aanname, namelijk aan welke kant van de tafel je zit. In het jargon van de NDA-jurist (ja, die bestaat) heb je zogeheten give, get en mutual NDA’s. Een give NDA is geschreven voor de partij die informatie geeft, en is dus heel streng in zijn voordeel. Een get NDA is er juist voor de ontvangende partij, en de mutual NDA probeert beiden even hard te beschermen. (Protip: vraag altijd de mutual NDA, dat scheelt héél veel onderhandelen.)

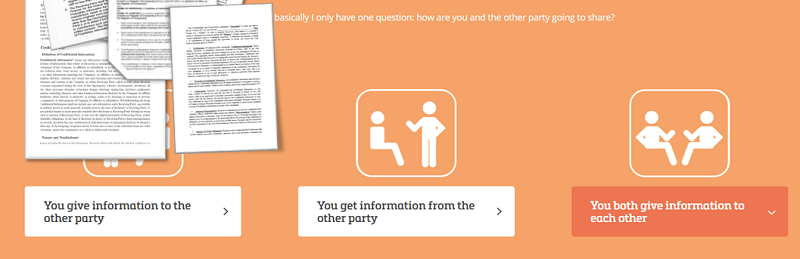
Je moet dus weten welke van de drie situaties je te maken hebt. Dat is dan ook de vraag (en de enige vraag) die NDA Lynn je stelt. Ga je geven, ontvangen of samen delen? Ik vraag nog meer, maar dat is optioneel en vooral voor de statistieken. Eigenlijk alleen de vraag “in welk land zit u” komt terug in het antwoord: als dat niet hetzelfde is als de rechts- en forumkeuze dan krijg je daar een waarschuwing over.
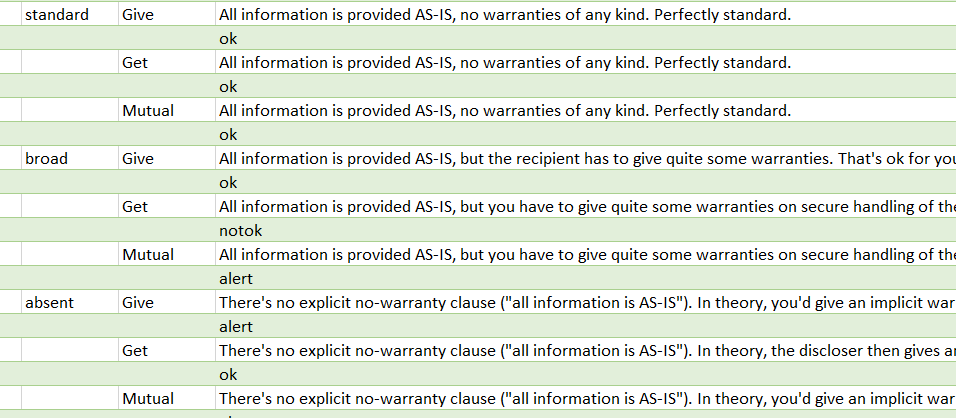
Blijft over: wat ga je zeggen. Daarvoor schrijf ik een uitvoertabel, die per clausule per smaak per situatie aangeeft wat het antwoord moet zijn. Hierboven zie je een klein stukje daarvan: dit is de uitvoer voor de categorie “warranties” oftewel garanties. Wat moet je zeggen als deze standaard of juist breed gevraagd worden, of als er geen garanties in staan. Je ziet dat het antwoord net anders is als je in de give dan wel in de get of mutual situatie zit.

En dan zijn we er. Document tekst extraheren, met een ML model de zinnen classificeren, de zinnen bij elkaar rapen, van de clausules het juiste smaakje bepalen, in de uitvoertabel opzoeken welke uitvoer je moet geven en klaar is Kees. Of Lynn dan.

We testen, en komen de nodige probleempjes tegen. Zo voegen we taaldetectie toe (“Sorry, Portugese NDA’s worden niet ondersteund”), is het extraheren van tekst uit PDF net wat ingewikkelder en staat er soms gewoon rommel in een document. Maar dat is allemaal op te lossen. Tijd om de markt op te gaan.

(Dit is de derde van vijf vakantieberichten.)

Arnoud
Van bak met data naar een werkende lawyerbot #ndalynnweek

Weet je wat het idiootste is aan AI? Dat iedereen het maar over algoritmes heeft en hoe spannend of bedrijfsgeheim die zijn. Het labelen van je data, dát is waar de kwaliteit van je systeem mee staat of valt. Ik vind het dan ook erg raar dat je overal leest dat men een blik studenten opentrekt of via diensten als Mechanical Turk willekeurige mensen labels laat zetten. Of dat wij via reCaptcha en dergelijke diensten zeggen waar zebrapaden lopen of verkeerslichten te zien zijn. Data is de kern van je dienst, dus hoezo besteed je dat uit en pronk je vervolgens met je unieke algoritmes die uiteindelijk niet ter zake doen?

Natuurlijk, studenten inzetten is goedkoop maar waar vind je de rechtenstudent die in honderd NDA’s zinnen kan herkennen als zijnde overmacht, verlenging, aansprakelijkheid met boete enzovoorts? In een rechtenopleiding krijg je welgeteld nul contracten te lezen (ja, serieus) laat staan een specifiek document als een NDA.

Dus nee, er zit niets anders op dan het zelf te doen. Gelukkig vind ik het perfecte moment om dit te doen: mijn dochter van een paar maanden oud slaapt ’s nachts beter als ik in de kamer zit, dus ik leg mijn laptop klaar en ga labelen tot ze slaapt. Zo kom ik in een paar maanden tot een volgens mij keurig gelabelde dataset. Een paar steekproeven op de resultaten laat zien dat ik redelijk consistent label, ook al heb ik geen formele criteria opgesteld om clausules te categoriseren.

Dat is ergens ook wel een beetje de makke van zo’n systeem. Er zijn geen echte categorieën waar je op terug kunt vallen, je moet zelf maar iets bedenken. Zowel het soort clausule (is een vrijwaring een vorm van aansprakelijkheid of iets heel anders) als de smaakjes daarbinnen (is een ton aansprakelijkheid erger dan een boete van 10k per gelekt geheim). Dus ik doe maar wat. Bij elke zin bedenk ik een categorie, en na driehonderd zinnen ga ik categorieën samenvoegen en splitsen.

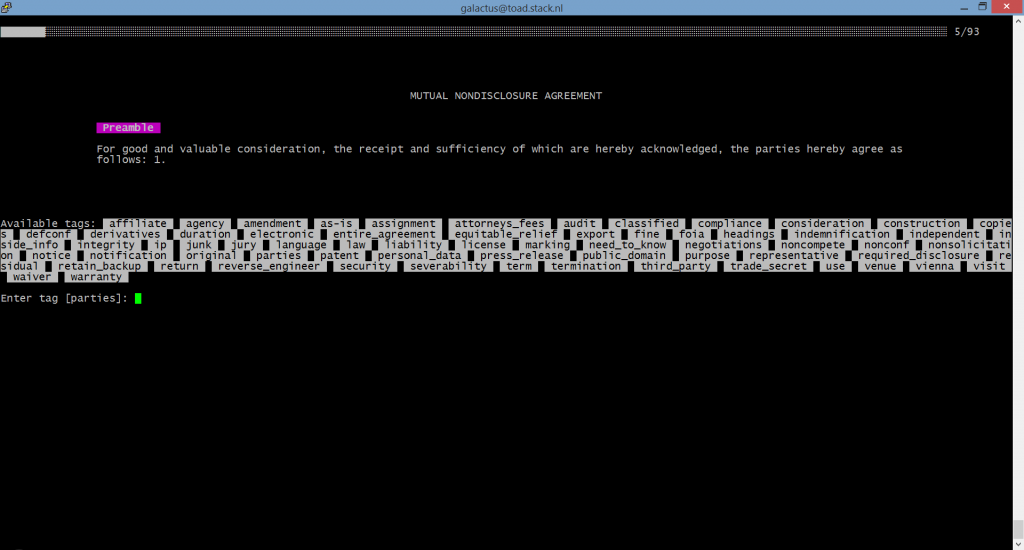
Hier, de tagger waarmee ik al die tijd heb gewerkt om zinnen van labeltjes te voorzien. Je ziet hoe het aantal categorieën is geëxplodeerd:

En de clauser, waarmee ik groepen zinnen (clausules dus) van een smaakje kon voorzien:

Dan heb je dus een berg zinnen en bijbehorende clausules, en daarmee kun je BigML gaan trainen. Dat had nog heel wat voeten in de aarde. Het eerste datasetje deed het goed, het voelt echt héél gaaf als je dan een test doet:

galactus@toad:~> php tagtest.php
input text: "Recipient shall use the same level of security as it uses for its own sensitive information to protect the Confidential Information against unauthorized use or disclosure, but at least a reaasonable level of security."
..... bigml says: security / standard
galactus@toad:~> 
En dat klopte helemaal. Maar er zaten genoeg fouten in. In het jargon: de F1-score was maar 0,64 en dat is niet genoeg om een commerciële dienst op te drijven. Terug naar de tekentafel dus, of beter gezegd de datatafel.

Allereerst viel me op dat ik toch wel wat foutjes had gemaakt. Dit haal je uit de confusion matrix, waarbij je kunt zien welke uitvoer op welke foute manier gelabeld wordt. Dan zie je bijvoorbeeld dat ‘parties’ clausules vaak als security clausules worden aangemerkt, zodat je specifiek daar extra voorbeelden van toe kunt voegen en foutcorrectie kunt doorvoeren.

Ook ontdekte ik dat ik de nodige categorieën had die ik zelf eigenlijk niet snapte. Overlap tussen categorieën maakt dat ML systemen slecht performen. Snoeien dus, en zorgen dat je per categorie duidelijk kunt aangeven wat erin hoort. Toch het nadeel van in halfslaap taggen wellicht?

De ingewikkeldste ingreep had te maken met dit soort clausules:

Recipient shall (a) treat all Confidential Information with the highest care; (b) only permit persons having a clear need to know access; (c) evaluate the Confidential Information at its own risk; (d) comply with relevant export regulations; (e) indemnify and hold harmless Discloser from any damages in connection with usage of the Confidential Information; and (f) waive its right to a jury trial.

Welke categorie plak je hier nu weer op? Het artikel regelt van alles, van security eisen tot wie het mag zien tot aansprakelijkheid en iets met juryrechtspraak. Daar kun je dus helemaal niets mee. Dat moest worden opgesplitst. Een hele vieze reguliere expressie (dit gaat een thema worden in het verhaal) splitste zo’n clausule in meerdere tegelijk, waarbij elke één van die zes bullet items bevatte.

En wat ook nog eens leuk bleek te werken, was bij elke zin mee te geven op welke plek hij in het document stond. Een zin over Florida aan het begin van een NDA gaat meestal over waar een partij gevestigd is. Staat hij aan het einde, dan is het waarschijnlijk de rechtskeuze. Dus kreeg elke zin als extra veld mee waar hij in het document stond. En hoe lang hij was (in woorden) want dat blijkt ook uit te maken. Grof gezegd, hoe langer een zin hoe strenger de bepaling. Soms is juridisch werk heel makkelijk.

Stiekem ook nog wat reguliere expressies bij de kwalificatie van clausules. Want sommige dingen zijn inschattingen (is dit streng of juist niet), anderen zijn gewoon simpel lezen. Een rechtskeuze voor Florida is geen inschatting, dat zie je gewoon letterlijk staan. Dus als je weet dat een clausule over rechtskeuze gaat (dat zegt de 1st stage classifier) dan kijk je gewoon welk land je ziet staan in die clausule en dat zal de rechtskeuze dan wel zijn.

Idem voor duur van het contract. Een AI heeft héél veel moeite met lezen of er staat dat een contract drie jaar duurt. Maar een reguliere expressie vindt hem zo. Deze oplossing is wat lomp, maar computers zijn snel en krachtig genoeg en het scheelt ontzéttend veel in de uitvoer. Mag ik zeggen, de regexp is de ducttape van de artificial intelligence?

Als laatste truc voegde ik vlaggetjes toe. Een machine learning systeem kijkt in principe naar losse woorden, maar juist in juridische teksten gebruikt men vaak vaste uitdrukkingen (“reasonable security measures”, “confidential information”, “receiving party”) en die moet je dus niet opsplitsen. De vlaggetjes werden toegevoegd met wéér een setje reguliere expressies, en dat gaf alles bij elkaar een hele mooie verbetering: een F1 van 0,86. Genoeg om de markt mee op te durven.

(Dit is de tweede van vijf vakantieberichten.)

Arnoud
De geboorte van NDA Lynn, of hoe bouw je een lawyerbot #ndalynnweek

Heb jij ook wel eens gedroomd van een robot die je werk overneemt? Nou ik wel, want ik was het reviewen van geheimhoudingscontracten (NDA’s) ondertussen méér dan zat. Steeds maar ongeveer dezelfde teksten van ongeveer hetzelfde commentaar voorzien en opletten dat dezelfde stomme valkuilen er niet weer in zitten. Dat moet toch automatisch kunnen, leek me. Dit soort documenten is immers zó standaard opgesteld. En omdat ik ook nog ooit iets met informatica had gedaan, besloot ik zelf met haar aan de slag te gaan. In oktober 2017, na ruim een jaar bouwen, lanceerde ik deze lawyerbot, en ik noemde haar NDA Lynn. En nu, bijna drie jaar later, werken we aan de gaafste feature die ik ken: Edit Mode. Lees mee in deze X-delige serie hoe we van daar naar hier kwamen.

Ik weet niet meer precies wanneer ik kwam op het idee van Lynn. Maar het lezen en becommentariëren van al die NDA’s was ik al jaren zat. Ik doe het ook al een kleine twintig jaar. Eerst bijna tien jaar bij Philips, daarna (sinds 2008) als partner bij ICTRecht. Ik schat dat ik meer dan drieduizend NDA’s heb gereviewd in die tijd. En altijd was het verhaal ongeveer hetzelfde, want op hoe veel manieren kún je nu eenmaal zeggen dat je informatie gaat delen die je dan geheim moet houden, met geschillen te behandelen in Amsterdam en geen garantie op de juistheid van de informatie.

Ik weet nog wel dat ik op zeker moment drie NDA’s van drie klanten op één dag deed. Volledig ongerelateerd alle drie, maar de teksten kwamen grotendeels overeen. Toen ging het dus knagen: zou dat te automatiseren zijn? Het is in feite alleen maar tekstvergelijking, iets waar computers veel beter in zijn dan ik. Maar het gaat wel een stapje verder dan alléén maar het bekijken of twee alinea’s grofweg dezelfde tekens bevatten.

De hype rond AI en machine learning was toen al aardig op gang. Zou het met bijvoorbeeld Google of Microsoft’s cloudbased machine learning systemen kunnen? Het zag er allemaal veelbelovend uit, maar er was één groot nadeel. There is no cloud, it’s just someone else’s computer. Ik zag het niet zitten om voor deze dienst afhankelijk te zijn van een online service van een ander, ook niet als die gratis was.

Toen kwam ik het Spaanse BigML tegen. Een sympathieke dienst, een API die je meteen een goed gevoel geeft én de mogelijkheid om ML modellen offline in te zetten. Dus gewoon zeg maar een executable op je eigen server, zodat het niet uitmaakt of hun dienst beschikbaar is of niet. Dat was precies wat ik nodig had.

Hier, het resultaat van een avondje prutsen (ja, in PHP, dat was het makkelijkste) om eens te zien hoe dat nu werkt, zo’n machine learning systeem:

do {
  $res = bigML("poll", $bpid);
  if (isset($res["status"]["code"])) {
    if ($res["status"]["code"] != $oldstatus) {
      echo "\n => ".$res["status"]["message"];
      $oldstatus = $res["status"]["code"];
    } else
      echo ".";
  } else
    print_r($res);
  if ($i > 0) sleep(1); $i++;
} while (($res["status"]["code"] != "5") && ($i <= 10));

Het werkte prachtig. Alleen: een machine learning systeem is niets zonder data. In mijn geval dus NDA’s. Hoe kom je daar nou aan?

Een geluk aan de NDA is dat hij zo wijdverspreid is dat je er met gemak een paar honderd op internet vindt. Dat is dus het eerste dat ik deed. Daarnaast had ik er zelf natuurlijk een heleboel, alleen die had ik voor klanten geschreven of gelezen en dan kun je dus niet zomaar die in je eigen systeem stoppen. Later, met Lynn al draaiende, zou dat geen probleem meer zijn: Lynn is gratis maar je moet me toestemming geven je NDA te gebruiken voor verbetering van de dienst. Ik heb er nu een dikke 5000. Maar in het begin was het een serieuze uitdaging om de juiste NDA’s te vinden. Daarover een volgende keer meer.

Het basisidee van Lynn is vrij rechttoe rechtaan. Je krijgt een NDA, je extraheert de tekst, je kijkt welke clausules er zijn en zegt voor iedere clausule of deze acceptabel is of niet. Er zijn tools genoeg die een geupload document kunnen converteren naar tekst, en genoeg libraries ook voor tekstmanipulatie op zich. En als je weet wat voor clausule je hebt, kun je gewoon in een tabel kijken of hij acceptabel is of niet. Maar hoe weet je nu wat voor clausule je hebt?

Machine Learning (ML) is een vorm van AI waarbij een grote hoeveelheid data wordt geanalyseerd op gemeenschappelijke onderscheidende kenmerken. Hiermee maakt het systeem een functie die grofweg zegt of iets categorie A, B of C is. Als je dan een nieuwe input hebt (in mijn geval dus een nieuwe clausule) dan kijkt het systeem met die functie in welke categorie het hoort.

Dat betekent dus dat ik een dataset moet maken die een paar honderd NDA clausules bevat. En van elke clausule heb ik diverse smaakjes nodig, zeg maar wat is een strenge beveiligingsclausule en welke is juist lekker relaxed. Dan kan een ML systeem gegeven een inputclausule zeggen of deze het meest lijkt op een strenge beveiligingsclausule of juist eerder een rechtskeuze voor Florida. En als ik dat heb, kan ik een advies uit mijn tabel halen.

Dan het volgende probleem: hoe vind je nu precies een clausule? Na een stuk of dertig NDA’s te hebben bekeken, kom ik tot de conclusie dat daar geen standaardmanier voor is. Iedereen groepeert teksten op zijn eigen manier. Soms zijn het keurig genummerde alinea’s, anderen doen een opsommingslijstje en weer anderen maken gewoon een lap tekst met willekeurig een enter hier en daar.

En dan heb je ook nog grapjassen die verderop nog even terugkomen op een onderwerp. Zo zie ik die beveiligingseisen op drie of vier plekken in het document staan, zodat je niet eens kunt spreken van een beveiligingsclausule. Of er wordt op allerlei plekken geroepen dat er aansprakelijkheid is voor X of Y.

Nee, er zit niets anders op. Niet kijken naar clausules, je hebt alleen zinnen. Dat betekent dus, extraheer de zinnen uit het document, label die met hun onderwerp en voeg alles samen dat hetzelfde onderwerp is. Dat is dan je “clausule”, en daar kun je dan een kwalificatie op doen hoe streng of relaxed die is.

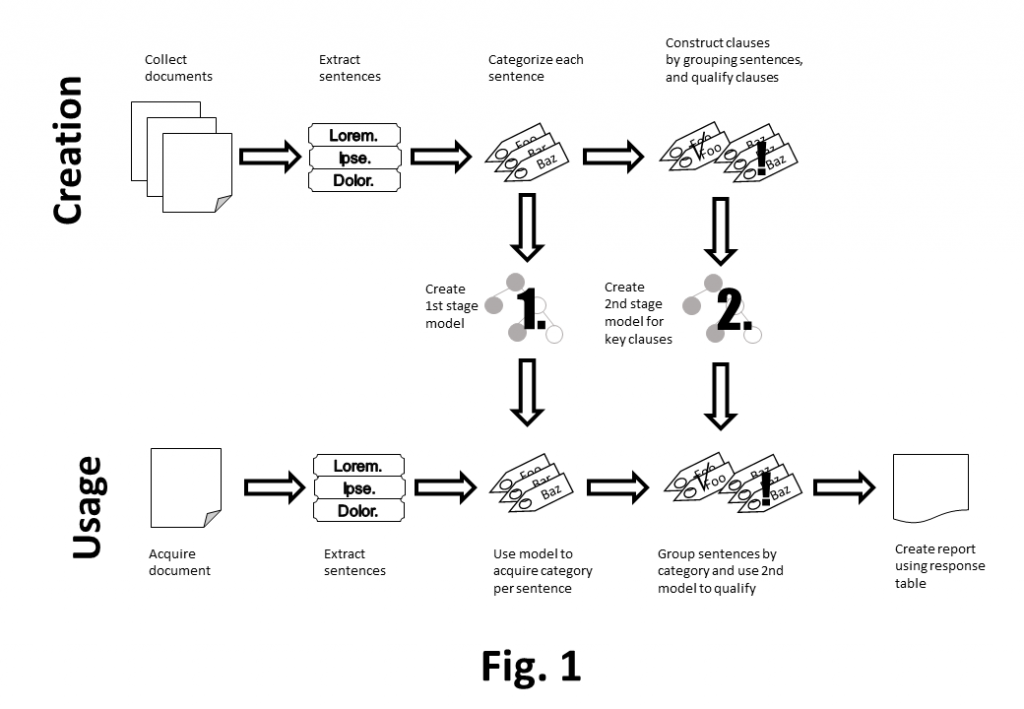
Zoals je hieronder ziet, krijg je dan een systeem waarbij je twéé machine learning componenten inzet. Het eerste zegt van een zin welke categorie het is (het 1st stage model) en het tweede systeem zegt van alle zinnen uit één categorie welk smaakje daaraan te geven is (het 2nd stage model). Gelukkig zijn ML systemen razendsnel, zeker de offline modellen die BigML kan aanbieden. Want je wil echt niet per zin een aanvraag doen bij de systemen van Google of Microsoft en dan een seconde wachten op het antwoord.

Deze architectuur ziet er goed uit. Hij heeft alleen één groot nadeel: ik moet nu niet langer een paar honderd clausules van een labeltje voorzien, maar een dikke duizend zinnen. Want elke clausule telt een zin of vijf, zo ontdek ik al snel. En als ik dat heb gedaan, dan moet ik daarna ook nog eens de zinnen van dezelfde clausule bij elkaar vegen en daar weer een labeltje op plakken dat me vertelt welke smaak de clausule is.

En hoe ik daarmee aan de slag ging, dat vertel ik morgen.

(Dit is het eerste van vijf vakantieberichten.)

Arnoud
Als je een legal tech kantoor wilt hebben, moet je klein beginnen #legaltechtuesday

De grootste fout die softwareontwikkelaars maken: versie 3.  Dat is namelijk de versie waarbij men besluit de oude rommel eens weg te gooien en hélemaal opnieuw te beginnen. Lekker een schone lei, al die rare dingen het raam uit en een mooie, strakke set code. Dat kost alleen ontzettend veel tijd en je gaat alle oude fouten nog eens tegenkomen. Die oude code was namelijk zo raar en rommelig omdat er ontzettend veel fouten mee ondervangen moesten worden. Ditzelfde fenomeen zie je wanneer organisaties besluiten tools zoals legal tech software in te zetten. Laten we alles opnieuw invullen, de hele workflow aanpakken en alles netjes opnieuw neerzetten. Dat werkt dus net zo min.
Legal tech is software die een juridisch proces ondersteunt – maar meestal het proces op een nieuwe manier invult. De neiging van software is om groter en groter te worden (“totdat het ook kan e-mailen”, was ooit het mantra) en dat betekent dat je als klant dus een enorme verandering over je heen krijgt wanneer je zulke software inzet.

En vooral: je krijgt dan dus een enorme organisatieverandering wanneer je zulke software inzet. Zie mijn column van vorige maand: legal tech is een cultuurverandering. Hoe groter die is, hoe lastiger het is om die met succes door te voeren. Want je krijgt meer weerstand, en sowieso moet je meer moeite doen om iedereen al die veranderingen te laten doen. Dat verkleint serieus je kansen op succes.

Ik spreek ondertussen best veel mensen over legal tech (en krijg in de mail ook vele vertrouwelijke oorlogsverhalen, blijf ze sturen meiden&jongens), en de teneur is inderdaad vaak dat er een groot en glimmend ding naar binnen gereden wordt, mensen in frisse polo’s flitsende demo’s laten zien en de directie dan zegt “en vanaf nu alles hiermee”. Om vervolgens mensen aan te spreken op declarabele uren en niet te meten hoe vaak er met de nieuwe tool wordt gewerkt. Ja, vind je het gek.

En het grappige is, er is juist al héél veel winst te halen uit kleine stapjes. Zo veel laaghangend fruit, in het Engelse jargon, dat je kunt plukken. Zet een documentgenerator naast je oude set met templates. Voeg een knopje toe aan Word waarmee je jurisprudentie snel kunt opzoeken. gebruik tools die een specifieke klus versnellen, enzovoorts. Zo leren mensen proeven van dit soort vernieuwingen, en dat smaakt naar meer.

Arnoud

De adoptie van legal tech gaat de advocatuur gewoon bypassen #legaltechtuesday

Jaja, het coronavirus zou de grote transformatie in legal tech land met zich meebrengen. Maar om heel eerlijk te zijn heb ik het idee dat dat toch wat rustiger gaat nu het lijkt (nadruk op lijkt) alsof die crisis aan het overwaaien is. Wat ik ondertussen wel heel grappig vind om te merken, is dat er wél steeds meer vraag en aandacht voor legal tech oplossingen komen vanuit andere dienstverleners. Ik heb dat al eerder geroepen, maar ik zie nu meer bevestiging: door legal tech kunnen andere beroepsgroepen meer van het juridische erbij gaan doen, want dat versterkt hún eigen dienstverlening. Oh en ze zullen goedkoper zijn voor dat juridische.

Bij Artificial Lawyer las ik over de lancering van de “Legal Business Services” groep van Deloitte, een van de Big 4 accountantskantoren. Dat gaf veel ach en wee in Amerika, als zo’n grote jongen met een bak met geld juridische diensten gaat verrichten dan is dat het einde van de advocatuur. Net zoals advocaten wel konden inpakken toen we rechtsbijstandsverzekeraars kregen. Niet dus. (En de grap is dat Deloitte in de meeste staten helemaal geen juridisch advies mág geven want adviesmonopolie.)

Het signaal is wel een mooie, want van een accountantskantoor zou je niet direct juridisch advieswerk zoals contracten verwachten. Maar het kan natuurlijk wel, en als je anno 2020 een nieuwe dienst in die niche opzet waarom zou je dat dan niet met legal tech doen? Dan ben je sneller, effectiever en met minder mensen klaar dan de traditionele dienstverleners.

In Nederland geldt geen adviesmonopolie voor advocaten, iedereen mag juridische diensten verlenen. Alleen procederen is gedeeltelijk een afgeschermde markt. Dus als je als boekhouder, accountant, coach of welk beroep dan ook juridische diensten erbij wil doen, dan kan dat. En met legal tech kan dat vaak ook nog goedkoop én op het niveau van een advocaat of jurist. Dat zijn immers gewoon de documenten of kennis die je erbij koopt.

En omdat je het goedkoop inkoopt, kun je het goedkoop wegzetten als je wilt. Ik zie daarbij vooral interesse in het gratis (of bijna gratis) weggeven van de dienst. Als lokkertje, als upsell, als complimentje, hoe je het maar wil noemen. Waar het om gaat, is dat je jouw klanten wat extra’s kunt bieden dat de concurrent niet heeft. Daar hoef je niet perse geld voor te vragen, dat geld verdien je met wat je core business is.

Een bijeffect van die strategie is dat de prijs van juridisch advies omlaag gaat. Dat noemen we commodificatie, een term die ik al vaker heb laten vallen bij juridische dienstverlening. Goedkoop, standaard en simpel. En laat dat nou precies zijn waar computers goed in zijn. Ik ben heel benieuwd!

Arnoud

Een AI moet beter zijn dan een partner om een stagiair te vervangen #legaltechtuesday

Al een tijdje blog ik over de moeilijkheden die je ondervindt als je probeert legal tech (met name AI) naar binnen te rollen in een organisatie. De cultuur is een groot ding bij organisaties, als men niet wil veranderen of van bovenaf verandering juist afgeschrikt wordt dan gebeurt het natuurlijk niet. Maar specifiek bij AI is er nog een groot probleem, en dat is hoe er tegen de risico’s aangekeken wordt die ontstaan bij de inzet van zo’n tool. Namelijk: die AI moet perfect zijn. En dat is best raar.
AI oftewel artificial intelligence is een beetje een marketingterm, wat heet dat is púúr een marketingterm. De strekking of belofte is dat de computer denkt als een mens, wat dus nooit het geval is. Onderzeeboten kunnen niet zwemmen en een computer kan niet denken. Maar ze kunnen wel heel goed doen alsof. Ik gebruik de term dus toch maar voor alle systemen die die belofte doen. Meestal zullen ze onder de motorkap werken met machine learning of neurale netwerken, maar dat doet er eigenlijk niet toe.

Het probleem met die belofte doen is dat mensen verwachten dat hij wordt waargemaakt. En dat is lastig want een computersysteem kan geen 100% perfectie doen. Mensen ook niet, maar bij mensen weten we vaak ongeveer wat voor sóórt fouten ze gaan maken. Een stagiair (om bij de blogtitel te blijven, wat ik zelden doe) heeft basiskennis maar kan vaak niet de diepte in. Een partner weet ongeveer alles, maar berijdt wel stokpaardjes en kan traag van reactie zijn of dingen wegwuiven als triviaal die dat voor de klant niet zijn. De medewerker daar tussenin heeft het heel druk en kan doorschieten in toepassen wat hij het recentst geleerd heeft. Dat soort dingen.

Een AI maakt ook fouten, maar dan van een heel ander kaliber. Die classificeert een tekst verkeerd en klaagt dan dat de tekst “Partijen komen overeen dat” geen goede garantie over beschikbaarheid is. Of hij komt met hele rare output, omdat er ergens iets misging in de conversie (NDA Lynn kan bijvoorbeeld pdf bestanden niet altijd goed lezen). Dat is niet goed, maar omdat het zulke niet-menselijke fouten zijn terwijl de AI wel menselijk lijkt, komt dat disproportioneel raar over.

In de psychologie doet dit denken aan het fenomeen van de uncanny valley, het griezelgebied tussen robots-die-duidelijk-robots-zijn en robots-die-echt-mensen-simuleren. Onze hersenen kunnen niet goed omgaan met een robot die er heel menselijk uitziet maar zich ineens niet als mens gedraagt, dat is veel erger dan een robot-robot die dezelfde fout maakt.

Ik herinner me van lang geleden een spraakherkenning-interface met een butler. Die werkte best goed maar de fouten werden als zeer storend ervaren. Toen verving men de butler door een puppy en de subjectieve kwaliteitsbeleving schoot omhoog. Waarom? Puppies mogen fouten maken, dat is zelfs schattig. Maar een butler, dat is een domeinexpert dus die mag geen fouten maken.

Een juridische AI wordt denk ik ook op die manier benaderd. Dat is een computer, getraind in dit domein, dús een domeinexpert. Hij moet dus hetzelfde presteren als een senior partner. Fouten, zeker rare fouten ingegeven door Unicode-problemen, zijn dan onvergeeflijk.

En dat is best raar want vervolgens gaat die AI standaardwerk doen zoals NDA’s reviewen, standaardcontracten nalopen of einddatums extraheren uit een serie documenten omdat men een bedrijfsovername-DD wil doen. Dat is typisch werk waar je een stagiair op inzet en geen partner. Terecht, want het is niet heel moeilijk maar wel veel. En het soort fouten dat daarbij te maken is, is redelijk te overzien en moet geen al te grote risico’s opleveren.

Paradoxaal genoeg heeft een AI dienst dus meer kans om geadopteerd te worden in een organisatie wanneer die zich niet als een AI presenteert. Niemand heeft de verwachting dat de grammatica-checker als een mens presteert, of dat Google net zo goed als een bibliothecaris je vraag begrijpt. Dat is gewoon een interface waar een output uit komt, en daarmee kun jij weer verder. Dus misschien moet legal tech AI gewoon terug naar een knopje in good old Microsoft Word?

Arnoud

Legal tech invoeren vereist een cultuurverandering en dus leiderschap #legaltechtuesday

Is nu, tijdens deze crisis, het moment om naar legal tech over te gaan? Dat dacht ik in mijn vorige column. We werken al op een andere manier, dus waarom niet naast thuiswerken ook met nieuwe tools gaan werken? Nou ja, dat was misschien toch wat makkelijk gedacht. Want thuis versus op kantoor werken is één ding, wisselen van tooling is iets héél anders. Dan kom je echt in de sfeer van de cultuur van het bedrijf, en dat is notoir lastig te veranderen.

“Culture eats strategy for breakfast”, aldus een quote van managementconsultant Peter Drucker. Je kunt nog zo’n mooi plan hebben bedacht, maar als de strategie niet past bij de cultuur van het kantoor dan zal deze niet werken. Ja, misschien worden voor de vorm een paar elementjes opgepakt of komt er een implementatieteam dat de boel opzet en iemand voor de interne nieuwsbrief laat poseren bij het dashboard, maar daarna moet het echt vanzelf gaan.

Ergens is dat raar. Je kiest als organisatie voor een bepaalde route, juist omdat je wilt veranderen. En dan lukt dat niet omdat je niet wilt veranderen?

De kern van dit probleem zit hem in het nemen van risico’s, meer specifiek het riskeren van de omzet (of winst) zoals die nu binnenkomt. Want veranderen is leuk, maar als de omzet daardoor in dreigt te storten dan voelt het ineens een stuk minder leuk. Helemaal als je als bedrijf op zich niet slecht functioneert, zoals bij de meeste juridische kantoren het geval is. De meeste advocaten zijn heel goed in hun werk, hebben grosso modo tevreden klanten en kunnen het werk toch aardig aan.

Daar doorheen fietsen met een grote blinkende legal tech applicatie gaat gewoon niet werken. Dat zet alles op zijn kop en introduceert overal grote risico’s. Dan gaan in veel organisaties direct de hakken in het zand. Vaak heel subtiel, er zal zelden een partner opstaan en zeggen “dit gaan we niet doen” maar de tool wordt gewoon niet gebruikt. Of men laat het eerst eens proberen door een pilotgroep, waarna niemand zes maanden later vraagt hoe die het is bevallen.

Maar hoe moet het dan wel?

Verandering hoeft niet strategisch, hoeft niet enorm en hoeft niet ineens. Verandering komt er als de cultuur daar voor open staat. Vaak is dat wel het geval bij kleine dingen. Een net iets handiger tooltje om verwijzingen te checken. Een dienst die niet alleen jurisprudentie opzoekt maar het meteen als referentie in je Word document zet (én controleert of er hoger beroep was tegen de gevonden zaak). Een knop in Word die een conceptbrief afrondt en van handtekening voorziet.

Ook kan legal tech vaak snel een ingang vinden bij grote, nieuwe projecten die men nog niet vaak heeft gedaan. Dan is er nog geen culturele opvatting in de organisatie dat het op een bepaalde manier moet, dus waarom dan niet met die nieuwe tool.

Wie meer wil, moet echt aan de slag met de cultuur op kantoor. Waarom willen mensen geen documenten uit een tool halen, maar blijven ze werken met de eigen sjablonen? Dat kan zijn dat ze de tool niet vertrouwen, of omdat ze de leercurve te pittig vinden. Of – heel stom maar het komt regelmatig voor – omdat ze niet (meer) kunnen inloggen en daarna merkten dat niemand ze daarop aansprak.

En dat aanspreken, dat is uiteindelijk ook een cultuur-ding. Want als je als leiding van zo’n organisatie wil veranderen, dan moet je een cultuur van leiden hebben. Van mensen meenemen en motiveren. En als het niet anders kan, verplichten. Maar dan moet je dus zelf ook volledig achter de keuze staan en voor lief nemen dat er dan dingen (tijdelijk) minder lopen.

Een belangrijke factor daarbij is ook hoe je mensen afrekent. Als je bijvoorbeeld stuurt op omzet per maand, dan zal niemand een nieuwe tool gaan gebruiken ook al zegt het projectteam dat je er veel efficiënter mee werkt. De maanden waarin je je inwerkt, zullen minder productief zijn – daar gaat dus je omzetdoelstelling, en je bonus. Als leider moet je dat compenseren. En wanneer je zegt dat documenten uit de generator moeten komen, maar vervolgens de sectiehoofden met de hand deze gaan corrigeren, dan zullen mensen ook niet graag die generator gebruiken want dat levert extra werk op.

Om dit voor elkaar te krijgen, heb je leiderschap nodig. Iemand die durft te zeggen, dit gaan we doen en niet anders. En die daar ook achter gaat staan als het even tegenvalt, of als de collega’s klagen dat het oude systeem toch zo comfortabel was. En dat valt niet mee, zo heb ik helaas nu al een aantal keer moeten merken. Dáár zit dus de grote uitdaging voor legal tech.

Arnoud

Studentenraad klaagt UvA aan wegens gebruik surveillancesoftware

De Centrale Studentenraad van de UvA stapt naar de rechter vanwege het gebruik van het surveillanceprogramma Proctorio. Dat las ik bij Tweakers. De CSr ziet de maatregel als een te vergaande inbreuk op het privéleven van studenten, omdat die bij tentamens dan hun hele hebben en houden thuis moeten onthullen en niet-transparante software van een Amerikaanse leverancier installeren, alles op straffe van een jaar studievertraging. Met een kort geding hoopt men dit alles tegen te kunnen houden. De UvA zet daar tegenover dat er niet echt een alternatief is; je kunt niet ineens iedereen openboektentamens of vrije opdrachten geven. Dus ja, wat nu.
Al eerder blogde ik over protesten van studenten tegen tentamensoftware. Dat wordt dan altijd samengevat als “inbreuk op de privacy”, en dat roept dan weer makkelijke tegenargumenten op zoals “in de tentamenzaal mag je ook bekeken worden” of “je kunt toch een laken over je bed trekken als je niet wil dat de surveillant je matras ziet”. Ik blijf er dus bij dat het geen privacydiscussie is, maar dat het gaat over hoe je het beste afstandsonderwijs moet gaan uitvoeren.

Maar goed, hoe je onderwijs uitvoert dat is uiteindelijk een keuze van de universiteit en niet iets dat de rechter ter discussie gaat stellen. Bij de rechter moet je met formele argumenten komen, zoals dat de AVG wordt overtreden of dat het besluit tot proctoring in strijd met de regels is genomen. Helaas staat de dagvaarding niet online, zodat ik niet kan zeggen welke argumenten de Studentenraad morgen bij de zitting ter tafel gaat brengen.

Onder de AVG komt de discussie neer over de vraag of het gerechtvaardigd belang als grondslag kan dienen. Dan moet je kort gezegd privacy van studenten afwegen tegen de belangen van de universiteit, waarbij de universiteit verliest tenzij ze kan bewijzen dat haar belangen écht de doorslag moeten geven. Juristen gooien dan met de begrippen noodzakelijkheid, proportionaliteit en subsidiariteit – moet het echt, kan het niet een onsje minder en kan het niet anders. Dan kom je dus uit bij die vraag of er alternatieve tentamenmogelijkheden zijn, of de proctoring echt op het niveau van eyetracking moet zijn of dat enkel een screencapturevideo genoeg is en waarom het noodzakelijk is als je ook tentamenzalen hebt waar men toch al op twee meter afstand van elkaar zit.

(In de AVG staat bij dit artikel nog dat overheidsorganen -waaronder universiteiten vallen- geen gebruik mogen maken van deze grondslag bij de uitoefening van hun publieke taak. Ik denk dat dat hier geen probleem is; de universiteit creëert hier niet stiekem een nieuwe publieke bevoegdheid maar vult de implementatie van een bestaande taak in. Maar dit komt hopelijk bij het kort geding uitgebreid aan bod.)

Dat van die Amerikaanse leverancier vind ik nog de lastigste. Ja, Proctorio heeft ook een Duitse vestiging en er is een keurige verwerkersovereenkomst en de FAQ van de UVA spreekt duidelijke taal. Alleen: je krijgt desondanks algemene voorwaarden en een privacyverklaring ter akkoord voor je snufferd als je tentamen gaat maken. En daarin staat onder meer dat Proctorio zelf bij de data kan en dat “de-identified” kan gebruiken voor eigen doeleinden. Wat dus nogal raar is. Maar goed, ik houd moed: waarschijnlijk dacht iemand bij de implementatie dat je gebruikers akkoord moet laten gaan met een privacyverklaring (“want je moet het toch uitleggen”) en dan die van Proctorio zelf maar pakte. Dit is een vaak voorkomende fout; allereerst gá je niet akkoord met wat een voorlichtingsfolder zou moeten zijn en ten tweede behoort Proctorio in het geheel niet in beeld te zijn maar uitsluitend de universiteit zelf.

Ik denk dat ik als student minder moeite zou hebben met dat ze mijn kamer bekijken (ik stop het inderdaad wel in dozen, of leg juist een provocerend object pontificaal in beeld) dan met dat al die informatie gratis naar zo’n Amerikaanse partij met eigen definitie van “anonieme gegevens” zou gaan. Dat is niet waarvoor ik me inschreef, volgens mij.

Arnoud

Gaat Europa een Grote Firewall rond internet zetten die filtert op grondrechten?

Gaan we toe naar een afgesloten Europees internet naar het voorbeeld van de ‘Great Chinese Firewall’? Dat las ik bij Linkedin, een update van DDMA-counsel Matthias de Bruyne. Hij reageerde op een Europese studie over New Developments in Digital Services, waarin men op de korte, middellange en lange termijn. In de kern: Diensten van buiten de EU zouden alleen toegang krijgen wanneer ze laten zien dat ze aan de EU standaarden voldoen, waaronder democratische waarden, gegevensbescherming, toegankelijkheid, transparantie en gebruiksvriendelijkheid. Creatief idee, en dit is dus waarom je naar mijn Summer School moet. Maar houdt het stand?

Het Europese onderzoeksrapport – dat overigens geen juridische status heeft, er is nog niet eens een wetsvoorstel – was opgesteld om de wat langere termijn visie van de EU in kaart te kunnen brengen. Digitalisering gaat alleen maar sneller, zeker nu iedereen nog wel een paar jaar massaal op afstand blijft leven en werken. Gezondheid krijgt daarbij een forse boost, maar IoT zal ook veel aan belang toenemen.

En oh ja, de cloud gaat natuurlijk piepen en kraken want die staat in Amerika en dát land rammelt zo hard dat het niet grappig meer is. Zeker nu steeds meer wetgeving (en bijbehorende praktijk) er komt die Europese rechten en waarde bedreigt, zoals de Cloud Act alweer een tijdje geleden. Dat maakt het waard om de Europese Cloud weer eens af te stoffen. Dan zit je als afnemer niet gelijk met al die bedreigingen voor persoonsgegevens, bedrijfsgeheimen en kernwaarden van het Europese leven.

Complicatie is natuurlijk dat het perfide Pangea dan nog steeds in staat is om diensten te verkopen, met mooie praatjes en goedkopere prijzen (want ze hoeven al die regelgeving niet te implementeren). Vandaar de langetermijnvoorstellen om de levering van dergelijke diensten alleen toe te staan als de dienstverlener aan Europese basisnormen voldoet. Ik moet zeggen, ik heb me altijd afgevraagd waarom we zomaar toestaan dat buitenlandse dienstverleners over onze grondrechten heen mogen denderen. Maar het is natuurlijk wel weer érg radicaal om gewoon een Europees internetje te maken.

Ga je naar mijn Summer School, dan kun je de uitdaging oppakken om zo’n Europese cloud te ontwerpen (infrastructuur of juridisch, of allebei). Nog leuker lijkt me om het perspectief te nemen van een parlementaire enquêtecommissie die vijf jaar later terugkijkt waar het misging en hoe. Van fouten leer je, dus denk eens na wat hier allemaal mis kan gaan!

Arnoud

Hoe ga je als kantoor daadwerkelijk over naar inzet van legal tech? #legaltechtuesday

Sinds de coronacrisis begon, lees ik veel over advocatenkantoren en bedrijfsjuristen die legal tech inzetten. Het begon met massaal digitaal ondertekenen van contracten, wat natuurlijk een heel logische stap is, en nu zijn we bij Zoom-onderhandelingen en gebruik van Google Docs om samen documenten door te nemen of te reviseren. Een virus als de grote aanjager van innovatie, hoe raar wil je het hebben. Maar gaan we nu werkelijk doorpakken? Of waait dit weer over zodra een grotere maatschappelijke vrijheid weer terugkeert?

Het zetten van een elektronische handtekening waar voorheen een ‘natte’ nodig was, is een mooi voorbeeld van de voordelen van legal tech. Maar het is meteen een van de weinige echt goeie: simpel, duidelijk en met een heel precies voordeel. Daarvan kun je het zakelijk nut vrijwel uitrekenen. Een downside is er niet, afgezien van de kosten van de tooling. Maar training is nihil, wat er gebeurt kun je zien en dat het legaal is, is ook evident.

Voor verdergaande stappen, van contractgeneratoren tot het inzetten van chatbots voor intakes of wizards die adviesbrieven schrijven, ligt het vaak lang niet zo eenvoudig. En de reden daarachter is eigenlijk simpel: it’s the economy, stupid. Oftewel: het is niet duidelijk hoe je geld verdient door met zulke tools te gaan werken. En dat komt weer met name omdat organisaties ingesteld zijn om op een bepaalde manier hun diensten te leveren, en nieuwe technologie een andere manier van werken met zich meebrengt.

De partnerstructuur is bij advocatenkantoren vaak genoemd als dé reden waarom legal tech er niet zou komen: dan verdienen de partners minder aan billable hours (omdat die tools sneller zijn en er dus minder uren gewerkt wordt). Ik denk niet dat het zo simpel is. Het argument is wel een exponent van die achterliggende reden: vrezen voor minder opbrengsten van de klant is een economisch bezwaar. Of dat nu letterlijk is dat je urenstaten korter worden of dat de klant überhaupt minder wil betalen of iets anders, doet er dan minder toe.

Het algemene probleem is natuurlijk wel een hele taaie om aan te pakken. Zeker omdat het zelden expliciet op tafel wordt gelegd: sorry, deze tool gaan we niet doen want het kost ons heel veel en we zien weinig opbrengsten. Zeker bij legal tech, want “we moeten er iets mee” en dan wordt de tool uitgerold met veel fanfare (beter gezegd: een speciaal team of een champion) waarna we enige interesse mogen zien en daarna het gebruik een langzame dood sterft. Gewoon, omdat het niet nuttig genoeg voelt.

Er moet dus een externe prikkel komen om die verandering met zich mee te brengen. In de juridische sector zijn dat vaak de klanten: grote bedrijven die uurtje/factuurtje niet accepteren maar een fixed fee per klus of per jaar willen, of zelfs gewoon eisen dat er met tooling wordt gewerkt. Het lastige is alleen dat als de meerderheid van de kantoren nog niet op dat niveau is, zo’n klant toch moeilijk haar zin door kan drijven. Ergens is natuurlijk een omslagpunt maar wanneer dat wordt bereikt, is nog maar de vraag.

De zorg om de inkomsten vanwege de coronacrisis kan wel eens het omslagpunt forceren. Want veel kantoren en dienstverleners zien de inkomsten teruggaan en de productiviteit dalen. Als er dan een oplossing lijkt te zijn die met name dat laatste kan verhogen, dan is dat nu het moment om daarmee aan de slag te gaan.

Alleen: je blijft zitten met het punt dat een juridische dienstverlener behoorlijk goed is in z’n werk, en de workflow ook heeft ingericht om zo goed mogelijk op die manier te werken. Hoe je het ook wendt of keert, legal tech invoeren komt neer op veranderen van de bedrijfsvoering, en daar moet dan een duidelijke economische reden voor zijn. Waarom zou je nu, uitgerekend nu op een nieuwe manier gaan werken?

Daar staat tegenover dat we nu al op een andere manier zijn gaan werken. Vrijwel iedereen in de juridische sector werkt thuis waar dat kan, we Zoomen waar voorheen een fysiek gesprek de enige optie was en we onderhandelen op afstand zonder noemenswaardige problemen. Dat schept een mindset die openstaat voor veranderingen. Dus misschien is juist nu het moment?

Arnoud