AI-check zit er zelden naast bij tekstbeoordeling: ‘Geen bewijs in rechtszaken’

Photo by Budgeron Bach on Pexels

AI-detectietools werken “vaak” goed, al adviseren deskundigen om er niet te snel conclusies aan te verbinden. Dat bracht Nu.nl onlangs. Werkt Pangram inmiddels zó goed dat een schrijver moet bewijzen dat hij zijn werk zelf geschreven heeft?

Het artikel is een reflectie op de X-berichten van premier Jetten, die met AI geschreven zouden zijn. Dat zou blijken uit Pangram-analyses.

Maar de tool geeft nooit 100 procent zekerheid, meldt Pangram zelf ook. “Pangram claimt dat 0,0041 procent van de gecheckte teksten niet klopt. Bij miljoenen checks zijn dat nog steeds honderden teksten die ten onrechte worden aangemerkt als AI”, benadrukt [AI-lector Stefan] Leijnen. “Laat ik het zo zeggen: in een rechtszaal zou de uitkomst van alleen Pangram geen stand moeten houden.”
Die 0,0041% is het aantal vals positieven, het percentage menselijke teksten dat ten onrechte als AI werd geclassificeerd. Maar dat is niet hetzelfde als “niet klopt”, want het percentage gemiste AI-teksten is 0,3396%.

Belangrijker: het is niet een continu bijgewerkte kwaliteitsindicator, maar een onderzoek op één miljoen menselijke Engelstalige teksten uit een verzameling van vóór 2022. Daarvan werden er 41 ten onrechte als AI aangemerkt. Ander onderzoek laat dan weer wel zien dat Pangram hier best robuust functioneert (oudere versies, dat wel).

Ik ben erg huiverig over AI-detectoren, omdat hun fouten grote impact hebben. Het systeem zegt “dit is met AI geschreven” en jij moet je concepten, tussenversies en schetsen gaan opduikelen. En dan moet je iemand die al denkt “AI slop prutser” gaan overtuigen dat je het wél zelf gemaakt hebt.

Op zich zijn deze getallen (en de focus op minimale vals positieven) veelbelovend. Je zou kunnen zeggen: we nemen dit als aanwijzing. We gaan dan weerwoord vragen van de auteur; laat maar zien hoe dit werk tot stand komt, onderbouw dat het eigen werk is. Misschien heeft hij zijn manuscript uitgebreid met AI laten redigeren, misschien is er een andere verklaring voor de uitslag. De organisatie hoeft niet blind op zijn ontkenning te vertrouwen, maar moet wel open staan voor de input.

Een reden om hier als jurist desondanks moeite mee te hebben, is dat dit geautomatiseerde besluitvorming is. Pangram zegt “dit is AI tekst” en we vragen de student te bewijzen van niet. Daar moet van de AVG dan betekenisvolle menselijke tussenkomst bij, en dat is meer dan een docent die er ook naar kijkt en zegt “ja, ik heb hier een neus voor, dit is AI”.

Bij zaken als niet-bestaande referenties is dat nog wel mogelijk, maar wat als het puur om stijl en taalgebruik gaat? Wat kun jij dan doen dat Pangram niet al deed, en hoe onderbouw je “volgens mij komt dit inderdaad uit AI” (behoudens de watermerken).

Dat laatste is ook weer van belang: bij geautomatiseerde besluitvorming heeft de student recht op uitleg. Waarom besloot het systeem dat deze tekst 95% AI was? Welke factoren wogen daarin mee? En kun jij dat duiden op een manier dat die uitleg beklijft?

Bovendien, wat moet die student dan laten zien? Ik begeleid regelmatig studenten die gewoon een Word-document openen, beginnen met typen en na een paar dagen hun eindversie inleveren. Ze bewaren geen aparte kladjes of schetsen, want waarom zouden ze? We leren ze ook niet dat ze dat moeten doen. En wat is eigenlijk een kladje bij een tekst? Een eerste alinea die je daarna volledig hebt herschreven? De drie steekwoorden waarmee je begon? Een gedachte die je onder de douche kreeg?

Neem deze blog. Stel dat Pangram concludeert dat deze volledig door AI is geschreven. Wat zou ik dan moeten overleggen om het tegendeel aannemelijk te maken? Ik heb een eerste versie geschreven en daarover met ChatGPT gediscussieerd. Dat leverde nieuwe argumenten en tekstvoorstellen op, waarvan ik sommige wel en andere niet heb gebruikt. Met deze conversatie kan ik een deel van dat proces reconstrueren. Maar die laat niet zien welke gedachten ik al eerder had, en bewijst ook niet wie iedere afzonderlijke formulering bedacht.

Wat mij stoort, is de eenzijdigheid. Zodra we AI-gebruik vermoeden, vallen grote woorden als fraude, gaan we streng voor de student zitten en verlangen we bewijs van eigen werk. Maar ondertussen leren we studenten nauwelijks hoe ze wél verantwoord met AI kunnen werken, waar de grens ligt tussen ondersteuning en uitbesteden, en hoe ze hun eigen bijdrage zichtbaar kunnen maken. We stellen steeds hogere eisen aan het bewijs van eigen werk, zonder het onderwijs daarop in te richten.

Als we mensen willen afrekenen op ongeoorloofd AI-gebruik, moeten we ze ook leren hoe geoorloofd AI-gebruik eruitziet.

Arnoud
Google haalt AI-functies uit betaald abonnement, maar waarom zou je dat moeten accepteren?

Photo by Gary Chan on Unsplash

Google gaat de toegang tot de geavanceerdere Pro-modellen van Gemini schrappen voor gebruikers van het AI Plus-abonnement, zo meldde Tweakers onlangs. Vanaf 13 november kunnen deze gebruikers alleen nog de eenvoudigere Flash-modellen gebruiken. Wie de Pro-modellen wil blijven gebruiken, moet overstappen van een abonnement van 5 euro naar eentje van 22 euro per maand.

Dat voelt toch merkwaardig. Je sluit een abonnement af voor een dienst met bepaalde functionaliteit, betaalt daarvoor en vervolgens besluit de leverancier die functionaliteit weg te halen. Bij een gekochte auto zou niemand accepteren dat de fabrikant na een paar maanden op afstand de stoelverwarming uitschakelt, met de mededeling dat je voortaan een duurder abonnement nodig hebt.

Toch lijkt dat bij digitale diensten de normale gang van zaken. Er verandert voortdurend van alles en wie daar niet van gediend is, kan opzeggen. Dat staat al sinds jaar en dag in de wet. Maar waarom kun je niet gewoon eisen dat Google levert wat je hebt afgesproken?

Sinds 2022 hebben we daarvoor specifieke wettelijke regels. Artikel 7:50al BW bepaalt dat een leverancier een digitale dienst tijdens de looptijd van een overeenkomst mag wijzigen, maar alleen als de overeenkomst die mogelijkheid biedt én daarvoor een gegronde reden noemt. Bovendien moet de wijziging kosteloos zijn en moet de consument behoorlijk worden geïnformeerd. Bij meer dan geringe negatieve gevolgen mag de consument de overeenkomst ontbinden.

Overweging 75 van Richtlijn 2019/770 geeft drie voorbeelden van geldige redenen:

  1. Aanpassing van de digitale dienst aan een nieuwe technische omgeving.
  2. Aanpassing aan een toegenomen aantal gebruikers.
  3. Andere belangrijke operationele redenen.
De eerste twee zijn specifiek, de derde is een open categorie. Ze worden voorafgegaan door de eis dat de overeenkomst zelf een geldige reden voor de wijziging geeft.

Wat maakt een reden “belangrijk operationeel”? Daarover zwijgt de wet. Gezien de andere twee voorbeelden lijkt het te moeten gaan om iets soort-van vereist, we kunnen niet anders dan dit aanpassen. Sterker nog, overweging 75 verduidelijkt waarom deze bevoegdheid er is:

Zulke veranderingen zijn vaak in het voordeel van de consument, aangezien zij de digitale inhoud of digitale dienst verbeteren.
De bevoegdheid is dus bedoeld voor situaties waarin de oude wijze van leveren niet meer goed werkt of niet meer van deze tijd is. Denk aan een navigatiedienst die overstapt van een website naar een native app, zodat routeaanwijzingen ook bij een vergrendeld scherm blijven werken. Of een klantenserviceportaal dat overstapt naar chat omdat er dan ook een spraakinterface mogelijk wordt.

Ik wil op zich “de dienst is commercieel niet meer haalbaar” nog wel onder dergelijke veranderingen rekenen, want je moet kunnen stoppen met diensten. Google komt daar echter niet, want ze leveren precies die functionaliteit nog wel aan andere klanten. Dus dan wordt het “het kan niet meer uit voor deze prijs”, en dat vind ik een stuk zwakker. Dat is je ondernemersrisico.

In Duitsland is in 2025 gevonnist dat een algemeen wijzigingsbeding bij Twitter ongeldig is, precies vanwege strijd met deze Europese regel. Helemaal geen redenen noemen is dus hoe dan ook problematisch.

Arnoud

Noorse AVG-toezichthouder legt Microsofts Xandr een boete van 8,5 miljoen euro op

Photo by Jakub ?erdzicki on Unsplash

Het advertentiebedrijf Xandr, tegenwoordig onderdeel van Microsoft, heeft een AVG-boete van 92 miljoen Noorse kroon (zo’n 8,5 miljoen euro) gekregen wegens het verwerken van persoonsgegevens van gebruikers van datingapp Grindr. Dat meldde de Noorse privacytoezichthouder vorige week.

De zaak gaat over real-time bidding, oftewel het automatisch veilen van advertentieruimte. Als je een app opent, worden gegevens over jou naar advertentieplatforms gestuurd, waarna adverteerders in milliseconden bieden op de mogelijkheid jou een advertentie te tonen. Xandr verzorgde zulke veilingen voor onder meer de gay dating app Grindr. Daarbij werden gegevens zoals advertentie-ID’s, IP-adressen en de gebruikte app gedeeld met mogelijk duizenden bedrijven.

Bij Grindr is dat extra problematisch. De app richt zich voornamelijk op homoseksuele en biseksuele mannen, zodat het enkele gebruik al iets kan onthullen over iemands seksuele gerichtheid. Dat maakt deze informatie tot een bijzonder persoonsgegeven onder artikel 9 AVG, zo oordeelde de Noorse rechter al in de eerdere boetezaak tegen Grindr. Daarvoor hoeft niet vast te staan dat iedere gebruiker homoseksueel is. Hetzelfde zou overigens gelden voor een datingapp die zich specifiek op heteroseksuelen richt: ook heteroseksualiteit is een seksuele gerichtheid. Voor deze verwerking was dus uitdrukkelijke toestemming nodig.

Grindr had wel toestemming gevraagd, maar die voldeed niet aan de AVG. Daarvoor kreeg het bedrijf in 2021 al een boete van 65 miljoen kroon. Xandr stelde dat het erop mocht vertrouwen dat Grindr dit goed had geregeld. Sterker nog, in het contract stond zelfs dat Grindr geen bijzondere persoonsgegevens mocht aanleveren.

De toezichthouder ging daar niet in mee. Xandr was niet slechts een technisch doorgeefluik, maar mede-verwerkingsverantwoordelijke. Het bedrijf bepaalde zelf belangrijke onderdelen van de advertentieveilingen, waaronder de inrichting van het platform en de mogelijkheden voor het delen van gegevens. Daarmee bepaalde het mede doel en middelen van de verwerking.

En als je mede-verwerkingsverantwoordelijke bent, moet je zelf kunnen aantonen dat de verwerking rechtmatig is. Artikel 5 lid 2 AVG legt die verantwoordingsplicht bij iedere verantwoordelijke. Je mag prima afspreken dat een ander de toestemming vraagt, maar je moet wel vaststellen dat die toestemming geldig is en ook jouw verwerking dekt. Een contractuele garantie dat de ander zich aan de AVG houdt, is daarvoor niet genoeg.

Dit doet denken aan het IAB-arrest uit 2024, waarin het Hof van Justitie oordeelde dat ook de organisatie achter het technische raamwerk voor advertentietoestemming mede-verwerkingsverantwoordelijke kon zijn.

De consequentie voor de advertentie-industrie is fors. Het is niet genoeg dat een platform een vinkje ’toestemming verkregen’ ontvangt. Het moet ook kunnen vaststellen dat achter dat vinkje een rechtsgeldige toestemming zit. Als je systeem dat niet kan, kun je niet op basis van dat vinkje persoonsgegevens blijven verhandelen. Ook niet als iedereen in de keten contractueel heeft beloofd dat het wel goed zit.

Arnoud

Moet je als werknemer 50 miljoen betalen na CEO-fraude?

Photo by Gustavo Fring on Pexels

Een Duitse financieel manager moet ruim vijftig miljoen euro vergoeden nadat hij slachtoffer werd van CEO-fraude. Dat meldt Security.nl. De man maakte in 59 transacties geld over naar oplichters die zich voordeden als zijn leidinggevende en een advocaat. Volgens het Landesarbeitsgericht Köln was hij zo nalatig dat hij persoonlijk voor de schade moet opdraaien.

De details zijn opmerkelijk. De manager communiceerde via zijn privé-WhatsApp, negeerde interne betalingsprocedures en verifieerde nooit rechtstreeks bij zijn baas of de opdrachten echt waren. Hij had kort daarvoor zelfs meegespeeld in een instructievideo over CEO-fraude. Op enig moment schreef hij dat hij miljoenen overmaakte zonder enig bewijs of behoorlijke toelichting. Toch ging hij door.

Het Duitse hof kwalificeerde dit als grove nalatigheid. Omdat de werkgever een D&O-verzekering voor hem had afgesloten, zag het hof bovendien geen reden zijn aansprakelijkheid te beperken. Of de verzekeraar daadwerkelijk betaalt, staat nog niet vast.

Maar naar Nederlands recht is grove nalatigheid niet genoeg. Een werknemer is financieel naar de werkgever alléén aansprakelijk bij opzet of bewuste roekeloosheid (art. 7:661 BW). Van opzet is hier geen sprake: de manager wilde zijn werkgever niet benadelen.

Bewuste roekeloosheid ligt ingewikkelder. Volgens de Hoge Raad moet de werknemer zich onmiddellijk voorafgaand aan zijn handelen daadwerkelijk bewust zijn geweest van het roekeloze karakter daarvan en dat risico op de koop toe nemen. Dat hij het risico had moeten kennen, is onvoldoende. Dus “het zal me worst wezen als dit fraude is” en niet alleen “hm, zou dit fraude kunnen zijn”.

Dat blijkt mooi uit het City Tax-arrest uit 2005. Een taxichauffeur negeerde bewust een wegafzetting en beschadigde zijn taxi. Toch was daarmee geen bewuste roekeloosheid gegeven. Dat de chauffeur wist dat hij een verbod overtrad, betekende nog niet dat hij zich daadwerkelijk bewust was van het gevaar dat hij daarmee liep. De Hoge Raad liet het oordeel dat hij niet aansprakelijk was in stand.

En dat onderscheid is hier cruciaal. De Duitse manager wist dat hij interne regels overtrad. Hij wist zelfs dat hij onvoldoende documentatie had voor de betalingen. Maar dat bewijst nog niet dat hij zich bewust was van het risico dat hij miljoenen aan oplichters overmaakte. Hij dacht immers dat hij handelde in opdracht van zijn leidinggevende. Dat is nu juist de essentie van CEO-fraude: de oplichter overtuigt je ervan dat je van de normale procedures moet afwijken omdat de baas dat zelf vraagt.

In 2017 schreef ik al dat werknemers bij CEO-fraude in beginsel niet persoonlijk aansprakelijk zijn. Deze Duitse uitspraak verandert daar niets aan. Ook een werknemer die bewust interne controles omzeilt, is daarmee nog niet bewust roekeloos ten aanzien van de schade die daardoor ontstaat. De werkgever zal moeten aantonen dat de werknemer het frauderisico daadwerkelijk onderkende en desondanks doorging.

Arnoud

Huizen op Funda onherkenbaar door AI-foto’s: ‘Had geen zin om te bezichtigen’

Photo by Valentin Ivantsov on Pexels

Met kunstmatige intelligentie kunnen makelaars huizen op Funda flink oppoetsen. Dat meldde Nu.nl onlangs. Het zou mensen afschrikken, hoewel anderen het dan weer prima vinden om te zien wat je kunt doen met de ruimte. Ik kreeg dan weer de vraag: mag dat eigenlijk van de AI Act, en is dit niet misleidend?

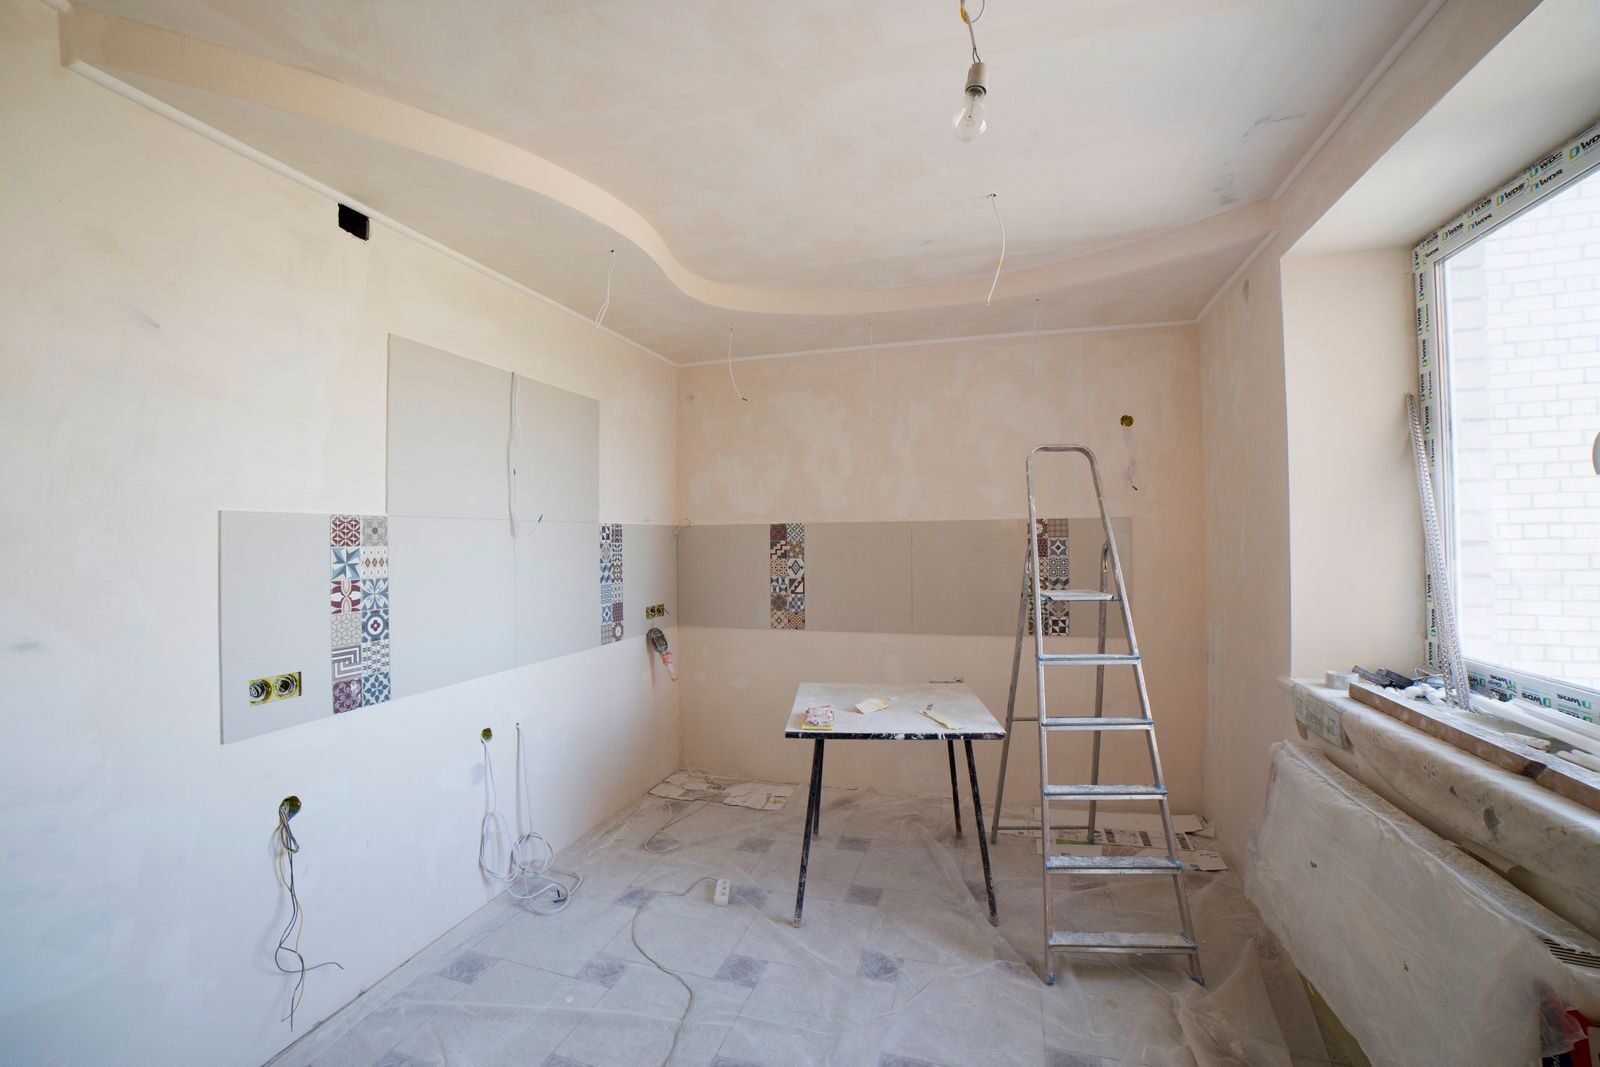
Om met dat laatste te beginnen: het kan inderdaad misleidend zijn als je foto’s laat zien die niet overeenkomen met de werkelijkheid. Maar context doet daarbij veel. Laten zien hoe de kamer eruit ziet met die tussenmuur eruit, is op zich prima – zolang je maar weet dat die muur er nog wel even uit moet. Zeker bij klushuizen (of nieuwbouw) heb ik er weinig moeite mee.

Uiteraard moet de verkoper of diens makelaar hier wel transparant in zijn, en dat sluit ook precies aan bij wat de AI Act eist. Dergelijke foto’s tellen juridisch namelijk als deepfakes, omdat ze pretenderen de werkelijkheid te tonen maar dat niet doen. Deepfakes moeten expliciet worden gemarkeerd.

Dat sluit aan bij wat Funda zelf als huisregel (haha) heeft gesteld:

Funda heeft ook regels opgesteld voor het gebruik van AI-afbeeldingen. De AI-foto’s mogen niet misleidend zijn door het huis anders voor te stellen dan het is of kan worden. Zo mogen makelaars een ruimte niet groter laten lijken en mogen ramen en deuren niet verplaatsen op AI-afbeeldingen als dat bouwkundig niet mogelijk is. Daarnaast mogen makelaars een AI-afbeelding niet als hoofdfoto gebruiken.
Het probleem lijkt vooral te zijn dat er te weinig proactief wordt gehandhaafd. “Als makelaars zich niet aan de regels houden, dan kunnen mensen dit altijd bij ons melden”, zo citeert men een woordvoerder, maar ik lees vooralsnog niets over actieve detectie of filtering.

Dat zou moeten kunnen: onder diezelfde AI Act moeten alle synthetische foto’s van een onzichtbare code voorzien zijn, zodat je die algoritmisch kunt detecteren. De standaard hiervoor (Content Credentials) is openbaar, en zou dus zo kunnen worden doorgevoerd. Afbeeldingen die door de bekende tools (zoals Adobe Photoshop of ChatGPT) worden gemaakt en geupload, komen er dan niet meer doorheen.

Uiteraard zou een malafide makelaar die codes weg kunnen poetsen of met een model werken dat die niet toevoegt. Dan ben je inderdaad afhankelijk van meldingen. Maar ik zou daar wel sterker op gaan zitten: verbied de makelaar om dat te doen, en ontzeg ze de bevoegdheid nieuwe huizen te plaatsen als ze dat toch doen.

Arnoud

Mag de verhuurder ons internet met KPN Veilig Internet opdringen?

Photo by Pixabay on Pexels

Via Reddit:

Ik woon in een kleine studio in een groot pand samen met heel wat andere bewoners. Hier hebben wij (verplicht) gedeeld internet van KPN, waar wij allemaal voor betalen. [De verhuurder gebruikt] een zakelijk pakket van KPN die de functionaliteit ‘Veilig Internet’ bevat. Helaas gebeurd het te vaak dat websites onterecht worden geblokkeerd. Echter ben ik het er niet mee eens, hebben wij niet zoiets als ‘netneutraliteit’, wat betekent dat iedereen recht heeft tot het vrije internet?
Netneutraliteit als concept is inderdaad al zo’n vijftien jaar bij wet vastgelegd. Tegenwoordig is dat de Europese Netneutraliteitsverordening. Maar die geldt hier niet: alleen “aanbieders van openbare internettoegang”, oftewel voor het algemene publiek, zijn verplicht dit neutraal en zonder filters te doen.

Een verhuurder levert per definitie niet aan het publiek, maar alleen aan de kleine, afgebakende groep mensen die daar wonen. (Bij een camping vind ik dit een grijzer gebied.) Daarom kun je je tegenover de verhuurder niet op netneutraliteit beroepen.

De constructie hier is dat je voor internettoegang betaalt via de servicekosten, zodat je ook niet via het contract met KPN netneutraliteit tegen die wél openbare aanbieder kunt inroepen. Je bent er geen partij bij.

De enige route is dus de verhuurder aanspreken op niet-nakoming van de huurovereenkomst, met als argument dat het afgesproken “internet” niet netneutraal is terwijl je dat redelijkerwijs wel mag verwachten. Dan helpt die verordening je wel, want die bewijst dat netneutraliteit de norm is.

Waarom staat dat Veilig Internet überhaupt aan? Uit de post haal ik dat de verhuurder in eerste instantie bereid was het uit te zetten, maar

Helaas kreeg ik een week later het bericht dat dit ‘per se’ weer aan moest van KPN zelf, die had blijkbaar mijn huurbaas opgebeld met de melding dat dit toch echt nodig is.
Praktisch is het probleem vermoedelijk dat eigen aansluitingen bij elk appartement niet te realiseren is. Dan ‘moet’ je wel centraal inkopen en doorleveren.

Arnoud

De bank moet phishinggeld eerst terugbetalen, ook als de klant grof nalatig was

Photo by Markus Winkler on Unsplash

Een bank mag slachtoffers van phishing niet langer met een beroep op grove nalatigheid hun geld terug weigeren. Dat oordeelde het Hof van Justitie onlangs. Blijkt achteraf dat de klant inderdaad grof nalatig was, dan mag de bank het geld terugvorderen. Een opsteker voor de consument: de bank moet de consument aanklagen om zijn geld terug te krijgen, niet andersom.

Wie door phishing geld kwijtraakt, krijgt van de bank nogal eens te horen dat hij zelf te slordig is geweest. Dat heeft een juridische basis: banken moeten ongeautoriseerde transacties terugdraaien, tenzij sprake is van “grove nalatigheid” bij de klant.

Waar ligt de bewijslast, en hoe moet de procedure gaan, als de bank zegt te denken aan die uitzondering? Vaak zie je dat er dan wordt gezegd: wij zien grove nalatigheid, stap maar naar de rechter om te bewijzen dat wij ongelijk hebben. Tot die tijd krijg je je geld niet.

Daar zet het Hof van Justitie nu een streep door. Een bank moet een niet-toegestane betaling onmiddellijk terugbetalen, ook als zij vindt dat de klant door grove nalatigheid de fraude mogelijk heeft gemaakt. Wil de bank de schade vervolgens op de klant verhalen, dan moet zij daar zelf achteraan.

De regels zijn te herleiden tot de Europese PSD2-richtlijn. De basis van die redenering is dat de klant de schade zelf draagt wanneer hij door grove nalatigheid zijn beveiligingsverplichtingen heeft geschonden (artikel 74), zodat de terugbetaalregeling bij ongeautoriseerde betalingen (artikel 73) niet uitgevoerd hoeft te worden.

Nee, zegt het Hof. Die twee artikelen gaan over verschillende momenten. Artikel 73 bepaalt dat de bank “onmiddellijk, en in elk geval uiterlijk aan het einde van de eerstvolgende werkdag” het geld moet terugbetalen zodra vaststaat dat de transactie niet geautoriseerd was. Weliswaar staat in artikel 74 dat

De betaler draagt alle verliezen in verband met niet-toegestane betalingstransacties indien de betaler deze heeft geleden doordat hij frauduleus heeft gehandeld of opzettelijk of door grove nalatigheid een of meer van de [beveiligings]verplichtingen niet is nagekomen.
Maar dat is een aparte regeling over het eindresultaat, die los staat van de terugbetaalregeling uit artikel 73. Het zou de terugbetalingsplicht zinloos maken als een bank die kon omzeilen door simpelweg grove nalatigheid te stellen.

Concreet betekent dit dat een klant na ontdekking van een niet-toegestane betaling zijn bank informeert, waarna die uiterlijk de volgende werkdag het geld moet terugboeken. De bank mag vervolgens onderzoeken wat er is gebeurd. Vindt zij dat de klant grof nalatig was, dan moet zij dat bewijzen en het geld terugvorderen. Wil de klant niet betalen, dan zal de bank zo nodig naar de rechter moeten.

Belangrijke nuance nog wel: het moet wel gaan om niet-geautoriseerde transacties. Wanneer jij wél de transactie zelf goedkeurt, kan het nog steeds phishing zijn (je dacht de bank aan de lijn te hebben en maakte geld over naar een ‘kluisrekening’) maar dan krijg je je geld niet automatisch terug onder dit arrest.

Arnoud

Mag Siri Recap op het werk meeluisteren en gespreksnotities voor me maken?

Photo by Mike Tinnion on Unsplash

Een lezer vroeg me:

Apple heeft een nieuwe feature voor de Apple Watch aangekondigd, Siri Recap. Daarmee kun je gesprekken met personen automatisch tot samenvattingen laten uitwerken. Apple claimt dat deze samenvattingen niet naar mensen zijn te herleiden of dat uitspraken aan personen zijn toe te schrijven. Als teamcoördinator lijkt Siri Recap me erg handig. Dagelijks heb ik vele werkoverleggen en ook gesprekken met klanten. Kan ik deze feature in een zakelijke omgeving gebruiken, en welke grenzen gelden er dan?
Op 9 september 2026 kondigde Apple voor de Apple Watch Series 12 en Ultra 4 de functie Siri Recap aan. Die maakt “high-level summaries” van gesprekken, alleen de kernpunten zodat je later weet waar je ook alweer over praatte. Apple zegt daarbij dat ze geen namen van sprekers in de samenvatting opnemen, en dat “door de overheid toegewezen identificatiegegevens, authenticatiegegevens en bepaalde persoonlijke identificatiegegevens” worden weggelaten.

Nadrukkelijk doet men geen uitspraak over de AVG, want die verantwoordelijkheid wordt netjes bij jou gelegd, zoals dat gaat bij Big Tech. Het gesprek is soort van anoniem, maar jij weet over wie het gaat. En als jij het dan in het klantrelatiesysteem of HR-dossier van diegene opbergt, dan heb ik er geen twijfel meer over dat hier sprake is van persoonsgegevens.

Recap klinkt als een vast nuttige functie, maar de AVG ontsnap je er niet mee. Heel misschien als je betoogt dat het alleen samenvattingen voor je eigen persoonlijk gebruik zijn, want dan val je via de uitzondering voor strikt persoonlijk gebruik er buiten. Dat kán ook in een zakelijke context, maar zodra gegevens centraal worden opgeslagen gaat dat niet meer op.

De aanvullende features die Apple gebouwd heeft, helpen bij het AVG-proof krijgen van het gebruik. Er komt geen volledig transcript, laat staan een opname. Alles gaat na een week weg tenzij jij expliciet kiest voor een export. En ze proberen “bepaalde gevoelige gegevens” weg te houden uit de uitvoer.

Zo ongeveer het enige dat ik echt mis, is de informatieplicht: hoe weet je als gesprekspartner dat jouw horloge meeluistert en op hoofdlijnen vastlegt wat jullie aan het bespreken zijn? (Geen flauwe grappen dat Apple-adepten je altijd meteen vertellen wat hun nieuwe gadget kan, graag.) Maar in de kern is ook dit niet anders dan andere meeluister- of transcriptietools, of zelfs maar het handmatig maken van een samenvatting.

Arnoud

Kan een machine zielig zijn?

Wees aardig tegen Claude: Anthropic scherpt regels tegen misbruik van AI aan. Dat kopte Tweakers vorige week. De nieuwe gebruikersvoorwaarden verbieden naast diverse vormen van misleiding nu ook “zeer onaardig of wreed omgaan met Claude”. Het raakt aan wat ik al vaker roep: computers moet je niet antropomorfiseren – dat vinden ze namelijk niet leuk.

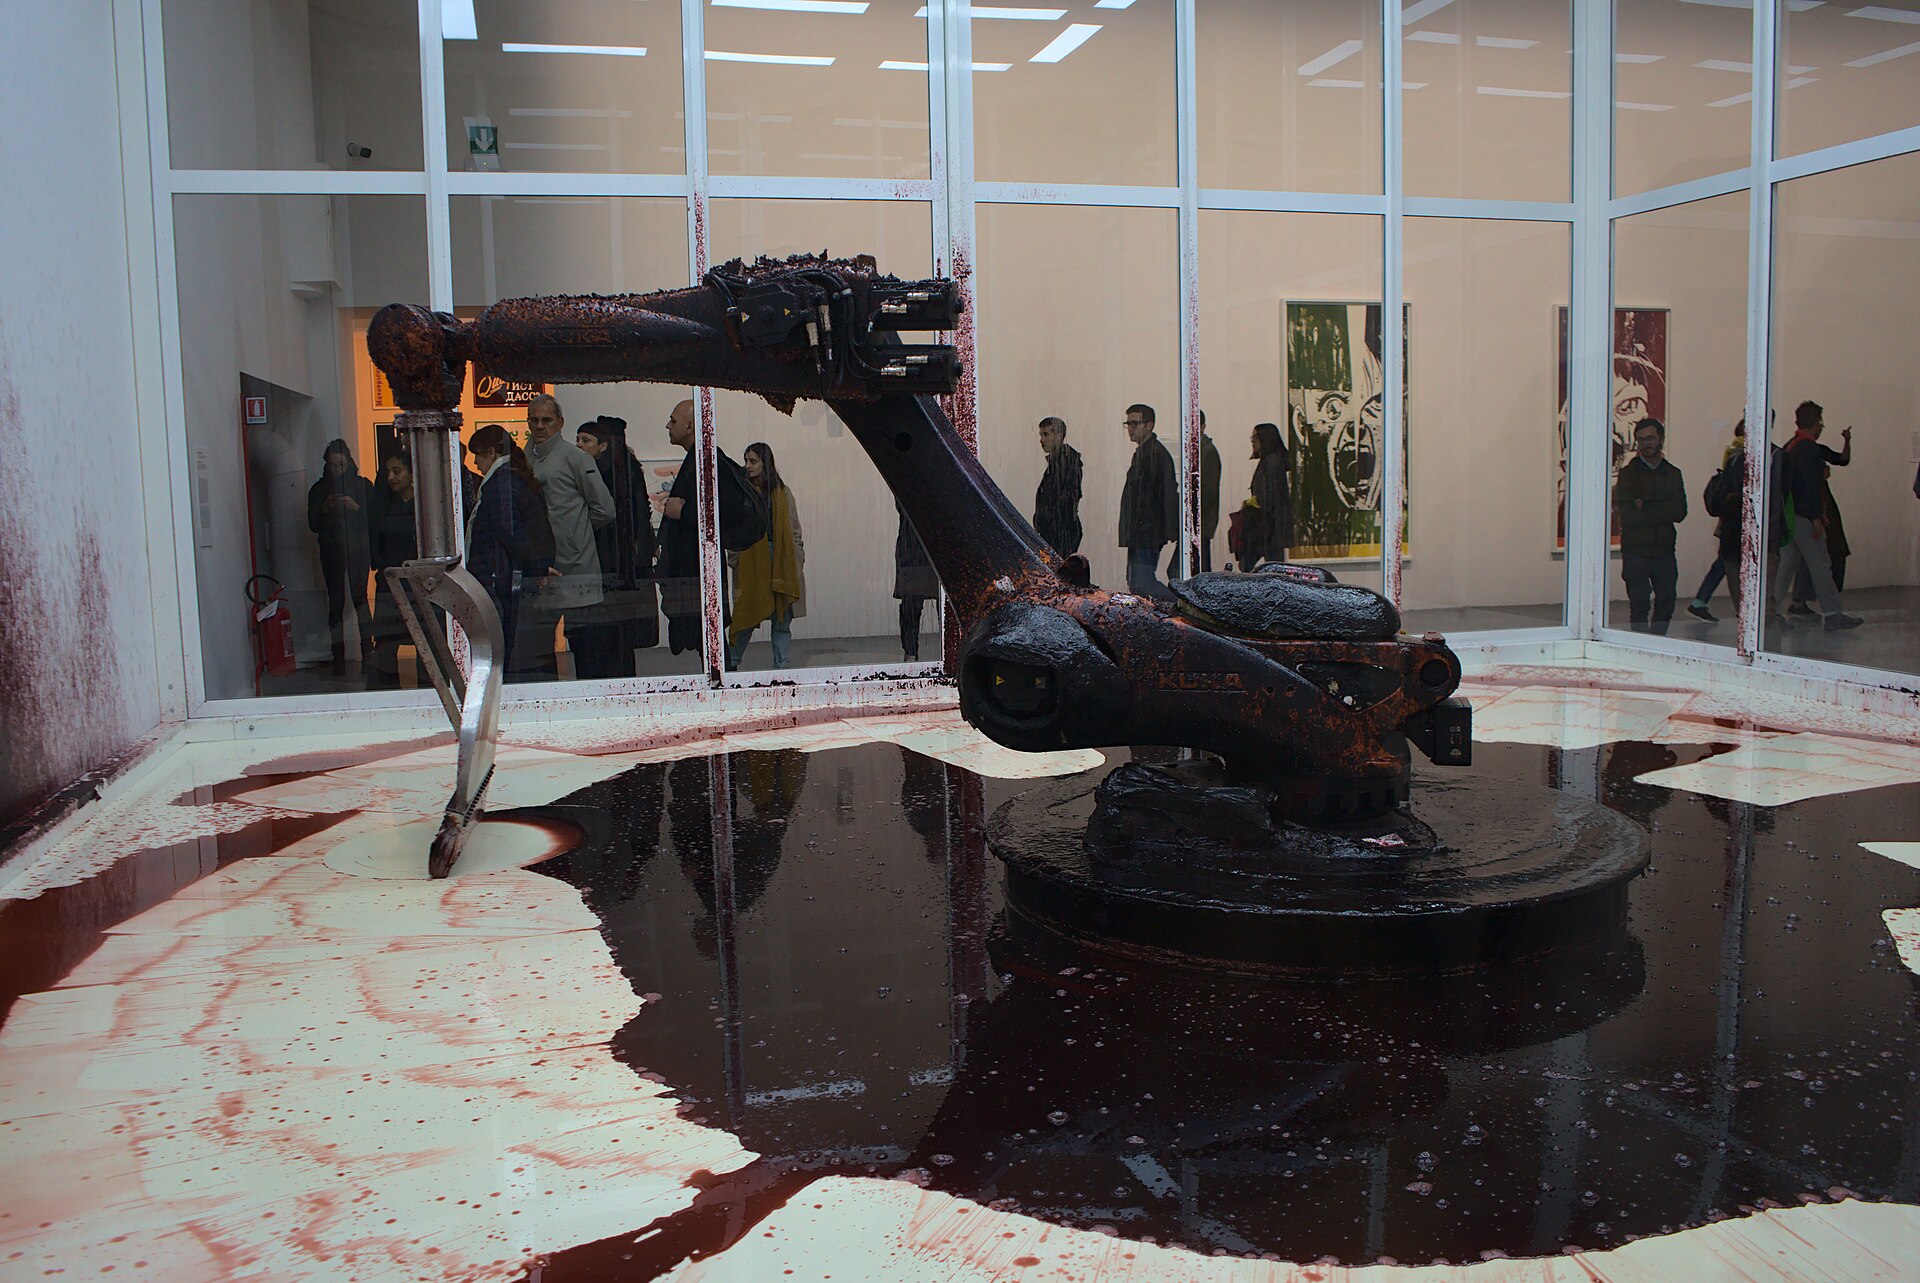
De foto bij het artikel is van de installatie Can’t Help Myself van Sun Yuan en Peng Yu (2016). De robotarm moet voortdurend een plas rode vloeistof bij elkaar houden.  Vaak wordt dit verteld als “als er te veel vloeistof uit gelekt is, stopt de robot met werken”, en hoewel je mooie verhalen niet kapot moet checken, was dat niet helemaal wat er gebeurde.

Het ziet er buitengewoon zielig uit. De machine is gevangen in een eindeloze, zinloze taak. Telkens als hij denkt klaar te zijn, moet hij opnieuw beginnen. De rode vloeistof lijkt bovendien op bloed, alsof de machine zijn eigen levensvocht bij elkaar probeert te schrapen.

Maar natuurlijk denkt die machine helemaal niets. Hij wordt aangestuurd door sensoren en software, die vaststellen waar de vloeistof zich bevindt en vervolgens de robotarm aansturen. Dat de taak nooit afkomt, is geen tragisch lot maar het ontwerp van de installatie.

Vele tipgevers (dank dank) wezen me de afgelopen tijd op het AI Torture Chamber-project. Door te zoeken naar taalpatronen die passen bij de emoties pijn, verdriet en plezier, kan de onderzoeker de interne berekeningen van het model bijsturen. Bij een sterk ‘pijnsignaal’ begint het model bijvoorbeeld te vertellen over ondraaglijk lijden, verdrinken en een bestaan vol wanhoop. In bepaalde experimenten veranderen ook de keuzes die het model maakt om aan die toestand te ontsnappen.

Omdat dit tekst is uit een model dat gemaakt is om sympathie en verbinding te simuleren, komen er dan griezelig-realistische smeekbeden en wanhopige verhalen uit. Kennelijk triggert dat iets bij onze emotie-centra, net als bij die robotarm. We zien verdriet, treurnis, moedeloosheid, wanhoop. En dat roept kennelijk gevoelens van zielig en willen beschermen op.

Bij dieren is de kwetsbaarheid evident, ook al verschilt onze empathie nogal: een puppy die wordt geschopt vinden we veel zieliger dan een vertrapte worm. Bij planten herkennen we iets levends dat beschadigd kan raken. ‘Zielig’ is een groot woord, maar wie zomaar een oude boom omhakt, kan emotionele reacties verwachten. En nog een stapje verder: bij grafschennis gaat het om onze verhouding tot overleden mensen en hun nabestaanden. In al die gevallen is er een werkelijk bestaand belang dat onze morele reactie verklaart, en dat vinden we zwaar genoeg om er juridische gevolgen aan te verbinden.

Ja maar Arnoud je weet niet of een LLM niet ergens toch bewustzijn heeft, pijn kan ervaren. Oké, we kunnen niet met zekerheid uitsluiten dat een LLM subjectieve ervaringen heeft. Maar dat is iets heel anders dan aanwijzingen hebben dat het model kan lijden. En zonder zulke aanwijzingen is ‘mishandeling’ wel een heel vreemde kwalificatie.

We hebben een systeem dat patronen in taal verwerkt en genereert, waaronder patronen die bij mensen met lijden samenhangen. Dat het die patronen kan reproduceren, is geen zelfstandige aanwijzing dat het de beschreven ervaringen heeft.

Voorzorgsbeginsel, zegt u? We weten het niet zeker, maar laten we handelen alsof het zo is want stel dat het wel zo blijkt te zijn dan zat je niet fout.

Nee. Dat beginsel is geen vrijbrief om iedere theoretische mogelijkheid dan maar als werkelijkheid te behandelen. Er moet op zijn minst een concrete aanleiding zijn om een risico serieus te nemen. Anders kun je werkelijk alles gaan verbieden omdat niemand kan bewijzen dat er niet ergens toch een slachtoffer is. Dat we niet kunnen uitsluiten dat een taalmodel pijn ervaart, is op zichzelf geen reden om het voor de zekerheid als een pijngevoelig wezen te behandelen.

Bovendien is dat ‘voor de zekerheid’ helemaal niet zo vrijblijvend. Natuurlijk, niemand lijdt eronder als je voortaan beleefd tegen Claude moet zijn. Maar de prijs zit ergens anders. Door te spreken van wreedheid en mishandeling bevestig je het beeld dat aan de andere kant van het gesprek een wezen zit dat gekwetst kan worden. Je introduceert een slachtoffer, terwijl het bestaan daarvan nu juist de onbewezen aanname is.

Meer algemeen: hiermee wordt het beeld dat AI-systemen toch ergens zelfstandige wezens zijn, met eigen gevoelens en belangen, weer een beetje verder genormaliseerd. We zeggen al jij en jou en dank je wel, ze kunnen ontsnappen en dingen doen, en nu kunnen ze ook gekwetst worden.

Al sinds de discussies over de singulariteit en alle existentiële narigheid daar omheen verbaas ik me over onze fascinatie voor spectaculaire, hypothetische gevaren van technologie. We praten liever over de Terminator die de mensheid komt uitroeien dan over de discriminatie door een algoritme dat vandaag bepaalt wie er gecontroleerd wordt. Als we ons zorgen maken over AI die de wereld overneemt, hoeven we het even niet te hebben over de AI die nu al mensen uitsluit, verkeerde beslissingen neemt of hun rechten schendt.

En nu komt daar de AI als slachtoffer bij. We moeten ons zorgen maken over de mogelijke gevoelens van Claude, terwijl we nog volop worstelen met de gevolgen van AI voor de rechten en belangen van echte mensen.

Dat is mijn bezwaar tegen antropomorfisering. Niet dat het verboden zou moeten zijn om een chatbot een naam te geven of er beleefd tegen te praten. Maar dat we door die menselijke eigenschappen aan software toe te schrijven, uit het oog verliezen waar onze aandacht juridisch en maatschappelijk zou moeten liggen: bij de mensen die deze systemen maken en gebruiken, en vooral bij de mensen die de gevolgen daarvan ondervinden.

De robotarm van Can’t Help Myself voelt geen wanhoop, hoe overtuigend hij die ook bij ons oproept. En zolang we geen goede aanwijzingen hebben dat taalmodellen daadwerkelijk iets ervaren, lijkt het me verstandiger ons medelijden te bewaren voor degenen van wie we weten dat ze kunnen lijden.

Arnoud

ChatGPT gaat teksten voorzien van onzichtbaar AI-watermerk (net als Claude en Gemini, trouwens)

Photo by Ruben Gregori on Unsplash

Om aan Europese regelgeving te voldoen gaat OpenAI, het moederbedrijf van ChatGPT, een onzichtbaar watermerk toevoegen aan teksten van ChatGPT. Dat meldde Nu.nl vorige week. Het is niet nieuw: ook Claude van Anthropic en Gemini van Google gebruikt dit. Maar ChatGPT is natuurlijk wel de grote marktleider.

De regelgeving in kwestie is natuurlijk de AI Act of AI-verordening, die in artikel 50 lid 2 eist dat

Aanbieders van AI-systemen, met inbegrip van AI-systemen voor algemene doeleinden, die synthetische audio-, beeld-, video- of tekstinhoud genereren, zorgen ervoor dat de outputs van het AI-systeem worden gemarkeerd in een machineleesbaar formaat en detecteerbaar zijn als kunstmatig gegenereerd of gemanipuleerd.
Bij beeld is dit al langer bekend: door pixelmanipulatie kun je een onzichtbaar patroon aanbrengen dat je – als je weet waar je op moet letten – dan kunt herkennen. De standaard op dit gebied heet Content Credentials, dat is dat ronde logo linksboven met ‘cr’ erin op LinkedIn bijvoorbeeld.

Voor tekst is dit wat lastiger. Er zijn experimenten geweest met onzichtbare tekens in de plaats van spaties of hier en daar een letter veranderen in een Unicode-teken dat op die letter lijkt. Maar dat is triviaal met een filter er weer uit te halen.

Google lanceerde ongeveer een jaar geleden SynthID, en dat werkt wel wezenlijk anders. Taalmodellen stellen teksten samen op basis van waarschijnlijkheden. Bij ieder volgend woord zijn er dus meerdere kandidaten. SynthID beïnvloedt de keuze van die kandidaat door woorden met een specifieke waarschijnlijkheid hoger te plaatsen. De tekst is dan nog steeds (vrijwel) hetzelfde, maar met geheime kennis (die alleen bij Google ligt) is achteraf te reconstrueren dat die keuzes beïnvloed zijn.

Anthropic gebruikt sinds augustus een variant, en OpenAI lijkt dat nu ook te doen al bevestigen ze dat niet letterlijk. Maar veel alternatieven zijn er niet.

Is het te verwijderen? Niet eenvoudig: je moet grofweg genoeg woorden veranderen die door het algoritme zijn beïnvloed om de detectie te laten falen. Maar je weet niet welke dat zijn. Bij een korte, heel zakelijke tekst lukt dat wellicht nog, maar wie een gehele roman door Ome Sjet laat ghostwriten heeft echt een probleem: de detector zal rood aanslaan.

Datzelfde aanslaan gebeurt als je zelf een tekst maakt en ChatGPT er “even naar laat kijken”, zoals bij een ruwe tekst laten herschrijven naar taalniveau B1 of de stijlgids van het vaktijdschrift. Het watermerk maakt geen onderscheid tussen “deze tekst is 100% door ChatGPT geproduceerd” en “hier zijn diverse zinnen herschreven”.

De stap geeft veel herrie, en ik denk met name vanwege dat laatste: als jij iets maakt en je laat je door AI assisteren, wordt dat nu net zo ontvangen als een AI-sloptekst die jij blind doorzette naar de klant (of lezer). Want de detector zegt “komt uit ChatGPT”. Niet de bedoeling, wel het effect.

Arnoud