Als je een film maakt van een Creative Commons creepypasta, is die film dat dan ook?

Photo by magwood_photography on Pixabay

Filmstudio A24 werkt samen met Spooky Pictures en Image Nation Studios om de SCP Foundation, een van de grootste door fans gecreëerde horror- en sciencefictionuniversums op het internet, voor het eerst naar het grote scherm te brengen. Aldus een persbericht. Maar die Foundation heeft hier niets mee te maken, en de teksten daar zijn Creative Commons. Wat betekent dat?

Even wat achtergrond. SCP Foundation is een grootschalig collaboratief project rondom het specifieke horrorthema van “enorme geheime organisatie onderzoekt akelige fenomenen en houdt uitbraken in toom”. (SCP staat dan ook voor Special Containment Procedures.) Er is geen centraal beheer van het plot, universum of franchise: schrijf wat jij leuk vindt en kijk of het aanslaat. Maar alles is wel Creative Commons-Naamsvermelding-Gelijkdelen.

In juli kwamen filmstudio’s Spooky Pictures en Image Nation  met het concept “V/H/S: SCP”, zes korte(re) films met als thema “gevonden archiefbeeld van SCP operaties”. Binnen de horror een klassiek thema, en het past goed bij de sfeer rond SCP.

De controverse begon toen A24 als producer mee ging doen. A24 is bekend van de cultfilm Backrooms. Ook dat was gebaseerd op internetcontent. Maar nadat A24 de film had uitgebracht, ging men auteursrechtclaims (takedowns) maken op variaties op de originele content, waar velen niet blij mee waren. Logisch: een film maken van een breed communityproject maakt je geen eigenaar van alles uit dat project.

Het helpt dan niet als A24 vervolgens naar buiten treedt en zegt dat het “[is] holding worldwide rights”. Al snel kwam de terugkrabbel: “[A24 is] not asserting any right to prevent others from creating their own SCP-based works” en je moet de film zien als een eerbetoon.

De SCP stichting (de beheerders van het project, niet de geheime organisatie) deed ook een duit in het zakje:

[W]we have not had any communication with the filmmakers, producers, or distributors for this project, despite our best efforts, and to the best of our knowledge they have not made any efforts to contact us.
Om vervolgens fijntjes te wijzen op die Creative Commons licentie, die weliswaar verfilmen toestaat maar wel eist dat die film dan óók Creative Commons wordt. En niet van DRM mag worden voorzien. Klinkt boos, maar ja – A24 gaat een eerbetoon maken zonder het onderwerp daarvan zelfs maar te vragen wat ze ervan vindt?

De kans is klein dat A24 de film werkelijk als Creative Commons uit gaat brengen; dat saboteert ongeveer alle traditionele inkomstenkanalen voor films.

Dan wordt de vraag wie de auteur(s) van de concrete gebruikte verhalen zijn, en of die bereid zijn een rechtszaak te beginnen. (De stichting kan dat niet, want die laten zich niet de auteursrechten overdragen van verhalen op de site.) In Amerika kan dat op no-cure-no-pay, en anders kan de stichting vast een fundraiser organiseren om te helpen. Maar de procedure kan jaren duren, met als mogelijke uitkomst dat A24 de film in de ijskast steekt.

Arnoud
Voormalig vrijwilligster moet beheerdersrechten Facebookpagina overdragen

Photo by Schluesseldienst on Pixabay

De voorzieningenrechter oordeelt dat een voormalig vrijwilligster de beheerdersrechten van een Facebookpagina aan de eisende organisatie moet overdragen. Dat meldde IT en Recht onlangs. Het is problematiek die regelmatig langskomt, en soms lastige juridische vragen kan geven. Wat ís een Facebookpagina eigenlijk, en welke plichten heb je als vrijwilliger?

Om maar met die eerste vraag te beginnen: een Facebookpagina is als zodanig niets, ik noem het vaak gestolde dienstverlening. Want uiteindelijk staat die pagina op mensen hun scherm omdat Facebook een overeenkomst met de beheerder sluit. En de vraag komt dan dus neer op: wie is die beheerder?

Het antwoord is niet hetzelfde als “de persoon die de overeenkomst sloot”. Als je dat als werknemer doet bijvoorbeeld, is je werkgever de contractseigenaar en dus de beheerder.

Als vrijwilliger ben je geen werknemer, dus dan ligt het lastiger. In 2019 bijvoorbeeld werd gekeken naar concrete opdrachten of waar het initiatief lag. Dit viel verschillend uit bij twee pagina’s van de vrijwilliger: eentje een “officiële” pagina van een politieke partij, een andere een groep daar omheen.

Die tenzij gaat op bij de pagina van de partij zelf. Deze is immers in 2014 aangemaakt voor de partij, en pas drie jaar later is het ex-lid gevraagd beheer daarvan te doen. … Voor de groep komt het anders uit. Het uitgangspunt blijft hetzelfde, maar deze groep is op eigen initiatief door het ex-lid aangemaakt, waarbij hij zichzelf als beheerder presenteerde en de groep niet als officieel of namens de partij aangemerkt had. Daarmee is er dan te weinig om te spreken van een groep die eigenlijk van de partij had moeten zijn.
Bij deze zaak gaat de redenering eigenlijk net zo. De pagina dateerde uit alweer 2013, en werd aangemaakt voor de organisatie door andere personen.
Vervolgens is [gedaagde] in verband met haar eigen dierenwebshop via [persoon 3] als website-beheerder van [eiser] in contact gekomen met [eiser] . In de loop van 2019 is zij de Facebookpagina gaan beheren en zij heeft in de jaren daarna de content verder uitgebouwd. Zij heeft dat in overleg met het bestuur van [eiser] gedaan. De omstandigheid dat aan [gedaagde] grotendeels de vrije hand is gegeven voor de bewerking van de Facebookpagina in het kader van de samenwerking maakt echter niet dat zij daardoor rechthebbend op de Facebookpagina is geworden.
Dat “vrije hand” argument hoor ik ook vaker: ik mocht alles zelf doen, dat bewijst dat ze vonden dat het mijn pagina was. Dat is dus niet juist. Ook niet als dat enorm veel werk was en de pagina alleen door al dat werk een gigantisch succes is geworden.

Ook telt niet het gegeven dat de organisatie je beheerder maakt. Die term suggereert weliswaar dat je iets bijzonders bent, maar dat is alleen in de relatie tot Facebook relevant. Het verandert niets in je relatie tot de organisatie.

Arnoud

Welke opensourcelicentie mag je plakken op een AI-gegeneerde hertaling van bestaande software?

Photo by Kuan-yu Huang on Pexels

Interessante discussie bij het pgrust project: als je bestaande software met een taalmodel omzet naar een andere programmeertaal, kun je dan je eigen licentie op het resultaat plakken?

Het pakket Postgres is een vrije relationele databaseserver. Vrij als in vrijheid: de software is beschikbaar onder de simpele BSD licentie die alle handelingen toestaat (“use, copy, modify, and distribute this software”) zonder nadere voorwaarden behalve copyright notice en geen claims als er fouten in zitten.

Iemand vond het een goed idee om Postgres te porten van de aloude programmeertaal C naar het modernere Rust. Redenen te over: Rust heeft ingebouwde bescherming tegen geheugenlekken en efficiëntere multithreading. En van de licentie mag het, want “modificeren” omvat auteursrechtelijk ook het ‘vertalen’ van een werk.

Het resultaat is zonder al te veel menselijke nabewerking opgeleverd op Github en onder de AGPLv3 licentie geplaatst. Die is iets strenger dan de BSD licentie: afgeleide werken mogen alleen onder diezelfde AGPLv3 aangeboden, en bij publieke vertoning van het werk (SaaS dus) moet de broncode als hyperlink erbij.

Postgres-ontwikkelaar Greg Burd stelde daarop “ter verduidelijking” de vraag: op welke grond is de licentie op onze software omgezet naar die AGPL?

Bij gewone integratie, herimplementatie of hertaling is dat een rare vraag. Immers, als programmeur moet je behoorlijk wat creativiteit inbrengen om dat te doen, en dan heb je auteursrecht op dat resultaat en dan mag je daar een licentie op zetten. Maar waar is hier de menselijke creativiteit, als een taalmodel 95%+ van de creatieve keuzes heeft gemaakt en de mens hooguit nog correcties en hier en daar wat poetswerk?

Een bestaand werk onder een nieuwe licentie plaatsen (dus niet integreren in of herzien tot een eigen werk) mag alleen als het woord sublicentie voorkomt in de licentietekst (voorbeeld: Apache 2.0). Dat is bij BSD niet het geval.

De reactie van de Rustversie-initiatiefnemer (Michael Malis) leest voor mij als een politiek zorgvuldig statement:

Re human vs ai authorship: we didn’t keep precise records of which code is ai generated and which code is human authored. Many of the high-level design decisions I personally made. For example, how to represent the Postgres error handling and memory management in Rust were decisions I personally made. These decisions for how memory management and error handling are designed are reflected in nearly every function.
Het is inderdaad goed voorstelbaar dat je als developer keuzes op hoog niveau maakt, en dan een taalmodel die uit laat werken naar concrete software. Alleen zijn “keuzes op hoog niveau” niet het soort creatieve inbreng waar je auteursrecht mee krijgt. De keuze “doe maar lila” is te weinig om auteursrecht op Postgres-de-software te krijgen. Daarvoor moet je echt actief in de broncode aan het schilderen zijn geweest.

Een subtiele oplossing kan nog zijn dat je zegt: daar waar sporen van creativiteit uit het origineel te herkennen zijn, geldt gewoon de BSD licentie. Auteursrecht door de taalmodel-wijzigingen is juridisch onmogelijk, dus afgezien van het handwerk achteraf is die gehele codebase gewoon BSD.

Het enige lastige daarmee is dat licenties – ook open source – niet binden tenzij je daarmee akkoord bent gegaan. Licenties zijn contracten. En afgaande op de reactie van Malis weigert hij de BSD licentie te accepteren. Dan blijft als conclusie over dat er auteursrechtinbreuk wordt gepleegd, want er wordt dan software aangeboden zonder rechtsgeldige licentie.

Arnoud

Juridisch is geoblocking prima, ook als mensen er met een VPN omheen kunnen

Photo by Petter Lagson on Unsplash

Bij iedere juridische maatregel is wel een technische tegenmaatregel te bedenken. Geoblocking is een bekende: gewoon een vpn installeren en hopsakee, je kunt er alsnog bij. Leuk en aardig, maar betekent niet dat die maatregel ongeldig of onhoudbaar is. De wet wil “goed genoeg” afdekken.

Ik roep dit al jaren, en voel me gesterkt door het recente arrest in de Anne Frank-zaak van het Hof van Justitie. Achterliggend is een wat ingewikkeld auteursrechtengeschil:

Na het overlijden van Otto Frank [die het dagboek bewerkte en uitgaf] is het Anne Frank Fonds houder van de auteursrechten op de werken van Anne Frank geworden. Zoals blijkt uit een definitieve uitspraak van de rechtbank Amsterdam (Nederland) van 23 december 2015 is een deel van deze werken in Nederland tot 2037 auteursrechtelijk beschermd krachtens een overgangsregeling van de Auteurswet. In andere landen, waaronder het Koninkrijk België, behoren deze werken tot het publieke domein.
Op de website www.annefrankmanuscripten.org wordt een wetenschappelijke editie van de manuscripten van Anne Frank gepubliceerd. Daarbij wordt middels geoblocking Nederlandse IP-adressen geweerd.

Vroeger stond er ook nog een knop bij „JA, ik raadpleeg de website vanuit een van de bovenstaande publiek domein-landen”, waarmee je dan de blocking kon opheffen onder dreiging van auteursrechtelijke sancties wegens omzeilen van beveiligingsmaatregelen (artikel 27a Auteurswet). Die knop zie ik nu niet meer.

Het Anne Frank Fonds stapte in 2021 naar de rechter omdat dit ondanks de maatregelen inbreuk op auteursrecht zou zijn. Daarbij woog mee dat de geoblocking te omzeilen zou zijn met een virtueel particulier netwerk, wat dan triviaal genoeg op te zetten zou zijn. Dat leidde tot vragen aan het Hof van Justitie, waar nu antwoord op is.

Het Hof is al een tijdje bezig met jurisprudentie over wat “het publiek” is waar je bij een publicatie je op richt. Als je je met effectieve technische maatregelen beperkt tot een bepaald publiek, dan richt je je niet op een ander publiek. Dat kan uitmaken voor je licentie, zoals wanneer je alleen schoolkinderen toegang wil geven. Maar omgekeerd geldt het ook: wie de publicatie met maatregelen beperkt tot “de wereld minus Nederland”, richt zich niet op Nederland.

Dan dus de hamvraag: is het “effectief” om een geoblokkade op basis van IP-adres te doen? We weten immers dat “gebruik gewoon een vpn” een voor de hand liggende reactie is. Hier, een mond vol van het Hof:

Het Hof heeft in dit verband gepreciseerd dat de doeltreffendheid van een technische voorziening niet absoluut hoeft te zijn, maar met inachtneming van het evenredigheidsbeginsel moet worden beoordeeld in het licht van de doelstelling om handelingen te voorkomen of onmogelijk te maken die niet zijn toegestaan door de auteursrechthebbende, waarbij dus met name dient te worden nagegaan of de betrokken voorziening geschikt is om dat doel te verwezenlijken en niet verder gaat dan daartoe noodzakelijk is en, zoals in punt 26 hierboven is aangegeven, een rechtvaardig evenwicht dient te worden gezocht tussen de bescherming van intellectuele-eigendomsrechten en die van andere grondrechten, zoals de vrijheid van meningsuiting en van informatie.
In gewone taal zegt het Hof: een maatregel hoeft niet perfect te werken, maar moet in de regel het effect hebben. Tegelijk moet de maatregel vals positieven beperken (zoals Belgen die toevallig een Nederlands IP-adres lijken te hebben). Dat er tegenmaatregelen zijn, is als abstracte tegenwerping géén argument.

Wel moet de maatregel “state-of-the-art” zijn, wat ik maar opvat als “je moet wel je best gedaan hebben” want hoe je dat meet, weet eigenlijk niemand. (De arme nationale rechter moet maar een deskundige benoemen.)

Dat er ook andere maatregelen zijn, zoals alleen via terminals in een bibliotheek of na identiteitsverificatie toelaten, is niet relevant. Je moet de maatregel zelf beoordelen op haar effectiviteit.

Arnoud


Taylor Swift wil stem en gezicht registreren als officieel merk in strijd tegen AI

Photo by Jovan Vasiljevi? on Unsplash

Taylor Swift gaat de strijd aan tegen AI-gegenereerde nepvideo’s, deepfakes en muziek, meldde BNR eerder deze week.  Ze heeft een merkaanvraag gedaan voor zowel haar stem als haar uiterlijk, om zo zowel visuele als auditieve deepfakes aan te kunnen pakken. Het is creatief en het merkenrecht is ook bedoeld tegen nep, maar of het kan met een stem of uiterlijk betwijfel ik.

Het merkenrecht gaat van oudsher over namaak, maar dat is in de loop der tijden verschoven naar het meer algemene begrip associatiegevaar: de kans dat iemand denkt dat jouw product of dienst wat met de merkhouder te maken heeft. Coca-Cola kan dus niet alleen optreden tegen blikjes koolzuurhoudende suikerdranken met “Hola Cola” er op, maar ook tegen juridische bloggers die zeggen “Mede mogelijk gemaakt door Coca-Cola”.

Het probleem van Swift en vele andere bekende personen is niet zozeer de namaak: het aanpakken van nep-merch of fake-accounts is al prima mogelijk. Associatiegevaar door AI-diensten is nieuw en veel lastiger aan te pakken. Denk aan een stemgenerator waar je een eigen liedje in kunt stoppen om dit met een Swift-stem terug te horen. Of een deepfake waarin zij danst en zingt zoals jij dat wil horen.

Gezichten of uiterlijk als merk is een trend die al langer speelt. In Europa liggen hierover vragen bij de hoogste rechter, maar de heersende opvatting is dat het niet kan: de centrale functie van een merk is herkomst of associatie met de merkhouder, en bij een gezicht is dat in het algemeen lastig. Die zie ik, maar specifiek bij een bekende persoon ligt dat wel anders. Het gezicht van Taylor Swift is bij uitstek hoe je denkt dat iets van Taylor Swift afkomstig is.

Bij stemmen kun je dezelfde discussie voeren. Daar komt nog de complicatie bij dat je een stem niet goed kunt vastleggen. Wat ís “de stem van Taylor Swift” precies? Bij merkenjurist Josh Gerben lees ik dat het gaat om de auditieve uitspraken “Hey, it’s Taylor Swift” en “Hey, it’s Taylor”.

Geluidsmerken bestaan, zoals de “Tu-Dum” van Netflix en voor de ouderen onder jullie de “Intel Bong”. Maar dat kan omdat het specifieke deuntjes zijn. Al wat ouder is het voorbeeld van de Harley-Davidson motor: “het geluid dat onze motor maakt als hij draait” was geen beschermbaar merk. Dat is te vaag en niet objectief te beoordelen.

Die twijfel heb ik ook bij deze audiomerken. Die twee uitspraken als merk vastleggen zie ik nog wel, maar kun je daarmee dan iedere uitspraak met jouw timbre aanpakken als associatief verwarrend? Of alleen die waar het woord “Taylor” in uitgesproken wordt? Precies bij liedjesgeneratoren zal nou net dát niet zo vaak gebeuren.

Arnoud


AI krijgt geen auteursrecht op zelfgemaakt beeld in VS

A Recent Entrance to Paradise, afbeelding vervaardigd met de DABUS tool waarover het artikel gaat.

Het Hooggerechtshof in de Verenigde Staten buigt zich niet over de vraag of kunstmatige intelligentie auteursrecht kan krijgen op visuele kunst. Dat meldde Tweakers bij Nu.nl (huh). Daarmee is een voorlopig definitief ‘nee’ gegeven op het principiële punt of je een AI-systeem als maker op kunt voeren.

De zaak is een nederlaag voor de Amerikaanse computerwetenschapper Stephen Thaler, die enige faam geniet in de IE-wereld als het lang drammende eenzame genie inzake creatieve computerprogramma’s. Alweer in 2012 liet hij een AI een kunstwerk maken, en hij spreekt antropomorfiserend over “zelfbewuste” (sentient) AI.

Thaler zet breed in: wereldwijd probeert hij octrooi te krijgen op uitvindingen gedaan door zijn creatie DABUS, en in de VS vecht hij ook voor auteursrechtelijke erkenning. De inzet daarvan is altijd het principiële punt dat zijn AI formeel als uitvinder of maker genoemd moet worden.

De auteursrechtdiscussie kan alleen in de VS, vanwege haar registratiesysteem. Formeel heb je ook in de VS automatisch auteursrecht (Berner Conventie) maar registratie is vereist om te mogen procederen en biedt de optie van statutory damages indien vooraf gedaan.

Het US Copyright Office kan aanvragen onderzoeken en afkeuren als niet aan de eisen is voldaan, wat ook hier gebeurde. Met het formele argument dat DABUS geen mens is, terwijl menselijke creatieve arbeid noodzakelijk was. Dat bleef bij de rechter overeind.

In hoger beroep ging men er eens goed voor zitten. Nergens in de Auteurswet stáát namelijk dat alleen een mens een werk kan maken. Dat was nooit echt een discussie omdat auteursrecht alleen een ding was bij menselijke makers (en een enkele makaak). Maar toch staat het er indirect wel:

[T]he court found that multiple provisions make clear that authors must be human beings. Ownership provisions assume the author can hold property; duration provisions measure terms by the author’s lifespan; joint authorship requires intent; and registration requires a signature – all capacities only humans possess.
Voor mij is die eerste het belangrijkste. Een auteursrecht is uiteindelijk een vermogensrecht, oftewel iets dat je kunt verhandelen of exploiteren. Om dat te hebben, moet je wel bestaan. En dat kan ook bij rechtspersonen zoals bedrijven of stichtingen, maar de wet kent daarbij een gesloten systeem. Je bent pas een persoon als de wet dat zegt (zei hij heel anti-soeverein).

De Supreme Court had hier een fundamentele uitspraak over kunnen doen, maar laat die kans aan zich voorbij gaan. Daarmee blijft de uitspraak van het Court of Appeals overeind.

In de tussentijd heeft het US Copyright Office AI-prompteurs een sprankje hoop gegeven; je kunt een zogeheten compilation copyright krijgen als je menselijke creativiteit toevoegt door “selection, coordination, or arrangement” binnen de uitvoer van de AI. Die moet dan weer wel uit het werk zelf af te leiden zijn. Een prompt, hoe creatief ook, is daarbij niet genoeg.

De Europese rechtspraak heeft hier nog geen vergelijkbaar antwoord op. Zijdelings kwam het aan de orde in de Painer zaak in 2013, waar de advocaat-generaal opmerkte dat alleen mensen de benodigde creativiteit kunnen leveren. Maar dat is geen deel van het arrest zelf geworden. (Heel enthousiast lezend zou je het uit rechtsoverweging 90-92 kunnen halen.)

In lijn met die laatste Amerikaanse zaken is het Levola-arrest uit 2018, dat bepaalde dat ook bij ons de creativiteit in het werk zelf herkenbaar moet zijn. Keuzes ten tijde van het prompten of anderszins besturen van de AI-software tellen dan niet mee, omdat je die niet kunt zien in de uitvoer.

Arnoud


Gaat AI het concept open source definitief verwoesten?

Photo by Claudio Schwarz on Unsplash

Het chardet-project heeft laten zien dat AI open source kapot gaat maken, aldus Bruce Perens. En hij kan het weten, want hij schreef de definitie van open source destijds. Chardet is van licentie veranderd na een AI-herimplementatie, en de vraag is dus of dat kan.

Chardet is een Python-bibliotheek die van een tekst aangeeft in welke codering (zoals UTF-8, Cyrillisch of Oost-Aziatisch) deze opgemaakt is. Handig ding, wel even opletten want de licentie is de bekende LGPL. Dus wijzigingen aan de library zelf kun je alleen onder LGPL verspreiden. (En dat verhaal over statisch en dynamisch linken.)

Sinds versie 7 is de bibliotheek ineens onder de MIT licentie beschikbaar. Dat scheelt, want de enige eis is dan dat je de auteursvermelding en licentietekst niet weghaalt uit de broncode. En dat je de auteur, in dit geval ene Dan Blanchard, niet aansprakelijk kunt stellen, maar dat terzijde.

Zoals Perens uitlegt:

Blanchard says he was in the clear to change licenses because he used AI – Anthropic’s Claude is now listed as a project contributor – to make what amounts to a clean room implementation of chardet. That’s essentially a rewrite done without copying the original code – though it’s unclear whether Claude ingested chardet’s code during training and, if that occurred, whether Claude’s output cloned that training data.
Probleem: hoewel Blanchard de code sinds 2012 onderhoudt, was hij niet de originele auteur. Dat was Mark Pilgrim, die rond die tijd van internet was gevallen maar nu ineens weer opdook met een boze ticket: No right to relicense this project.

Auteursrechtelijk klopt dat; zonder overdrachtsakte kan Blanchard code van Pilgrim niet onder een andere licentie plaatsen. Maar Blanchard stelt dus dat versie 7 een geheel nieuwe versie is, en roept daarbij dat zelfs een “clean room implementation” vormt.

Clean room reverse engineering is een oude techniek waar veel mythes omheen hangen. Kort gezegd: groep A analyseert iemands software en documenteert wat het moet doen. Groep B krijgt die documentatie en maakt software die dat doet. A’s analyse is legaal, en B kopieert de software niet dus handelt ook legaal.

Dit staat of valt met één cruciale aanname, namelijk dat B geen toegang heeft tot de software die A analyseert. Want als je wél kopieert, ga je nat. En toegang hebben en dan iets sterk vergelijkbaars maken levert op zijn minst een donkerbruin vermoeden van kopiëren op.

Clean room werkte om geheim gehouden software (zoals de IBM PC BIOS software) legaal te kunnen imiteren. Maar bij open source is het juridisch gezien absurd om van clean room te spreken. De broncode ligt letterlijk voor het oprapen. Dus hoe kun je dan met droge ogen beweren dat je een schone herimplementatie hebt gemaakt?

Oh ja, we deden het met AI. Blanchard zegt allereerst dat zijn nieuwe code vrijwel volledig anders is, wijzend op een software-plagiaattool die slechts 1,29% gelijkenis tussen de bronbestanden ziet. Dat komt dan weer omdat Blanchard aan de codegenerator van Anthropic’s Claude heeft gevraagd een nieuwe versie te maken:

For full transparency, here’s how the rewrite was conducted. I used the superpowers brainstorming skill to create a design documentspecifying the architecture and approach I wanted based on the following requirements I had for the rewrite […]
Hij gebruikte daarbij nadrukkelijk de opdracht “kijk niet naar de LGPL code”, wat voor mij net zo nuttig is als “maak geen fouten” in je prompt. Zeker omdat het volgens mij een publiek geheim is dat LLM-codegeneratoren getraind zijn op Het Hele Internet en dus ook op alles op Github. Waaronder de originele chardet.

Clean room is dit dus zeker niet te noemen. Tegelijk wordt het inbreuk-argument wel weersproken door de feitelijke ongelijkheid tussen de broncodes. Er moet wel iets aantoonbaar overgenomen zijn om van inbreuk te mogen spreken.

Uiteindelijk is dat het punt van Perens: als je dus tegen een AI kunt zeggen “herschrijf deze code” en de gelijkenis is lager dan X procent, dan is iedere OSS licentie te omzeilen door de software gewoon even door zo’n LLM-room te halen.

Arnoud


Kun je auteursrecht op een ChatGPT-prompt hebben?

Photo by Berke Citak on Unsplash

Of er auteursrecht rust op AI-uitvoer, daar kun je gerust over twisten. Minstens zo interessant vind ik de discussie of je auteursrecht kunt claimen op je prompt, de invoer waarmee zo’n AI-systeem uitvoer voor je samenstelt. Een Chinese rechtszaak geeft hier een paar leuke ideeën voor.

Auteursrecht ontstaat automatisch (“van rechtswege”) zodra je een werk maakt. Tekst, ook kort, kan zeker een werk zijn. De enige twee vragen zijn inhoudelijk: is sprake van creatieve arbeid van de schrijver daarvan, en zien we die terug in het werk?

Een recent vonnis uit China ging over precies deze kwestie. De eiser maakte afbeeldingen met de dienst Midjourney, die bij elke afbeelding de gebruikte prompt publiceerde. De gedaagde had die prompts overgenomen en gebruikte ze om eigen, concurrerende afbeeldingen mee te maken. De gelijkenis viel op, en dat leidde tot deze rechtszaak.

De eiser maakte de vergelijking met een filmscript. Dat is weliswaar een instructie (doe dit, zeg dat, ga zo bewegen) maar duidelijk ook een artistieke keuze van de regisseur en scriptschrijver.

Ik zie echter wel een verschil met een AI-prompt: die heeft ook een functionele rol. Ik zou een prompt eerder met een computerprogramma vergelijken. Ook daar maak je creatieve keuzes bij het schrijven, maar je hebt wel te maken met bepaalde eisen of functionele beperkingen. Dat ding héét nu eenmaal interrupt 21h en die wenst alleen met mov aangesproken te worden.

De Chinese rechter onderkent dit ook:

[T]he six sets of prompts in question are essentially instructions or descriptions entered by the user into the AI system to guide the AI in generating specific images. Formally, although they contain various elements, these elements are simply listed without grammatical or logical connections, failing to form a language expression with an inherent structure; the keyword groups are in a disordered combination, lacking both structural progression and a narrative sequence.
Het ontbreken van die eigen ordering of narratief maakt dat deze prompts niet als beschermd werk gezien kunnen worden. Dit was te zeer functioneel, gewoon een lijst met gewenste trefwoorden en keuzes. Daar zal best veel creatief denk- en experimenteerwerk achter hebben gezeten maar dat zie je niet terug aan de woorden. En daarom rust er geen auteursrecht op.

Ook ziet de rechter een gevaar met auteursrecht toekennen op zulke korte instructiesets. Hierdoor zouden in essentiel bepaalde instructies gemonopoliseerd kunnen worden, wat te zeer botst met de algemene vrijheid van meningsuiting.

Een lange, meer als verhaal of schets vormgegeven prompt zou dus in principe nog voor auteursrecht in aanmerking kunnen komen. De lastige vraag die nu blijft liggen, is of je dan de afbeelding als afgeleid werk (verveelvoudiging in gewijzigde vorm) van de prompt zou kunnen aanmerken. Ik denk zelf van niet, om de simpele reden dat je de prompt niet kunt terugzien in het werk.

Arnoud

EU onderzoekt of Google genoeg betaalt voor teksten die zoekmachine gebruikt

Photo by Patrick Tomasso on Unsplash

Google mag niet zomaar inhoud van het internet plukken om zijn eigen kunstmatige intelligentie mee te voeden. Dat las ik bij Nu.nl. De Europese Commissie ziet deze werkwijze als een schending van het mededingingsrecht vanwege misbruik van de dominante positie in de zoekmarkt.

Sinds kort heeft de advertentiedienst-met-zoekmachine Google twee nieuwe AI-toepassingen: AI Overview en AI Mode. AI Overviews vat zoekresultaten samen, en AI Mode biedt een soort chatinterface. Daar is veel van te vinden, maar het probleem hier is dat je als website-exploitant niet kunt verhinderen dat Google ook jouw content hierin gebruikt.

De Commissie ziet dit als machtsmisbruik. Je enige escape is Google geheel blokkeren (de crawler is gewoon dezelfde, dus de AI-bot blokkeren met robots.txt zit er niet in). Maar niemand zal buiten Google willen blijven, dus moet je knarsetandend toezien hoe Google mooie AI-sier maakt met jouw content als bronvermelding.

Natuurlijk, Googles zoekmachine zelf doet dit al sinds 1998, net als haar voorganger-zoekmachines. Het idee van zoekmachines is het hele web scrapen en de resultaten sorteren op een relevante manier. Of dat mocht van het auteursrecht is altijd een beetje grijs gebleven, maar de consensus die ik ken, komt erop neer dat het oké zou moeten zijn omdat zoekmachines uiteindelijk je zó veel zichtbaarheid en kliks geven dat dit opweegt tegen eventuele gemiste inkomsten.

Het probleem met die AI-modi is precies dat: niemand klikt op jouw site, want ze hebben het antwoord al. (Of denken dat te hebben, want het is vaker fout dan goed. Maar dat terzijde.) Dit staat bekend als het Google Zero fenomeen. En die onbalans maakt dat we de hele auteursrechtelijke discussie weer opnieuw kunnen gaan voeren. Maar dat wil niemand, want dat komt neer op uit Google gegooid worden.

Het probleem is dus: eigenlijk had Google dit moeten vragen, en dan hadden ze waarschijnlijk geld moeten betalen. Nu hebben ze een gratis licentie afgedwongen, en dat konden ze door misbruik te maken van hun machtspositie (je gaat uit Google als je geld vraagt voor AI Overviews).

De Commissie onderzoekt eigenlijk wat er gebeurd zou zijn als Google netjes met iedereen een licentie had afgesloten: welk bedrag zou er dan zijn betaald? Dat is dan het bedrag dat Google oneerlijk verdiend heeft door dat misbruik.

Arnoud


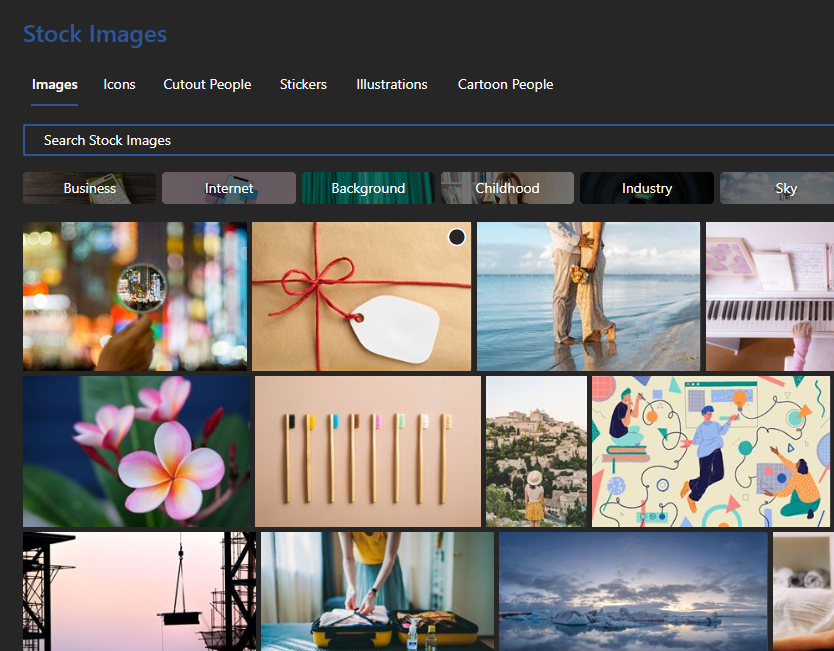
Mag ik Microsoft clipart eigenlijk wel in een pdf document stoppen?

Een lezer vroeg me:

Regelmatig gebruik ik de afbeeldingenbibliotheek van Microsoft in presentaties, Word-documenten en dergelijke. Nu wees een collega me er op dat dit alleen mag zolang je ze alleen hergebruikt in programma’s van Microsoft, dus een tekst gemaakt in Word met afbeeldingen mag je als Word-document (online) publiceren maar niet als pdf want dat is een programma van Adobe. Klopt dat?
Microsoft heeft een behoorlijk uitgebreide bibliotheek met creatief materiaal zoals iconen en stockbeeld, naast een koppeling met Bing Afbeeldingen die mede kan zoeken op licentie (Creative Commons). Afgezien van die laatste liggen de rechten op dat materiaal bij Microsoft, en je hebt dus een licentie nodig om dit te mogen gebruiken.

Het lastige is dat de standaard licentie van Microsoft noch de dienstenvoorwaarden (TOU) dit expliciet vermeldt. Gezien hoe auteursrecht werkt, mag je dan die materialen dus niet gebruiken.

Oudere versies van die licentie benoemden dit wel nadrukkelijk, en hanteerden het criterium van van “geïntegreerd in een document” wat ik altijd heel logisch vond. Je krijgt toegang tot die clipart om je documenten mee te versieren, dus mag je er documenten mee versieren. Maar ze los op mokken of advertentieposters plakken, dat is niet de bedoeling dus mag dat niet.

Het enige dat er nu nog is, is een soort FAQ van Microsoft waarin ze uitleggen dat

You can use the premium images and other creative content however you see fit, as long as it’s within an Microsoft 365 app or SharePoint site. For commercial customers, this includes selling PowerPointpresentations, Excel workbooks, or Word documents that include this content, just as you would have sold these files in the past.
Het criterium is hiermee verschoven naar “moet in onze apps blijven”. Hoe zich dat verhoudt tot “je mag ze verkopen” is dan wel volstrekt onduidelijk.

Iets verderop staat dat je mag “Export these files to other formats such as PDF and ODF.” Die PDF mag je dan kennelijk ook ‘verkopen’ of weggeven aan een ander, maar daarbij gaat de content dan buiten de MS365 app of SharePoint site.

Ik denk dat dat dus mag, specifiek omdat men spreekt van “selling documents that include this content” en gratis weggeven zit redelijkerwijs in dezelfde categorie. (Juristen die over ‘redelijk’ beginnen, hebben geen echte argumenten meer.)

Wat vooral onduidelijk is, is wat de ontvanger mag doen met het document. Lezen en dergelijke is ongetwijfeld prima, maar zou deze de presentatie aan mogen passen in OpenOffice en die dan aan hun cliënt mogen geven? Ik vermoed van niet gezien de bewoordingen van de licentie, maar “selling presentations” impliceert dat de koper er mee mag doen wat deze wil.

Arnoud