Ik werk als onderzoeker aan AI en maak me zorgen over de nieuwe regels van de AI Verordening. Waar moet ik rekening mee houden?
De AI Verordening of AI Act bevat stevige regels voor wat deze wet “hoog-risico AI” noemt. De achtergrond van deze wet is die van productveiligheid, wat ook meteen maakt dat zaken die weinig met productie en vermarkten van producten (of diensten) te maken hebben, er gauw buiten vallen.
Wie de AI Act openslaat bij artikel 2 lid 6, ziet bijvoorbeeld:
Deze verordening is niet van toepassing op AI-systemen of AI-modellen, met inbegrip van hun output, die specifiek zijn ontwikkeld en in gebruik gesteld met wetenschappelijk onderzoek en wetenschappelijke ontwikkeling als enig doel.
Toch is het zo simpel nog niet als dat alle vormen van R&D zijn uitgezonderd. Het probleem is namelijk dat de AI Act niet definieert wat “wetenschappelijk onderzoek en ontwikkeling” inhoudt, of wat het betekent dat je dit “als enig doel” doet versus ook bijvoorbeeld met het doel van marktintroductie er naast.
Even verderop bepaalt de Act nog een keer dat zij niet van toepassing is op “onderzoeks-, test- of ontwikkelingsactiviteiten” zolang het nog niet gaat om producten of diensten die op de markt zijn. Dit komt grofweg neer op het zakelijk aanbieden van producten of diensten, hoewel ook gratis aanbieden (bijvoorbeeld met advertenties) er onder valt. De resultaten van wetenschappelijk onderzoek publiceren zal daar niet onder vallen. Een als experiment opgezette dienst na onverwacht succes voorzien van advertenties en zo gratis weggeven zal dat daarentegen wél doen.
Een meerderheid van de Tweede Kamer wil actie ondernemen tegen de grootschalige ‘diefstal’ van stemmen en teksten van Nederlandse artiesten en tekstschrijvers door aanbieders van kunstmatige intelligentie. Dat meldde het AD onlangs. Apps zoals Udio kunnen middels AI liedjes maken met de stemmen van bekende artiesten, zoals Herman van Veen die zich hier erg kwaad over maakt.
Het artikel noemt twee juridische routes en stelt verder dat de Tweede Kamer iets kan doen om de positie van artiesten en tekstschrijvers kan verbeteren. Allereerst de Digital Services Act: deze regelt het verwijderen van illegale content (notice/action) en verplicht tot transparantie over de werking van algoritmen. Of Udio daaraan voldoet is de vraag, maar belangrijker: het is zeker niet gezegd dat een liedje “in de stijl van” of “klinkend zoals” onrechtmatig is en dus verwijderd zou moeten worden.
Dan komt ook de AI Act langs:
Het CDA wijst naar nog een andere wet: de Europese AI Act, een wet die vanaf 2025 eist dat creatieve makers eerst toestemming moeten geven. ,,De opkomst van Udio laat zien dat er geen tijd te verliezen is om die te vertalen naar concrete regels”, waarschuwt CDA-Kamerlid Herman Krul.
Ik denk dat hier sprake is van een misverstand, want de AI Act zegt alleen dat de producenten van algemene AI modellen (zoals LLaMa of GPT) iets met auteursrecht moeten en dan ook nog eens alleen in de vorm van een duidelijk beleid over hoe zij aan de wet voldoen. Toestemming vragen is zeer zeker niet genoemd in de AI Act.
Ook wie de Auteurswet erbij pakt, komt niet uit bij toestemming. Deze wet kent namelijk een uitzondering voor tekst- en datamining, die neerkomt op “je mag een AI trainen met auteursrechtelijk beschermde data”. De uitzondering daar weer op is als het auteursrecht op machinaal leesbare manier is voorbehouden – en dát kan alleen als er een standaard is over hoe je dat voorbehoud maakt. In een tekstbestand de letters op een rij zetten “Auteursrecht voorbehouden” is geen machinaal leesbaar voorbehoud. Dat is dus nog een probleem.
Meer algemeen is mij niet duidelijk wat de Tweede Kamer zou moeten doen aan dit probleem. Het auteursrecht is Europees geregeld, en onze wetgever kan en mag geen eigen regels aannemen die strenger zijn op dit punt. Ook collectief beheer (AI voor muziekuitvoer trainen mag mits Buma/Stemra geld krijgt) is niet mogelijk binnen het Europese stelsel.
De AI Act is ook een Europese wet, net als de DSA, en beiden bieden geen optie om aparte auteursrechtregels of toestemmingsvereisten in te voeren. De enige route die ik kan bedenken is dat de DSA-toezichthouder ACM via de open norm van een systemic risk assessment bij de app-aanbieders afdwingt dat deze anders met auteursrecht omgaan. Maar dat kan alleen als die apps VLOP zijn (zeer groot online platform), en volgens mij voldoen die bij lange na niet aan deze definitie.
Daar komt bij dat de ACM nog steeds niet formeel aangewezen is als toezichthouder onder de DSA. Dat is dan weer wél iets dat de Tweede Kamer snel zou kunnen regelen, overigens.
Kennelijk zat er iets in het water, want afgelopen week zag ik het óveral: de AI verklaring. Ik snap dat mensen iets willen doen en dat de privacyverklaring een prettig en bekend iets is, maar ik wil dit graag per direct de kop indrukken want het hoeft niet van de Act, is niet interessant voor je bezoekers en voegt nul toe aan wat je wél moet doen. Dus nee.
De AI verklaring is bedoeld als analogie met de privacyverklaring. De diverse varianten die ik heb gezien, benoemen ook keurig onderwerpen die je in de AI Act langs ziet komen: waarom gebruiken we AI, welke beveiliging hebben we hierop, hoe kun je klagen of recht van uitleg krijgen (art. 86 AIA) en vele mooie woorden over het nastreven van afwezigheid van bias.
Moet dit van de AI Act? Welnee. Er staan geen informatieplichten in naar gebruikers of betrokkenen (“affected persons”). Je moet transparant zijn dát je met een AI te maken hebt (art. 50) en als een AI een beslissing neemt heb je recht op uitleg (art. 86), en dat is het wel zo’n beetje. Voor de rest gaat de AI Act er van uit dat je AI gewoon netjes werkt; dat hoef je niet te verklaren want als ie dat niet doet (bv. vanwege bias) dan mag het ding de markt niet op.
Eigenlijk was de privacyverklaring zelf ook altijd al een slecht idee. En nee, die moest niet van de AVG en ook niet van de Wbp. Je moest informatie verstrekken over wat je verzamelt en wat je ermee doet, maar dat hoefde zeer zeker niet als een dik boekwerk.
Die specifieke praktijk komt uit de VS: de FTC had ooit geoordeeld dat het een oneerlijke handelspraktijk is als je niet expliciet uitlegt wat voor persoonlijke informatie je verzamelt en waarom. En in de VS is een dik onleesbaar boekwerk neerplempen een geaccepteerde praktijk – jij als consument moet maar goed lezen en anders ben je gewoon de pineut.
(Wat er wél moet onder de AI Act lees je in mijn nieuwe boek The Annotated AI Act, pre-order is nu al mogelijk.)
Elisa Shupe werd aanvankelijk afgewezen toen ze probeerde auteursrecht te verkrijgen op een boek dat ze met hulp van ChatGPT had geschreven, las ik bij Wired. Toch is het haar gelukt, zij het niet met de argumentatie die ze liever had gehad. Het lijkt wel de jurisprudentie te bestendigen tot nu toe.
Het artikel legt uit:
Het [logboek van Shupe] bevat een vergelijking naast elkaar van de onbewerkte machine-uitvoer en de definitieve versie van Shupe’s boek. Op zinsniveau paste ze vrijwel elke regel op de een of andere manier aan, van veranderingen in woordkeuze tot structuur. Een voorbeeld dat een personage in de roman beschrijft: ‘Mark keek naar haar, een complexe mix van bezorgdheid en ergernis duidelijk zichtbaar in zijn blik’ wordt ‘Mark bestudeerde haar, zijn blik weerspiegelde zowel zorgen als irritatie.’
Het US Copyright Office ziet dit als een vorm van ‘selectie, coördinatie en rangschikking van tekst gegenereerd door kunstmatige intelligentie’. Het idee van een creatieve selectie en bewerking van op zichzelf niet beschermd bronmateriaal is al lang aanvaard als een criterium voor auteursrecht. We kwamen dit in januari nog tegen:
In Nederland bestaat deze constructie ook. Denk aan het creatief oppoetsen van een publiek-domeinwerk: dat geeft je ook auteursrecht op het opgepoetste resultaat (maar natuurlijk niet op het bronmateriaal). Ik zie geen reden waarom dit anders zou moeten werken als je een AI-werk ‘oppoetst’.
Shupe had echter een ander argument ingebracht dat ze zelf sterker vond:
[Namelijk] om een ??belangrijker pad te openen naar auteursrechterkenning voor door AI gegenereerd materiaal. “Ik probeer auteursrechten te verkrijgen op het door AI ondersteunde en door AI gegenereerde materiaal onder een ADA-vrijstelling vanwege mijn vele handicaps”, schreef ze in haar oorspronkelijke auteursrechtaanvraag.
Ze is als 100 procent gehandicapt beoordeeld en heeft moeite met schrijven vanwege cognitieve stoornissen die verband houden met aandoeningen als een bipolaire stoornis, borderline-persoonlijkheidsstoornis en een misvorming van de hersenstam. Dan zie ik hoe het handig kan zijn als tools je een heel eind vooruit helpen.
Maar wat betekent het voor het auteursrecht op het resultaat? Stephen Hawking schreef bijvoorbeeld met een tool die losse woorden voorstelde, en iets dergelijks zit ook in veel telefoon-invoerapps: typ een woord en krijg een suggestie voor het volgende. Weinig mensen zullen zeggen dat de zin die je zo typt, een AI zin is. Het is mijn zin, het is gewoon logisch dat na ‘gewoon’ ‘logisch’ komt.
Als het systeem na één woord de hele zin afmaakt, of zelfs er een alinea van maakt, dan wordt dat gevoelsmatig een ander verhaal. Is dat nog een handige invulling van jouw keuze of zijn we dan al in de vrije ruimte van de tool beland?
De vergelijking die Shupe maakt, is ook een intrigerende: ze vergeleek “haar gebruik van OpenAI’s chatbot met een geamputeerde die een beenprothese gebruikt”. Oftewel: welk percentage van je lijf moet nog origineel-organisch zijn om nog ‘mens’ genoemd te worden? Daar is geen rechtszaak over gevoerd – en wat zou ook de insteek zijn, bij zo veel procent metaal bent u ruimbagage?
113 artikelen, 13 bijlagen, 180 overwegingen, verwijzingen naar 27 andere wetten: de AI Act is het meest complexe stuk wetgeving dat ik ooit heb gezien. Mijn nieuwe boek “The Annotated AI Act” verheldert en analyseert de wet in gewone taal. Je kunt nu al voorintekenen!
Op hoofdlijnen is de AI Act vast al bekend. Een risicogebaseerde regulering van AI systemen, met aparte regels voor general-purpose AI en een markeerplicht voor synthetische content. Maar de risicobenadering werkt nét even anders dan bijvoorbeeld de AVG; het gekozen model is dat van productveiligheid en conformeren aan standaarden (CE keurmerk).
Met name in de laatste maanden van 2023 is er veel gebeurd met de tekst. Er moest en zou een regulering van GPAI in komen, maar dat past niet echt bij die productveiligheidsbenadering, en de auteursrechtlobby had zich ook gemeld ondertussen. Dit leidde tot een paar marathonsessies in december, waar uiteindelijk een politiek akkoord uit kwam dat in de maanden daarna uitgewerkt werd.
(Ik ben gaan schrijven toen dat akkoord er was, en moest uiteraard alles omnummeren toen de definitieve tekst werd gedropt want toen werden artikel 29a, overweging 80z+1, het lege artikel 19 en de twee artikelen 54 en nog wat van die missers aangepast.)
De haast heeft helaas een aantal dingen laten we zeggen iets minder optimaal gestructureerd. Het is dus flink zoeken naar het juiste artikel, of de combinatie met andere artikelen. Dat is waar ik dit boek voor geschreven heb: kruisverwijzingen, contrasten en literatuur (100+ referenties) voor meer achtergrond of kritische beschouwing.
Het boek verschijnt in mei wanneer de AI Act gepubliceerd is. Maar je kunt nu al voorintekenen:
Een Amerikaanse rechter heeft geweigerd dat een video als bewijs wordt gebruik in een rechtszaak vanwege het gebruik van AI-software bij het bewerken van de video. Dat meldde Tweakers vorige week. Door gebruik van de software wilde de aanklager duidelijker maken dat het inderdaad ging om de verdachte.
Wat ging er nou precies mis?
De aanklager gebruikte Topaz Video AI om de video te upscalen, meldt NBC News. De software van het Amerikaanse bedrijf herkent gezichten en vult vervolgens details aan die niet in het oorspronkelijke beeld zaten. Dat is problematisch, zo redeneert de rechter, want de software ‘leunt op vage methoden om te bepalen wat het AI-model denkt wat we moeten zien’, aldus de rechtbank.
Topaz is videobewerkingssoftware: je kunt er beeld mee opknappen, zoals door het er scherper laten uitzien. Dat is mooi voor die vakantiefoto die niet helemaal goed gelukt is, of voor het aanvullen van beeld voor je reclamecampagne dat nét even iets extra’s nodig heeft.
Specifiek bij bewijs is dat allemaal net iets spannender. Het is natuurlijk prima als het bewijs beter te beoordelen wordt, maar dat moet niet gebeuren door er dingen bij te verzinnen, hoe mathematisch logisch het ook lijkt dat die pixels er tussen moeten.
Het plaatje rechtsboven (van een experiment uit 2020 met hetzelfde doel) laat zien waarom: de dataset daarvan bevatte geen gezichten van kleur, waardoor de bekende foto van president Obama opgewerkt werd tot geheel iemand anders. Een recenter voorbeeld was beeldbewerkingssoftware die ongevraagd acteur Ryan Gosling toevoegde aan een video.
Mag dit nou van de AI Act? Ik zit even te peinzen of dit telt als biometrie, maar interpolatie van pixels kan ik moeilijk gelijk stellen aan analyse van gezichtskenmerken. Op de lijst (Annex III) staan wel diverse vormen van AI-gebruik door wetshandhaving, waar naast de politie ook het OM onder valt:
AI systemen gebruikt als leugendetector
AI om de betrouwbaarheid van bewijs te evalueren
AI om recidivisme in te schatten (waarbij meer dan profiling wordt gebruikt, want anders is het verboden)
AI voor het profileren van mensen in het kader van opsporing en vervolging
Het met AI mooier maken van bewijs lijkt mij onder het tweede item te vallen. Daarmee zou de inzet van Topaz door het OM aan de high-risk eisen moeten voldoen, wat lastig is omdat het systeem als zodanig daar niet op ontworpen is. Zo zal er geen inzage te krijgen zijn in de gebruikte trainingsdata of accuratesse, en moet het OM dan flink moeite doen om de verplichte adequate logging te bouwen.
Ook zullen dit soort systemen onder de transparantie-eis van “synthetic output generator” AI vallen. Die moeten zorgen dat hun beeld onzichtbaar en robuust gewatermerkt is zodat andere systemen (zoals het uploadformulier van Facebook) kan signaleren dat er synthetische afbeeldingen worden geupload.
Naar de letter van de wet is zulk beeld zelfs een deepfake:
“deepfake”: door AI gegenereerd of gemanipuleerd beeld-, audio- of videomateriaal dat een gelijkenis vertoont met bestaande personen, voorwerpen, plaatsen of andere entiteiten of gebeurtenissen, en door een persoon ten onrechte voor authentiek of waarheidsgetrouw zou worden aangezien;
Twintig bij twintig pixels uitvergroot en bewerkt zodat je er Ryan Gosling in ziet, lijkt mij wel “een gelijkenis vertonen” waardoor je ten onrechte het beeld voor waarheidsgetrouw aan gaat zien. Dit beeld moet dus expliciet gemarkeerd worden als niet-authentiek.
Is hiermee alle gebruik van beeldbewerking verboden? Nee. Nog even los van dat dit één uitspraak is; de betrouwbaarheid van via ict verkregen bewijs vaststellen is al decennia een aandachtspunt. AI maakt het manipuleren van bewijs eenvoudiger en sneller, maar dat is geen fundamenteel nieuwe kwestie.
Wie een pakje sigaretten koopt, komt op steeds meer plekken in Nederland een gezichtsscanner tegen. Dat las ik bij RTL Nieuws onlangs. De scanner schat je leeftijd (25+ of niet) en laat je dan sigaretten kopen (of niet). Enkele rokende lezers stelden me vervolgens de vraag: mag dat eigenlijk wel, inzet van biometrie voor zo’n profileringsdoel? En vooral: wat zegt de aankomende AI Act?
De AI Act is definitief maar nog niet aangenomen (in mijn nieuwe boek lees je alle details). Dat zal in mei gebeuren. Daarna is er twee jaar overgangsrecht, hoewel de zogeheten verboden praktijken al over zes maanden moeten stoppen. En in die lijst (artikel 5) staan de nodige biometrische toepassingen:
Emotieherkenning op het werk en in het onderwijs, behalve indien noodzakelijk voor veiligheid of medische redenen (art. 5(1)(f)).
Biometrische categorisatie op bijzondere persoonsgegevens, zoals het afleiden van etnische afkomst of seksuele voorkeur (art. 5(1)(g)).
Real-time biometrie op afstand in de openbare ruimte voor wetshandhaving (art. 5(1)(h)))
Geen van deze drie is van toepassing op dit systeem. “25 jaar of ouder” zijn is geen bijzonder persoonsgegeven immers.
Diverse toepassingen van biometrie zijn als hoogrisico aangemerkt. De AI Act is daar formeel in; iets is hoogrisico als het op de lijst (Annex III) staat, je hoeft geen eigen inschatting te maken van hoe hoog of hoe ernstig het in jouw geval is. Pas je onder een tekst? Dan ben je hoogrisico.
De eerste toepassing is biometrie op afstand. De AI Act gebruikt hierbij niet een criterium uitgedrukt in meters, maar of je meerdere mensen tegelijkertijd scant (overweging 17, artikel 3 lid 41), met “typisch op afstand” als optionele toevoeging.
De tweede toepassing is emotieherkenning (dus niet op werk of school). Dit is niet van toepassing, want leeftijd is geen emotie.
Blijft over biometrische categorisatie op basis van gevoelige of beschermde kenmerken. Dit komt goed in de buurt: de categorieën zijn dan “25 jaar of ouder” versus “jonger dan 25”, en dit gebeurt op basis van gezichtskenmerken die goed ‘gevoelig’ kunnen zijn. Daarmee moet de leverancier aan een hele berg compliance-verplichtingen voldoen.
Die 25 jaar is overigens gekozen om de foutmarge naar 2% terug te dringen: het verschil zien tussen 17 en 19 is te subtiel kennelijk.
Waar ik vooral mee zit: de gezichtsscan duurt zo te zien op het filmpje minstens zo lang als een ID-kaartscan. (De leverancier spreekt van “rap” maar ik zie echt het tijdsverschil niet.) Je ID moet je altijd kunnen laten zien. Wat is dan precies nog het praktische voordeel van deze AI oplossing ten opzichte van altijd ID laten zien?
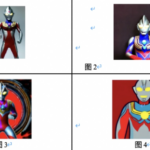
De Guangzhou Internet Court heeft recent geoordeeld dat de uitvoer van een AI inbreuk op auteursrecht kan zijn, las ik in de Global Times. De rechthebbende had ontdekt dat als je vroeg om plaatjes van zijn werk – Ultraman – je dan plaatjes kreeg die auteursrechtelijk gezien inbreukmakend waren. De AI-dienst is daarvoor aansprakelijk, zo bepaalde de rechter.
Helaas is de naam van de AI-plaatjesdienst niet te vinden, maar de eiser is de rechthebbende op de Japanse Ultraman franchise, en die had dus zelf ontdekt dat vragen om plaatjes van dat werk (zie plaatje, klik voor groter) je de ‘echte’ Ultraman kreeg.
Niet heel raar zou je zeggen: je vraagt om X en je krijgt X, dat voelt de bedoeling van een computersysteem. Maar specifiek als X onder iemands auteursrecht (of merk) valt, is dit een tikje problematisch. Auteursrechtelijk gezien mag je ook niet een illustrator vragen om zo’n afbeelding te maken, immers.
Uniek is het niet: in januari verscheen een artikel in de New York Times waarbij men ‘ontdekte’ dat als je vraagt om “popular movie screencap Joker” je een afbeelding van Batman-personage The Joker krijgt die erg sterk lijkt op de wijd en zijd gepubliceerde foto van Joaquin Phoenix in die rol. Maar dit is wel de eerste keer dat een rechtbank dit ook als inbreuk ziet.
De rechtbank in Guangzhou oordeelde d dat de afbeelding inbreukmakend was, omdat deze duidelijke overeenstemming had met het beschermde personage van Ultraman. Iets verrassender was de bevinding dat de aanbieder van de dienst hiervoor aansprakelijk was. (Er moet een slordige €1200 aan schadevergoeding worden betaald.)
Het lijkt erop dat de reden vooral was het niet adequaat waarschuwen en optreden tegen inbreuken:
[T]he judgment specified that since users lack clear awareness of the potential copyright infringement risks to others, especially copyright owners, providers of generative AI services should remind users through service agreements. The court also ordered AI service providers to establish a complaint-reporting mechanism to assist rights holders in protecting their copyrights.
Een dergelijke uitspraak zou ook naar Europees recht logisch kunnen zijn. Goed verdedigbaar is dat zo’n generatieve AI-dienst valt onder wat de Digital Services Act een “platformdienst” noemt, met bijbehorende bescherming voor aansprakelijkheid. Die moeten echter wel adequate notice&action mechanismes hebben om klachten te ontvangen en af te handelen, en de voorwaarden van de dienst moeten duidelijk en in detail gemotiveerd aangeven wat er wel en niet mag en welke sanctie er bij overtreding kan volgen.
Fitnessketen Basic-Fit zet AI-gestuurde ‘slimme camera’s’ en sensoren in om agressie, ongeautoriseerde toegang, gezondheidsproblemen, zoals flauwvallen, en andere incidenten te herkennen. Dat meldde Security.nl onlangs. Technologieleverancier Axis spreekt van een “revolutionaire oplossing”, ik spreek van een interessant AI Act-vraagstuk.
Het is moeilijk op de Axis-site een uitleg te geven die niet leest als een ChatGPT tekst, maar bij deze:
Smart cameras that are used for their sensory-like functions and remote control mechanisms are deployed in each gym. The various Axis products work together with a specifically designed AI algorithm to quickly detect and address issues on site, while also enabling gyms to operate 24 hours a day. Gym members can therefore feel safe, even when there is no staff around. In case of need or an emergency, a specially designed remote control room can be contacted from the Basic-Fit location. From there health concerns, aggression, fraud, and even foot traffic is monitored.
De kern is dus “slimme camera’s” die aan emotieherkenning doen, en op basis daarvan alarmpjes geven aan een menselijk toezichthouder. En dat gaf mij dan weer een alarmpje, want ‘emotieherkenning’ is zeg maar een dingetje onder de AI Act die binnenkort van kracht wordt.
Emotieherkenning is een van de controversieelste toepassingen van AI/ML. Het idee is dat je door analyse van uiterlijke kenmerken kunt vaststellen hoe iemand zich voelt – plus dat je dat kunt terugbrengen tot een serie labels zoals vreugde, woede, angst, walging, minachting, verdriet en verrassing. Voor geen van deze twee dingen is wetenschappelijke consensus, maar door het in een computer te stoppen en die “AI” te noemen creëert men een sfeer dat dit een opgelost probleem is. Dus als de AI zegt dat persoon A “woedend” is, dan gaat er een bewaker naar de locatie om persoon A de-escalerend aan te spreken en te verwijderen.
Mag het? Op dit moment wel. De AVG regelt het een en ander over cameratoezicht (zie het reglement), en bevat daarnaast regels over profileren en automatische besluitvorming. Maar wat hier gebeurt, is nog geen besluitvorming. De AI stuurt er een mens op af, waarna de mens op locatie het besluit neemt (“oh nee, hij was stoom aan het afblazen omdat hij leg day niet ziet zitten”). De analyse wordt verder niet aan je klantprofiel gekoppeld en er wordt verder ook niets mee gedaan. AVG-technisch lijkt dit dus wel in orde.
De AI Act kijkt er wat anders tegenaan. Het is niet verboden – het verbod op emotieherkenning geldt alleen bij gebruik op het werk of in het onderwijs. Bij vrij sporten zoals hier, is dat niet aan de orde (de trainers/werknemers worden hier niet mee gemonitord). Het is wel een hoog-risico AI (artikel 1(ab) van Annex III), dus het triggert een berg eisen zoals een risicomanagementsysteem, uitgebreide logging, adequaat menselijk toezicht en marktmonitoring op incidenten.
De AI Act is nog niet formeel aangenomen (verwachting: april) dus het is niet raar dat Axis nog niets zegt over hoe ze aan de wet voldoet. Daar hebben ze net als iedereen nog (slechts) twee jaar voor, want op dat moment moeten alle aspecten opgezet zijn. En dat is minder tijd dan je denkt.
Een bijkomstigheid: op de Axis-pagina zie ik diverse producten zoals een domecamera of een intercom. Ik weet zeker dat daar het bekende CE-logo op zit. Vanaf het moment dat de AI Act van kracht is, gaat dat logo óók betekenen dat het product aan die wet voldoet.
Europese landen gebruiken in toenemende mate digitale technologieën om migratie in te perken, waardoor de kans op „discriminatie, racisme en disproportionele en onwettige surveillance” wordt vergroot. Dat las ik bij NRC vorige week. Men zet daar namelijk een AI-leugendetector in, en omdat ik dus de hele AI Act aan het doorakkeren ben wilde ik me hier even boos over maken.
Uit het artikel:
Sinds 2018 wordt het systeem in ieder geval gebruikt door Hongarije, Griekenland en Letland. Het systeem analyseert „details van gelaatsuitdrukkingen met behulp van gezichts- en emotieherkenningstechnologieën”. Het systeem „toetst” of migranten antwoorden over bijvoorbeeld hun herkomst naar waarheid beantwoorden. Er is geen wetenschappelijke consensus dat leugendetectors, ook die gerund worden door AI, betrouwbare resultaten afleveren.
Het betreffende systeem heet iBorderCtrl en komt uit een Europees researchproject dat al een paar jaar loopt. De kern is dat men een machine learning model heeft getraind om emotieherkenning te doen om zo de mate van eerlijkheid van antwoorden van migranten in te schatten.
Er is een zeer hardnekkige overtuiging dat als we maar goed genoeg ons best doen, het ons moet lukken om mensen eerlijk te beoordelen met een computersysteem. Waar dat vandaan komt weet ik niet (“techno-optimisme”) maar elke keer als je dan even verder kijkt wat erachter zit, dan schrik je je wezenloos.
Het model van iBorderCtrl kent bijvoorbeeld diverse factoren zoals “knippert met linkeroog” of “beweegt hoofd”, en als je genoeg van die factoren zou hebben dan zou je met hoge betrouwbaarheid de leugenaars van de eerlijkerds kunnen scheiden. Dat vereist “alleen maar” een dataset met leugenaars en eerlijkerds met een hoop van die factoren. Dit is een beetje lastig om in het wild voor elkaar te krijgen, al is het maar omdat het niet eenvoudig is leugenaars te betrappen.
Hoe loste men dat op? Ga even op de grond zitten want anders val je van je stoel:
To create the dataset, 32 participants (actors) were assigned a “truthful” or “deceptive” role to perform during the interview. Each participant had to answer 13 questions (see Table 1) with each answer segmented in many vectors. According to the authors, this procedure generated 86,586 vectors. The dataset consisted of 10 participants classified as having Asian/Arabic ethnic background and 22 as White European background, and 22 classified as male and 10 as female.
Inderdaad, we doen grenscontroles op basis van een ML-model dat met n=32 is opgebouwd waarbij de antwoorden geacteerd zijn. Was er iemand bij die zei dat dit een leuk idee was maar zeker niet in de praktijk ingezet kon worden?
De AI Act bepaalt dat systemen voor grenscontrole hoogrisico kunnen zijn, wanneer ze specifiek een van deze usecases betreffen:
Leugendetectors gebruikt door publieke autoriteiten
Risico-assessments bij grenscontroles
Onderzoek van visum- en asielaanvragen
Het detecteren, herkennen en identificeren van personen (behalve bij verificatie van reisdocumenten)
Een hoogrisico-AI moet aan strenge eisen voldoen, waaronder de eis van een kwalitatief goede dataset (artikel 10, lid 2-5). In de woorden van artikel 3:
Training, validation and testing datasets shall be relevant, sufficiently representative, and to the best extent possible, free of errors and complete in view of the intended purpose. They shall have the appropriate statistical properties, including, where applicable, as regards the persons or groups of persons in relation to whom the high-risk AI system is intended to be used.
Hoe je dat precies voor elkaar krijgt, leer je op mijn opleiding AI Compliance Officer, maar het moge duidelijk zijn dat dit systeem niet zal voldoen. Toch blijft het gewoon doorhobbelen, want de Europese IT-systemen voor grenscontroles zijn tot 2030(!) vrijgesteld van de plicht aan de AI Act te voldoen (artikel 83).
 De Guangzhou Internet Court heeft recent geoordeeld dat de uitvoer van een AI inbreuk op auteursrecht kan zijn, las ik