Pakje sigaretten kopen? Eerst even je gezicht scannen, mag dat?

(Bron: RTL Nieuws)

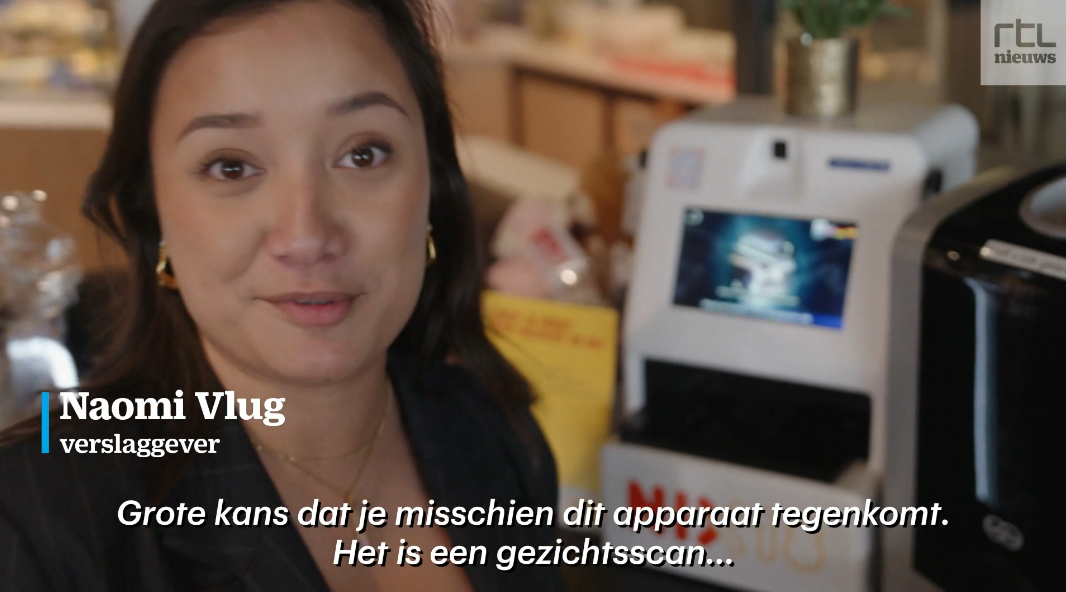
Wie een pakje sigaretten koopt, komt op steeds meer plekken in Nederland een gezichtsscanner tegen. Dat las ik bij RTL Nieuws onlangs. De scanner schat je leeftijd (25+ of niet) en laat je dan sigaretten kopen (of niet). Enkele rokende lezers stelden me vervolgens de vraag: mag dat eigenlijk wel, inzet van biometrie voor zo’n profileringsdoel? En vooral: wat zegt de aankomende AI Act?

De AI Act is definitief maar nog niet aangenomen (in mijn nieuwe boek lees je alle details). Dat zal in mei gebeuren. Daarna is er twee jaar overgangsrecht, hoewel de zogeheten verboden praktijken al over zes maanden moeten stoppen. En in die lijst (artikel 5) staan de nodige biometrische toepassingen:

  • Emotieherkenning op het werk en in het onderwijs, behalve indien noodzakelijk voor veiligheid of medische redenen (art. 5(1)(f)).
  • Biometrische categorisatie op bijzondere persoonsgegevens, zoals het afleiden van etnische afkomst of seksuele voorkeur (art. 5(1)(g)).
  • Real-time biometrie op afstand in de openbare ruimte voor wetshandhaving (art. 5(1)(h)))
Geen van deze drie is van toepassing op dit systeem. “25 jaar of ouder” zijn is geen bijzonder persoonsgegeven immers.

Diverse toepassingen van biometrie zijn als hoogrisico aangemerkt. De AI Act is daar formeel in; iets is hoogrisico als het op de lijst (Annex III) staat, je hoeft geen eigen inschatting te maken van hoe hoog of hoe ernstig het in jouw geval is. Pas je onder een tekst? Dan ben je hoogrisico.

De eerste toepassing is biometrie op afstand. De AI Act gebruikt hierbij niet een criterium uitgedrukt in meters, maar of je meerdere mensen tegelijkertijd scant (overweging 17, artikel 3 lid 41), met “typisch op afstand” als optionele toevoeging.

De tweede toepassing is emotieherkenning (dus niet op werk of school). Dit is niet van toepassing, want leeftijd is geen emotie.

Blijft over biometrische categorisatie op basis van gevoelige of beschermde kenmerken. Dit komt goed in de buurt: de categorieën zijn dan “25 jaar of ouder” versus “jonger dan 25”, en dit gebeurt op basis van gezichtskenmerken die goed ‘gevoelig’ kunnen zijn. Daarmee moet de leverancier aan een hele berg compliance-verplichtingen voldoen.

Die 25 jaar is overigens gekozen om de foutmarge naar 2% terug te dringen: het verschil zien tussen 17 en 19 is te subtiel kennelijk.

Waar ik vooral mee zit: de gezichtsscan duurt zo te zien op het filmpje minstens zo lang als een ID-kaartscan. (De leverancier spreekt van “rap” maar ik zie echt het tijdsverschil niet.) Je ID moet je altijd kunnen laten zien. Wat is dan precies nog het praktische voordeel van deze AI oplossing ten opzichte van altijd ID laten zien?

Arnoud

Chinese rechtbank ziet AI-gegenereerde kunst als inbreuk op auteursrecht

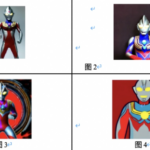
De Guangzhou Internet Court heeft recent geoordeeld dat de uitvoer van een AI inbreuk op auteursrecht kan zijn, las ik in de Global Times. De rechthebbende had ontdekt dat als je vroeg om plaatjes van zijn werk – Ultraman – je dan plaatjes kreeg die auteursrechtelijk gezien inbreukmakend waren. De AI-dienst is daarvoor aansprakelijk, zo bepaalde de rechter.

Helaas is de naam van de AI-plaatjesdienst niet te vinden, maar de eiser is de rechthebbende op de Japanse Ultraman franchise, en die had dus zelf ontdekt dat vragen om plaatjes van dat werk (zie plaatje, klik voor groter) je de ‘echte’ Ultraman kreeg.

Niet heel raar zou je zeggen: je vraagt om X en je krijgt X, dat voelt de bedoeling van een computersysteem. Maar specifiek als X onder iemands auteursrecht (of merk) valt, is dit een tikje problematisch. Auteursrechtelijk gezien mag je ook niet een illustrator vragen om zo’n afbeelding te maken, immers.

Uniek is het niet: in januari verscheen een artikel in de New York Times waarbij men ‘ontdekte’ dat als je vraagt om “popular movie screencap Joker” je een afbeelding van Batman-personage The Joker krijgt die erg sterk lijkt op de wijd en zijd gepubliceerde foto van Joaquin Phoenix in die rol. Maar dit is wel de eerste keer dat een rechtbank dit ook als inbreuk ziet.

De rechtbank in Guangzhou oordeelde d dat de afbeelding inbreukmakend was, omdat deze duidelijke overeenstemming had met het beschermde personage van Ultraman. Iets verrassender was de bevinding dat de aanbieder van de dienst hiervoor aansprakelijk was. (Er moet een slordige €1200 aan schadevergoeding worden betaald.)

Het lijkt erop dat de reden vooral was het niet adequaat waarschuwen en optreden tegen inbreuken:

[T]he judgment specified that since users lack clear awareness of the potential copyright infringement risks to others, especially copyright owners, providers of generative AI services should remind users through service agreements. The court also ordered AI service providers to establish a complaint-reporting mechanism to assist rights holders in protecting their copyrights.
Een dergelijke uitspraak zou ook naar Europees recht logisch kunnen zijn. Goed verdedigbaar is dat zo’n generatieve AI-dienst valt onder wat de Digital Services Act een “platformdienst” noemt, met bijbehorende bescherming voor aansprakelijkheid. Die moeten echter wel adequate notice&action mechanismes hebben om klachten te ontvangen en af te handelen, en de voorwaarden van de dienst moeten duidelijk en in detail gemotiveerd aangeven wat er wel en niet mag en welke sanctie er bij overtreding kan volgen.

Arnoud

Basic-Fit zet camera’s in die gezondheidsproblemen en agressie detecteren

edwardbrownca / Pixabay

Fitnessketen Basic-Fit zet AI-gestuurde ‘slimme camera’s’ en sensoren in om agressie, ongeautoriseerde toegang, gezondheidsproblemen, zoals flauwvallen, en andere incidenten te herkennen. Dat meldde Security.nl onlangs. Technologieleverancier Axis spreekt van een “revolutionaire oplossing”, ik spreek van een interessant AI Act-vraagstuk.

Het is moeilijk op de Axis-site een uitleg te geven die niet leest als een ChatGPT tekst, maar bij deze:

Smart cameras that are used for their sensory-like functions and remote control mechanisms are deployed in each gym. The various Axis products work together with a specifically designed AI algorithm to quickly detect and address issues on site, while also enabling gyms to operate 24 hours a day. Gym members can therefore feel safe, even when there is no staff around. In case of need or an emergency, a specially designed remote control room can be contacted from the Basic-Fit location. From there health concerns, aggression, fraud, and even foot traffic is monitored.
De kern is dus “slimme camera’s” die aan emotieherkenning doen, en op basis daarvan alarmpjes geven aan een menselijk toezichthouder. En dat gaf mij dan weer een alarmpje, want ‘emotieherkenning’ is zeg maar een dingetje onder de AI Act die binnenkort van kracht wordt.

Emotieherkenning is een van de controversieelste toepassingen van AI/ML. Het idee is dat je door analyse van uiterlijke kenmerken kunt vaststellen hoe iemand zich voelt – plus dat je dat kunt terugbrengen tot een serie labels zoals vreugde, woede, angst, walging, minachting, verdriet en verrassing. Voor geen van deze twee dingen is wetenschappelijke consensus, maar door het in een computer te stoppen en die “AI” te noemen creëert men een sfeer dat dit een opgelost probleem is. Dus als de AI zegt dat persoon A “woedend” is, dan gaat er een bewaker naar de locatie om persoon A de-escalerend aan te spreken en te verwijderen.

Mag het? Op dit moment wel. De AVG regelt het een en ander over cameratoezicht (zie het reglement), en bevat daarnaast regels over profileren en automatische besluitvorming. Maar wat hier gebeurt, is nog geen besluitvorming. De AI stuurt er een mens op af, waarna de mens op locatie het besluit neemt (“oh nee, hij was stoom aan het afblazen omdat hij leg day niet ziet zitten”). De analyse wordt verder niet aan je klantprofiel gekoppeld en er wordt verder ook niets mee gedaan. AVG-technisch lijkt dit dus wel in orde.

De AI Act kijkt er wat anders tegenaan. Het is niet verboden – het verbod op emotieherkenning geldt alleen bij gebruik op het werk of in het onderwijs. Bij vrij sporten zoals hier, is dat niet aan de orde (de trainers/werknemers worden hier niet mee gemonitord). Het is wel een hoog-risico AI (artikel 1(ab) van Annex III), dus het triggert een berg eisen zoals een risicomanagementsysteem, uitgebreide logging, adequaat menselijk toezicht en marktmonitoring op incidenten.

De AI Act is nog niet formeel aangenomen (verwachting: april) dus het is niet raar dat Axis nog niets zegt over hoe ze aan de wet voldoet. Daar hebben ze net als iedereen nog (slechts) twee jaar voor, want op dat moment moeten alle aspecten opgezet zijn. En dat is minder tijd dan je denkt.

Een bijkomstigheid: op de Axis-pagina zie ik diverse producten zoals een domecamera of een intercom. Ik weet zeker dat daar het bekende CE-logo op zit. Vanaf het moment dat de AI Act van kracht is, gaat dat logo óók betekenen dat het product aan die wet voldoet.

Arnoud

Amnesty: Europese landen gebruiken dubieuze AI-technologieën bij grensbewaking

a couple of men standing on top of a lush green field
Photo by Carl Tronders on Unsplash

Europese landen gebruiken in toenemende mate digitale technologieën om migratie in te perken, waardoor de kans op „discriminatie, racisme en disproportionele en onwettige surveillance” wordt vergroot. Dat las ik bij NRC vorige week. Men zet daar namelijk een AI-leugendetector in, en omdat ik dus de hele AI Act aan het doorakkeren ben wilde ik me hier even boos over maken.

Uit het artikel:

Sinds 2018 wordt het systeem in ieder geval gebruikt door Hongarije, Griekenland en Letland. Het systeem analyseert „details van gelaatsuitdrukkingen met behulp van gezichts- en emotieherkenningstechnologieën”. Het systeem „toetst” of migranten antwoorden over bijvoorbeeld hun herkomst naar waarheid beantwoorden. Er is geen wetenschappelijke consensus dat leugendetectors, ook die gerund worden door AI, betrouwbare resultaten afleveren.
Het betreffende systeem heet iBorderCtrl en komt uit een Europees researchproject dat al een paar jaar loopt. De kern is dat men een machine learning model heeft getraind om emotieherkenning te doen om zo de mate van eerlijkheid van antwoorden van migranten in te schatten.

Er is een zeer hardnekkige overtuiging dat als we maar goed genoeg ons best doen, het ons moet lukken om mensen eerlijk te beoordelen met een computersysteem. Waar dat vandaan komt weet ik niet (“techno-optimisme”) maar elke keer als je dan even verder kijkt wat erachter zit, dan schrik je je wezenloos.

Het model van iBorderCtrl kent bijvoorbeeld diverse factoren zoals “knippert met linkeroog” of “beweegt hoofd”, en als je genoeg van die factoren zou hebben dan zou je met hoge betrouwbaarheid de leugenaars van de eerlijkerds kunnen scheiden. Dat vereist “alleen maar” een dataset met leugenaars en eerlijkerds met een hoop van die factoren. Dit is een beetje lastig om in het wild voor elkaar te krijgen, al is het maar omdat het niet eenvoudig is leugenaars te betrappen.

Hoe loste men dat op? Ga even op de grond zitten want anders val je van je stoel:

To create the dataset, 32 participants (actors) were assigned a “truthful” or “deceptive” role to perform during the interview. Each participant had to answer 13 questions (see Table 1) with each answer segmented in many vectors. According to the authors, this procedure generated 86,586 vectors. The dataset consisted of 10 participants classified as having Asian/Arabic ethnic background and 22 as White European background, and 22 classified as male and 10 as female.
Inderdaad, we doen grenscontroles op basis van een ML-model dat met n=32 is opgebouwd waarbij de antwoorden geacteerd zijn. Was er iemand bij die zei dat dit een leuk idee was maar zeker niet in de praktijk ingezet kon worden?

De AI Act bepaalt dat systemen voor grenscontrole hoogrisico kunnen zijn, wanneer ze specifiek een van deze usecases betreffen:

  1. Leugendetectors gebruikt door publieke autoriteiten
  2. Risico-assessments bij grenscontroles
  3. Onderzoek van visum- en asielaanvragen
  4. Het detecteren, herkennen en identificeren van personen (behalve bij verificatie van reisdocumenten)
Een hoogrisico-AI moet aan strenge eisen voldoen, waaronder de eis van een kwalitatief goede dataset (artikel 10, lid 2-5). In de woorden van artikel 3:
Training, validation and testing datasets shall be relevant, sufficiently representative, and to the best extent possible, free of errors and complete in view of the intended purpose. They shall have the appropriate statistical properties, including, where applicable, as regards the persons or groups of persons in relation to whom the high-risk AI system is intended to be used.
Hoe je dat precies voor elkaar krijgt, leer je op mijn opleiding AI Compliance Officer, maar het moge duidelijk zijn dat dit systeem niet zal voldoen. Toch blijft het gewoon doorhobbelen, want de Europese IT-systemen voor grenscontroles zijn tot 2030(!) vrijgesteld van de plicht aan de AI Act te voldoen (artikel 83).

Arnoud


Japanse overheid wijzigt regelgeving die gebruik van diskettes verplicht

“rainbow diskettes, IBM formatted” by frankieleon is licensed under CC BY 2.0

Het Japanse ministerie van Economie, Handel en Industrie heeft allerlei regelgeving aangepast die het gebruik van diskettes en cd-roms verplicht. Dat las ik bij Security.nl. De aangepaste verordeningen gebruiken nu techniekneutrale benamingen.

Waarom is mij niet duidelijk, maar Japan bleek bijna 2000 wetten en regels te hebben waarin expliciet naar floppydisks werd verwezen. De BBC legt uit:

This is not the first time Japan has hit the headlines for its old-fashioned habits – which remain a paradox given the country’s proficiency at developing exciting new products. Various explanations have been offered, including poor digital literacy and a bureaucratic culture with conservative attitudes.
Mijn gok zou zijn dat dit als stoffig detail in een wet staat en niemand zin had om daar een punt van te maken. Het gaat toch goed? Ik zie niemand op straat demonstreren. Nou dan.

Veel mensen linktipten me dit bericht vanuit een motivatie van “haha gekke juristen zijn zo ouderwets”. Dat zal zeker ook mee hebben gespeeld – maar de reden om zo ouderwets te doen is vaak simpel: (a) het werkt, (b) we weten dat het rechtsgeldig is. Dat moeten we met jouw flitsende app nog maar zien, en die floppy disk heeft géén ellenlange uitsluiting van aansprakelijkheid.

In Nederland hebben we nooit expliciete regels over floppy’s als verplicht medium gehad. Ja, er was de Aangiftediskette die in 2008 ‘abrupt’ werd afgeschaft, maar dat was een optie en geen plicht. De beste analogie is volgens mij de fax, die in 2021 bij de Rechtspraak als laatste werd afgeschaft. Ik schreef toen:

De overstap van post naar fax was destijds al een grote stap. Ik kon niet precies achterhalen wat de eerste uitspraak was waarin faxverkeer als rechtsgeldig werd erkend, de strafzaak HR 13 september 1988, NJ1989,12 lijkt de eerste uitspraak te zijn geweest. Hierin stond ter discussie of een gefaxte pleitnota wel rechtsgeldig ondertekend was door de advocaat. Immers, hoe controleer je de echtheid van een korrelig plaatje? Gelukkig was de advocaat-generaal van de HR behulpzaam:
Nodig is dat de advocaat telefonisch of schriftelijk aan de griffie van de HR laat weten dat de gefotocopieerde handtekening zijn handtekening is. Waar zo een nadere mededeling ontbreekt zal slechts een toevallige omstandigheid, zoals de aanwezigheid in het dossier van een brief van de indienende advocaat met diens originele handtekening en de mogelijkheid om de overeenkomst van die handtekeningen zonder moeite vast te stellen, de schriftuur met de gefotocopieerde of ‘gefaxte’ handtekening kunnen redden.
In andere zaken werd vergelijkbaar geoordeeld, waarbij ook wel als argument werd geaccepteerd dat je het origineel naleverde en dat men achteraf kon zien dat dit identiek was aan de fax. Dan heb je je origineel maar kan het allemaal net wat sneller. Daar kon niemand op tegen zijn, maar zeker woog ook mee dat professionele procespartijen zoals advocaten of rechters er geen belang bij zouden hebben om vervalste faxen te sturen. De kans op vervalsingen zou dus klein genoeg zijn.
Japan lijkt vergelijkbaar te hebben geoordeeld, waarbij informatiebeveiliging een argument was. Een floppy per koerier is immers lastiger te hacken dan een internetverbinding.

Arnoud

Populaire AI-tools geven juridische antwoorden vol fouten, joh wat dacht je zelluf

jambulboy / Pixabay

Chatbots van OpenAI, Google en Meta zijn zeer gevoelig voor ‘hallucinaties’ bij het beantwoorden van juridische vragen, zo las ik bij Advocatie. Men baseert zich op onderzoek van Stanford University, dat bij juridische vragen in driekwart van de antwoorden fouten vond. Fascinerend, maar het betekent hooguit dat je geen generieke chatbot voor een specifieke taak moet gebruiken.

Op voorhand ben ik altijd erg kritisch op onderzoeken die zich baseren op GPT-3.5, zeg maar de gratis versie van ChatGPT. De verschillen tussen 3.5 en 4 zijn echt enorm. Maar hier gaat het specifiek om de kwestie van juridische vragen in een algemeen taalmodel. En dan is het natuurlijk redelijk logisch dat daar rare, algemene antwoorden uit komen: al die juridische kennis zit niet in de dataset.

Maar belangrijker: generatieve AI is geen orakel dat antwoorden genereert op basis van een analyse van de vraag. Het zijn stochastische papegaaien, patroonzoekers die een leuk klinkende tekst produceren die redelijk aansluit op de invoerprompt. Of die vraag enige relatie heeft tot de werkelijkheid, is daarbij volkomen irrelevant.

Dit krijg je pas anders als je zo’n systeem voedt met specifieke juridische kennis, want dan kan het systeem in ieder geval de benodigde kennis reproduceren om het antwoord mee aan te kleden. Maar strak afstellen blijft noodzakelijk, zoals het DPD chatbot-incident laat zien.

Het probleem is dus eigenlijk fundamenteler: we gebruiken een tekstgenerator om antwoorden te zoeken. Dat is natuurlijk omdat die generatoren nu de hypewind mee hebben, maar eigenlijk is het raar. Er zijn genoeg juridische kennissystemen die wél gericht encorrect antwoorden op juridische vragen kunnen oplepelen. Koppel die dan aan zo’n tekstgenerator om het mooi te maken, zou je zeggen. Maar dat laat nog even op zich wachten.

Arnoud


Koninklijke Bibliotheek beperkt toegang tot collecties voor trainen commerciële AI

digitization, transformation, earth
Photo by geralt on Pixabay

De KB (nationale bibliotheek) wil niet dat commerciële bedrijven zonder toestemming digitale bronnen gebruiken voor het trainen van AI en heeft daarom de toegang tot collecties beperkt. Dat las ik bij Security.nl. In een verklaring verwijst men naar de “wijze waarop veel commerciële AI-modellen nu getraind worden – door zonder toestemming websites te crawlen”, die niet in het algemeen belang zou zijn.

De KB heeft een van de grootste Nederlandstalige collecties online staan, wat haar een dankbare bron maakt voor partijen die taalmodellen willen trainen. Hoe meer data hoe beter je uitvoerkwaliteit immers. Auteursrechthebbenden hebben hier moeite mee, want waarom moet daar niet voor worden betaald?

De Europese wetgever heeft een paar jaar terug een soort-van compromis in de wet opgenomen: gebruik van werk voor “text and data mining” (TDM) is wettelijk toegestaan (dus zonder vergoeding) tenzij een site een opt-out vermeldt. Die opt-out moet machineleesbaar zijn, omdat het anders geen doen is voor TDM dataverzamelaars.

Hoewel dit principieel en technisch onjuist is, is de trend om in robots.txt die opt-out te gaan coderen. Robots.txt is bedoeld om zoekmachinecrawlers buiten plekken te houden waar ze schade kunnen berokkenen of waar liever-niet content staat zoals stylesheets of grote bestanden die toch niet relevant zijn.

Het grote probleem is dat je met robots.txt kunt kiezen om álle robots ergens weg te houden, of alleen de genoemde robots. Je zou dus die van OpenAI kunnen blokkeren, maar dan heb je die van Bing nog niet. Blokkeer je Bing erbij, dan is er kennelijk geen bezwaar tegen mijn EngelfrietGPT-bot. En álles blokkeren betekent dat ook de zoekspider van Google er niet meer bij mag.

Er zijn ook uitgevers zoals The Guardian die in het commentaar van de robots.txt gebruik voor LLM verbieden. Dat is per definitie geen machineleesbare opt-out, want commentaar behoort een spider niet te lezen. Dat is dus zo’n geval “we moeten iets doen en dit is iets, dus laten we het doen”. Maar het komt mét Engelse advocaat die je heel welbespraakt gaat uitleggen waarom je toch echt onrechtmatig en zelfs strafbaar handelt door het te negeren.

De KB volgt desondanks deze trend door in de robots.txt van digitale collecties DBNL en Delpher de OpenAI bots (GPTBot en ChatGPT-User) toegang te ontzeggen. Dit is dus het probleem: de bot van Bing is niet uitgesloten, noch die van bijvoorbeeld Common Crawl om het over EngelfrietGPT maar niet te hebben.

En ja, in de gebruiksvoorwaarden staat ook een expliciet voorbehoud:

Voor commerciële partijen is het verboden om kopieën van auteursrechtelijk beschermde werken op onze website te maken ten behoeve van tekst- en datamining (TDM) waaronder training van AI-modellen. Dit verbod vormt een voorbehoud als bedoeld in artikel 15o Auteurswet en artikel 4(3) CDSM-richtlijn.
Dit is dus alleen niet rechtsgeldig als verbod, omdat het niet machineleesbaar is.

Natuurlijk, in de praktijk zal het vooral gaan om hoe strak men de toegang afschermt voor commerciële bots. Maar ik kan me dood ergeren aan dit soort maatregelen die gewoon principieel niet kloppen.

Arnoud

New York Times klaagt OpenAI aan om misbruik artikelen voor trainen van AI

The New York Times heeft OpenAI en Microsoft aangeklaagd voor het schenden van NYT’s auteursrecht. Dat meldde Tweakers in de kerstvakantie. De GPT taalmodellen van OpenAI zijn (mede) getraind op NYT-content, en met wat goed prompten kun je zelfs originele artikelen terugkrijgen, maar om het nou een kopieerapparaat te noemen? De vraag is dan ook fundamenteel: hóórt dit inbreuk op het auteursrecht te zijn?

De achterliggende reden is even banaal is veelvoorkomend: in april heeft de NYT onderhandeld met OpenAI en Microsoft om een betaalde licentiedeal te sluiten, maar dat is op niets uitgelopen. Er zijn meerdere van zulke gesprekken geweest, maar de details zijn schimmig. Het is goed gebruik dat als je onderhandelingen klappen, je naar de rechter stapt om ronde twee te initiëren met een miljardenclaim. (In de VS is auteursrechtelijke schade een vast bij wet vastgelegd bedrag, dus dat rekent makkelijk.)

Hoe toon je aan dat jouw content in de dataset zit waarmee GPT getraind is? Daar blogde ik in 2022 over: er zijn diverse trucs maar zekerheid heb je niet, want die diensten houden stevig de kaken op elkaar natuurlijk. Alleen bij de NYT ligt dat anders, want miljoenen van hun artikelen zijn opgenomen in de Common Crawl-dataset, de grootste dataset waarmee AI systemen worden getraind. En ook staat vast dat GPT getraind is met Common Crawl.

NYT ging nog een stapje verder: met een goed gekozen prompt krijg je gehele NYT artikelen eruit. Die “goed gekozen prompt” is dan wel de lead van het NYT artikel dat je wilde hebben, dus het voelt een tíkje sturend, en bovendien krijg je 95% van de originele tekst terug via de patroonherkenning die het LLM maakt. Het is geen kopieerapparaat maar een “raad het volgende woord” systeem, en dat wordt dan gedwongen om te raden met een zeer beperkte keuzevrijheid. LLMs slaan geen bronteksten op.

Is dat auteursrechtinbreuk? Voor mij voelt dat raar: OpenAI zoekt patronen in teksten, en gebruikt dat om nieuwe teksten te genereren. Dat is volkomen onvergelijkbaar met alle eerdere vormen van inbreuk die dankzij internet/ict mogelijk zijn gemaakt – die gingen allemaal over reproductie van de brontekst, zoals bij zoekmachines die snippets laten zien of torrentsites die helpen fragmenten te verzamelen. LLMs reproduceren de brontekst niet.

Dat roept natuurlijk het fairness argument op dat als jij miljoenen van iemands artikelen gebruikt om een systeem op te bouwen, die iemand daarvoor gecompenseerd zou moeten worden. Maar het auteursrecht is niet zo breed dat ieder gebruik of ieder voortbouwen op een werk automatisch inbreuk is, althans juridisch niet. De aanklacht van de NYT leunt zwaar op “journalistiek kost heel veel geld dus is het fair dat wij een vergoeding van OpenAI krijgen”, maar dat is geen juridisch argument.

Binnen de wet krijg je dan discussie hoe je termen als ‘openbaarmaking’ of ‘werk’ moet interpreteren in de context van dit soort verwerking van de data daaruit. Deze rechtszaak zou daar een gezaghebbend antwoord op kunnen geven – hoewel ik vrij zeker weet dat er geschikt wordt voordat het zover is, want OpenAI en Microsoft hebben al het geld (market cap 350x die van NYT) en de NYT heeft natuurlijk principes maar daar kan de kachel niet van branden.

Arnoud


Hand opsteken als je op je verjaardag een AI Act cadeau krijgt

De AI Act komt er definitief, al is het nog spannend wanneer precies. In een marathonsessie (22uur, pauze, 14uur) is de Europese wetgever eruit gekomen op alle belangrijke punten. De definitieve tekst moet nog afgerond, maar dit is wat we nu weten.

Het grootste deel van de discussie ging op aan de vraag hoe biometrie op afstand te reguleren, met name omdat politie en veiligheidsdiensten daar graag gebruik van willen maken maar dat op gespannen voet staat met mensenrechten. Uiteindelijk is gekozen voor een verbod met enkele uitzonderingen: bestrijding terrorisme, gericht volgen van een verdachte en opsporing van ernstige misdrijven. Of daarmee de risico’s van predictive policing zijn weggenomen, betwijfel ik zeer.

De definitie van een AI is overgenomen van de OECD, en komt neer op “alle autonoom opererende systemen waarvan de uitvoer direct van invloed is op de omgeving”. Welke technologie er achter zit, is dus niet relevant, net als of de AI standaard is of zeer vernieuwend. Het gaat erom of het ding zelfstandig in de rondte mag slaan.

Als iets aan die definitie voldoet, is de volgende vraag of dat fysiek in de EU gebeurt of dat de uitvoer bedoeld is om in de EU te gebruiken. Zo ja, dan is de AI Act van toepassing. En dan komen we gelijk bij de vraag hoe erg de risico’s van deze AI zijn.

De strengste regel is voor de engste vormen van AI. “Verboden praktijken” moeten binnen zes maanden na inwerkingtreding van de AI Act (beoogd is januari) volledig stoppen. Hieronder vallen onder meer onbewuste manipulatie, social credit scoring en realtime biometrie op afstand. Nieuw is een verbod op emotieherkenning op het werk, zoals bij assessments van sollicitanten of het monitoren van personeel (tenzij het gaat om veiligheidsscans zoals bij slapende machinisten).

De ‘lichtste’ vormen van AI kennen geen bijzondere risico’s en krijgen alleen transparantieplichten opgelegd. Kort gezegd moeten deze duidelijk aangeven dat ze AI zijn (“Dag, ik ben een chatbot, hoe kan ik u helpen?”). Ook hun uitvoer moet gemarkeerd zijn als van AI afkomstig, maar het is nog niet duidelijk of dit zou betekenen dat alle AI-gegenereerde tekst of beeld een watermerk moet krijgen.

De meeste aandacht gaat uit naar de “hoog risico” AI, AI systemen die bijzondere risico’s voor mens of maatschappij opleveren. Dat kan variëren van discriminatie van personen tot fysiek letsel, fouten bij het bereiden van voedsel of het vervuilen van het milieu door een verkeerde inschatting. Allereerst moet hierbij een fundamental rights impact assessment of FRIA worden uitgevoerd. En als dat gedaan is, dan kan het echte werk beginnen: kwaliteitsborging, verantwoordingsprocessen, documentatie, logging en menselijk toezicht op hun inzet. De inzet van een aparte AI Compliance Officer is dan ook zeer aan te raden.

Ook is veel aandacht gegaan naar de zogeheten foundation modellen, de algemene modellen zoals Google’s Bard of ChatGPT. Deze kunnen alles, en zijn dus niet aan een specifiek risico te koppelen. Aanbieders hiervan krijgen basisverplichtingen over transparantie en het aanpakken van generieke risico’s op zich, maar een aanbieder die zo’n foundation model inzet voor een specifieke toepassing moet zélf de uiteindelijke verantwoording dragen. Een aanbieder van bijvoorbeeld een contractenscanner die met ChatGPT teksten analyseert, moet zelf de kwaliteit van de contractenscanning borgen en mag niet simpelweg vertrouwen op wat ChatGPT kan.

Open source modellen zijn in principe uitgesloten van de AI Act. Dit betreft modellen die onder een open of vrije licentie gedeeld worden en waarvan de broncode en de parameters openbaar zijn voor een ieder. Veel innovatie drijft op dergelijke modellen, en hiermee blijft bijvoorbeeld wetenschappelijk onderzoek mogelijk. Wanneer een open source model specifiek ingezet wordt voor een hoog risico toepassing, gaat echter wél de AI Act gewoon gelden.

De boetes zijn niet mals: tot 35 miljoen euro per overtreding of 7% van de wereldwijde omzet van het concern waarbinnen de overtreding wordt gemaakt. Voor ‘kleine’, administratieve overtredingen is dit 7,5 miljoen of 1.5%. Naast deze boetes kunnen de toezichthouders ook bevelen dat een specifieke AI-toepassing wordt bijgesteld of van de markt gehaald.

De beoogde datum van inwerkingtreding was 1 januari 2024, maar omdat er nog flink aan de tekst gesleuteld moet worden om alle compromissen te verwerken én omdat alles in 24 talen vertaald moet worden, is het zeer de vraag of dit gehaald wordt. De bedoeling is dan wel zo snel mogelijk daarna de wet te publiceren.

Er is beperkt overgangsrecht: de verboden praktijken moeten dus binnen 6 maanden stoppen, maar voor de hoog risico AI’s geldt een (sommige bronnen: twee) jaar overgangsrecht waarbinnen alle compliance vereisten moeten zijn verwerkt. Dat is korter dan je denkt: tuig maar eens een data-kwaliteitssysteem op als dat er nog geheel niet is.

Er is van vele kanten kritiek geuit op de AI Act. Enerzijds dat er niet streng genoeg wordt opgetreden tegen de grote risico’s van deze nieuwe technologie, en anderzijds dat regulering juist de innovatie geheel de nek om zal draaien.

Wat dat laatste betreft: ik geloof er niet in dat innovatie alleen goed mogelijk is als er nul regulering is. Ja, je krijgt méér experimenten, maar veel daarvan geven eerder gevaar dan voordeel voor de maatschappij. Het gaat immers niet om hoe geavanceerd de technologie is, maar om autonome inzet – een zelfrijdende auto kan mensen aanrijden, en of dat nou komt door een pulsed neural netwerk dat verkeerde conclusies trok of een beslisboom die niet voorzag in het concept “bakfiets” is volstrekt irrelevant.

Het voor mij grootste probleem zit hem in die hoogrisicotoepassingen, met name omdat dit vaak zwakkere groepen raakt. Werknemers die worden gescreend en beoordeeld door AI, zonder daar weerwoord tegen te kunnen geven. Burgers die geen ambtenaar maar een AI tegenover zich zien en dan hun bijzondere omstandigheden niet kwijt kunnen. Mensen die door een politie-AI worden ‘herkend’ en gevolgd, zonder dat zij dit weten of kunnen klagen dat die herkenning ten onrechte is. Dát is het probleem dat de AI Act probeert op te lossen.

Arnoud PS, jaja, 0x31 alweer vandaag, dank u dank u.
 

Gaat de VS Europa links inhalen met haar AI regulering?

Met een presidentieel decreet wil de Amerikaanse president Joe Biden toekomstige AI-modellen van vangrails voorzien. Dat las ik bij De Tijd dinsdag. Het nieuws komt een week nadat de Europese wetgever er nog niet uit is met de AI Act, dus het is nogal een verrassing: krijgt de VS nu ineens méér regulering dan Europa?

De Wall Street Journal noemt de Executive Order van Biden (want dat is het) een “emergency federal power”. Want Biden kan als president geen wetten invoeren. Met een executive order of decreet kan hij de federale overheidsorganen aansturen, wat indirect behoorlijk wat impact op de maatschappij kan hebben.

Eerder had het Witte Huis al een “Blueprint for an AI Bill of Rights” uitgegeven, een streven met vijf beginselen voor wat wij trustworthy AI zouden noemen. Biden maakt in zijn XO daar nu acht uitgangspunten van. Ik citeer de belangrijkste passage van iedere, namelijk het punt waar hij ingaat op wat zijn overheidsorganen gaan doen:

  1. My Administration will help develop effective labeling and content provenance mechanisms, so that Americans are able to determine when content is generated using AI and when it is not.
  2. The Federal Government will promote a fair, open, and competitive ecosystem and marketplace for AI and related technologies so that small developers and entrepreneurs can continue to drive innovation.
  3. My Administration will seek to adapt job training and education to support a diverse workforce and help provide access to opportunities that AI creates.
  4. Ty Administration will build on the important steps that have already been taken […] in seeking to ensure that AI complies with all Federal laws and to promote robust technical evaluations, careful oversight, engagement with affected communities, and rigorous regulation.
  5. The Federal Government will enforce existing consumer protection laws and principles and enact appropriate safeguards against fraud, unintended bias, discrimination, infringements on privacy, and other harms from AI.
  6. The Federal Government will ensure that the collection, use, and retention of data is lawful, is secure, and mitigates privacy and confidentiality risks.
  7. My Administration will take steps to attract, retain, and develop public service-oriented AI professionals (…)   The Federal Government will work to ensure that all members of its workforce receive adequate training (…).
  8. My Administration will engage with international allies and partners in developing a framework to manage AI’s risks, unlock AI’s potential for good, and promote common approaches to shared challenges.
Allemaal zaken die de overheid zelf gaat regelen dus. Burgers en bedrijven hebben daar niet direct mee te maken, behalve als ze willen verkopen aan de overheid. Nog steeds niet spannend, een overheid kan inkoopvoorwaarden hanteren immers.

Wél spannend wordt het wanneer Biden de Defense Production Act uit 1950 inroept. Deze wet is aangenomen aan het begin van de Korea-oorlog en geeft de president de bevoegdheid om producten onder de DPA te scharen wanneer dat noodzakelijk is voor de nationale veiligheid.

Biden rekent daar nu de enorme foundation models onder die het leeuwendeel van de nieuwe AI uitmaken, zoals GPT4 en Google’s modellen. De insteek is dat deze ook voor kwaadaardige cyberactiviteit ingezet kunnen worden, waarmee de VS kwetsbaarder wordt jegens buitenlandse actoren. Wederverkoop of IaaS-levering van zulke modellen aan buitenlanders wordt hiermee gereguleerd, de minister van Handel mag ingrijpen als zo’n transactie onwenselijk is vanuit de staatsveiligheid en inzet van AI in kritieke sectoren wordt aan overheidstoezicht onderworpen en zo nog het een en ander.

Opmerkelijk is vooral de eis aan generative AI: veel media melden dat generatoren hun content moeten gaan watermerken. Dat staat er niet: er komt onderzoek naar effectieve technieken om ‘synthetische’ content te kunnen onderscheiden van echte, en daaruit wordt dan een standaard afgeleid. Maar buiten de bovengenoemde scope kan de president private partijen niet bevelen uitvoer van hun tooling te watermerken.

De XO is natuurlijk wel een enorm sterk signaal dat er regulering aan zit te komen, en omdat alle grote AI providers ook willen leveren aan de overheid is de kans groot dat men deze standaarden gaat ondersteunen in ál hun producten en diensten. In combinatie met de AI Act die we in januari verwachten, levert dat in 2024 ineens een enorme regulering op van de wildwestsector die we nu hebben.

Arnoud