Virale AI-tool kloont razendsnel betaalde softwareprogramma’s, mag dat?

Photo by Craig Adderley on Pexels

‘Reverse Engineer Anything’ stelt gebruikers in staat om de code van elke software te analyseren en op de kopieermachine te leggen. Dat meldde Quote gisteren. REA is een taalmodel verbonden aan bekende reverse engineering tools en je kunt zo alle software namaken. Mag dat?

REA gebruikt bekende tools voor decompilatie en disassemblage (zoals Ghidra), met als bijzondere toevoeging dat een set agents via MCP de boel aanstuurt zodat je niet handmatig al dat werk hoeft te doen. Het ziet er bijzonder handig en toegankelijk uit, maar in mijn tijd moest ik met Edlin assembly zien te bewerken dus wie ben ik.

Reverse engineering is auteursrechtelijk natuurlijk problematisch. Grofweg mag je observeren hoe software werkt, zodat je dat ook kunt doen, en mag je file formats uitpluizen zodat je een compatibele lezer of schrijver kunt maken. Maar wat niet mag, is broncode uit elkaar halen en opnieuw in elkaar zetten (behalve voor bug fixes).

Er verandert natuurlijk niets als je het proces laat orchestreren door vergaand autonoom opererende scripts, pardon AI agents. Het gaat vooral veel sneller en we zien minder goed wat de tussenstappen waren. Maar dat is geen reden om het ineens legaal te noemen. Software decompileren en een kloon daarmee maken is vrijwel altijd inbreuk.

Quote noemt als voorbeeld de ArtCraft-suite, open source varianten van zo’n twaalf Adobe- en Microsoft Office-softwarepakketten waaronder PhotoShop (“PhotoCraft”) en LightRoom (“LightCraft”, u snapt het thema). De tagline vind ik briljant: software waarvan je al weet hoe ie werkt.

Dat specifieke voorbeeld klopt niet; het is niet met REA gemaakt en niet op basis van decompilatie. Ontwikkelaar Brandon Thomas liet een groep agents software maken die “moest doen wat Photoshop doet” (en Word, en Excel, et cetera), op basis van een groot aantal voorbeelden van Photoshop-bestanden en openbare documenten over wat er allemaal kan. Dát is legaal, je reconstrueert wat er moet gebeuren en genereert eigen code om dat voor elkaar te krijgen.

Tegelijk laat die methode de beperking zien: het ziet eruit als Photoshop, het werkt zoals Photoshop maar het kan bij lange na niet wat Photoshop kan. De onderliggende algoritmes (de hóe dan van software) staan immers niet in die documenten en volgen ook niet triviaal uit de bestanden.

De slimme oplossing van Thomas is om bestaande opensourcefunctionaliteit te verbinden aan de gekloonde UI, bijvoorbeeld om Excelbestanden te lezen of om berekeningen te maken. Dat kun je ook doen met Photoshop-knopjes, alleen is er momenteel geen open source implementatie die net zo slim en krachtig is als wat Adobe op de markt brengt. (Onaardig is om dit Gimp-met-Photoshop-skin te noemen. Vooral voor Gimp, want daar werkt wél alles.)

Wat ik zo vervelend vind, is dat overal de media dit brengt als “AI reverse engineering”, alsof de geheime algoritmen van Adobe en Microsoft door geavanceerde AI technieken achterhaald zijn en hun software nu 100% opnieuw gebouwd is door software afscheidende taalmodellen. Zo ver zijn we nog lang niet, en dit is geen bewijs dat het die kant op gaat.

En ja, in theorie zou je met AI het klassieke clean room reverse engineering kunnen doen, dat ooit op de IBM PC BIOS software is gebruikt. Twee systemen: de ene gebruikt REA om PhotoShop geheel uit elkaar te pluizen en een uitgebreide specificatie op algoritme-niveau te schrijven. De andere ontvangt enkel en alleen die specificatie en produceert code.

Dit heeft nogal wat voeten in de aarde maar ik zie niet waarom het niet in principe zou kunnen. De problemen beginnen bij het bewijzen of het heeft gewerkt: hoe toon je aan dat er geen disassembled Adobe software in de trainingsdata zat, en dat systeem A geen technische inzichten heeft gelekt in de specificatie?

Arnoud


Is de fooienknop op de pinautomaat een oneerlijke handelspraktijk?

Photo by AhmadArdity on Pixabay

Wil je 5 procent fooi geven, 20 procent of liever niets? Je hebt een paar seconden bedenktijd, want de horecamedewerker houdt de betaalterminal met het fooienscherm geen uren voor je gezicht. Zo opende een recent Nu.nl-artikel. Diverse lezers vroegen me: zou dat niet verboden moeten zijn, op die manier fooien vrijwel afdwingen?

Even de wettelijke basis: in Nederland zijn fooien schenkingen van de klant aan het personeel, en dus geen loon. De werkgever mag ze centraal incasseren (zoals met de pinautomaat) maar moet ze dan toevoegen aan de fooienpot. En als de ondernemer pinnen stimuleert, dan is een fooien-optie per pin vrij logisch.

Het probleem is vooral de manier waarom men er om vraagt:

Het fooienscherm zit vol nudges: het knopje met “nee dank je” is vaak niet direct zichtbaar, maar vereist een extra tikje of extra scrollen. Het percentage 20 staat in een groter lettertype in een gekleurd vakje om de klant te verleiden dát aan te klikken. Het zijn voorbeelden van dark patterns (donkere patronen), legt Lotje Beek van Bits of Freedom uit. “Via design word je gestuurd naar een keuze die je anders niet had gemaakt”.
Die laatste zin wijst op de wettelijke regels rond oneerlijke handelspraktijken. Consumenten manipuleren om een oneigenlijke keuze te maken, leidt er toe dat de transactie ongeldig wordt (vernietigbaar). Deze genoemde technieken leiden er inderdaad sneller toe dat mensen een fooi-percentage kiezen, waar dan nog bij komt dat je niet zelf afrondt naar een leuk getal maar vrij snel bij 20% uitkomt, wat in Nederland vrij hoog is.

Ik heb ook implementaties gezien waarbij je keurig vier knopjes direct in beeld krijgt: 5%, 10%, 20%, geen fooi. Allemaal gelijk vormgegeven en direct te kiezen. Dat een dark pattern noemen vind ik lastig.

Die in het artikel genoemde medewerker met zo’n blik van “graag nu kiezen en ja je mág nul kiezen als je mijn werk niets bijzonders vond” staat er dan nog steeds bij. Ik neig er naar om dit “ongepaste beïnvloeding” te noemen, en dan uit te komen bij de agressieve handelspraktijk (art. 6:193h BW), het broertje van de oneerlijke.

Het idee hier achter is dat je in vrijheid wilt kunnen bepalen wat je extra wilt geven, en wanneer diegene meekijkt is het moeilijk dat nog te doen. Niemand wil gierig overkomen, of een discussie openen “wat was er niet goed aan het eten dan”. Maar toegegeven, onderzoek ken ik niet.

Hoe veel fooi geven jullie eigenlijk, en maakt het dan uit of je een knopje moet indrukken of geld op tafel laten liggen?

Arnoud


ACM wil transparantie over computergestuurde prijzen, maar wetgeving is er niet

Photo by Jakub Zerdzicki on Pexels

De Autoriteit Consument & Markt (ACM) pleit voor meer transparantie over de ‘black box’ van computergestuurde prijzen. Dat meldde Tweakers onlangs. Prijzen mogen variëren, maar het lijkt niet verplicht te melden op basis waarvan. Frustrerend, in ieder geval.

Uit het artikel:

De ACM haalt in het persbericht de luchtvaartsector als voorbeeld aan: een op de drie vliegtickets heeft een prijs die 40 procent hoger ligt dan de oorspronkelijke verkoopprijs. Volgens de ACM worden er per vliegtuigstoel 35 verschillende prijzen aangeboden tijdens de verkoopperiode. Ook op sites als Booking.com krijgen gebruikers te maken met sterk uiteenlopende prijzen.
En inderdaad, de wet kent vele verplichtingen voor de koper maar hoe de prijs is bedacht, daar hoef je niet heel transparant over te zijn. De prijs noemen is essentieel (art. 6:193e BW), en onjuiste of misleidende presentatie van de prijs is een misleidende handelspraktijk (art. 6:193c).

Bij overeenkomsten op afstand (zoals internetaankopen) is daarnaast vereist (art. 6:230m BW) dat de handelaar “op duidelijke en begrijpelijke wijze” de nodige informatie verstrekt, waaronder “dat de prijs is gepersonaliseerd op basis van geautomatiseerde besluitvorming”.

Als hoofdregel is dat begrijpelijk, de prijs is uiteindelijk jouw commerciële inschatting. (In juridische termen: wat de gek er voor geeft.) Je hoeft geen factoren te hébben, dus hoe kun je dan verplichten die te onthullen?

In 2022 dwong de ACM het platform Wish te stoppen met gepersonaliseerde prijzen, met onder meer het argument dat Wish niet uitlegde hoe die tot stand kwamen. Ook in 2022 werd datingplatform Tinder aangesproken op (onder meer) gepersonaliseerde prijzen. Daar werd geschikt, waarbij Tinder afsprak hier transparant over te zijn; kennelijk genoeg is dit signaleren in hun gebruiksvoorwaarden.

Echte duidelijkheid is er dus nog niet. Een mogelijkheid om die te creëren is een uitstapje naar de AVG. Gepersonaliseerde prijzen zijn een vorm van geautomatiseerde besluitvorming op basis van je persoonsgegevens. Onder artikel 15 AVG heb je dan recht op “nuttige informatie” over hoe die werkt, en in het Dun & Bradstreet arrest is uitgemaakt dat daar concrete uitleg bij hoort over hoe in dit geval tot de uitkomst is gekomen.

Een open vraag is wanneer dit precies geldt. Artikel 15 wordt vaak samen gelezen met artikel 22, dat “uitsluitend geautomatiseerde besluitvorming” verbiedt, behoudens uitzonderingen. Daarbij moet het dan gaan om iets dat je zwaar raakt, zoals een afwijzing bij een sollicitatie of een hypotheek.

Als je de lat van “zwaar raken” niet haalt, dan is dus de vraag of artikel 15 AVG geldt. In Dun & Bradstreet zegt het Hof namelijk dat je die uitleg alleen nodig hebt als je een artikel 22-besluit wilt aanvechten (punt 55). Mijn lezing is dus dat er géén recht op uitleg is buiten de artikel 22 gevallen.

Is een prijs van een gewoon handelsartikel gelijk te stellen, aan een hypotheekaanvraag of sollicitatie? Ik zie hoe die mijn leven kunnen beïnvloeden, maar dat het vliegtuig naar Rome op mijn Macbook 350 euro duurder is of dat ik een lokprijs krijg voor een nieuwe robotstofzuiger vind ik van een andere orde.

Tegelijkertijd: kredietscores voldoen aan dat criterium, en kredietscores worden ook ingezet bij ordinaire online aankopen. Dus als je kredietscore moet worden uitgelegd, waarom dan niet de prijs die op eenzelfde manier wordt samengesteld?

Arnoud

Moet de leeftijdsdetectie-AI in de supermarkt zeggen dat ‘ie AI is?

Photo by wir_sind_klein on Pixabay

Interessante zijstap in de discussie van vorige week:

Aan de zelfscankassa’s bij de lokale supermarkt hangt tegenwoordig een klein kastje met een blauw/rood/groen lampje. Er staat geen uitleg bij. Ik heb het ding gegoogled en het blijkt een leeftijds-schatter te zijn die aangeeft of ik een fles drank mag afrekenen. Zodra het ding mijn leeftijd heeft geschat gaat hij op rood of groen. Mag ik aannemen dat de kleur van het lampje geldt als een interactie van het apparaat naar mij toe?
Dit haakt in op het recent van kracht geworden stuk uit de AI Act dat interactieve AI zichzelf bekend moet maken, zodat je weet dat je met een AI praat en niet met een mens.

De AI Act zelf definieert niet wat “interactie” is. De recent uitgekomen Richtsnoeren hierover doen wel een poging:

Interaction entails the capability of a bidirectional exchange of information or actions between natural persons and the AI system with a genuine conversational or responsive character. It can occur in various forms (e.g. auditory, visual and physical). Natural persons should be able to provide input (e.g., written text or other forms of content, voice, or physical actions) to the AI system (e.g. via technical communication means including online interfaces, phone or e-mail, or directly), while the AI system should be capable of responding with contextual output (including any type of content or actions) and vice-versa.
Ik haal hier uit dat de ene partij input levert waar de ander een afgestemde reactie op geeft (de AI mag ook beginnen, staat verderop). Dat past prima bij een chat, maar het kan ook een “one-time exchange” zijn. En dat zou ook passen bij zo’n blieplampje waar jij je gezicht als invoer geeft en een groen kleurtje terugkrijgt.

Daarnaast moet de interactie “direct” zijn, oftewel real-time of daar dicht bij, en zonder menselijke tussenkomst. Een medewerker die AI gebruikt om reacties te componeren is dus genoeg om aan deze plicht te ontsnappen, zolang deze meer doet dan een copypastevogeltje zijn.

Als uitzondering worden wel “automated facial-recognition access controls” genoemd, maar ook “one-time feedback (e.g. spam filters)”. Die laatste is interessant: de AI stopte een mail in mijn folder “Junk mail”, ik klik op “Not junk” en de AI neemt actie. Dat is dus géén interactie zoals hier bedoeld.

Waar hoort dan “<houdt gezicht voor camera>” / “<groen>”? Ik neig naar: geen interactie, vanwege de sterke gelijkenis met het spamfilter. Ook is voor mij belangrijk dat de uitvoer niet contextueel is, iedereen krijgt ja of nee, en er is geen persoonsgebonden variatie.

Een AI systeem als dit maakt wel beslissingen in de zin van artikel 22 AVG. (Dat mag, want het is vrijwillig te gebruiken.) Volgens de AVG moet er dan uitleg bij komen over hoe dat werkt en dergelijke (artikel 13 en 15). Een sticker dat het AI is en waar je de privacyverklaring kunt vinden, is denk ik voor deze situatie een heel eind adequaat.

Arnoud


Mag Grammarly je medewerkers spammen of je het zakelijk account alsjeblieft niet wil opzeggen?

Bron: Reddit

Via Reddit:

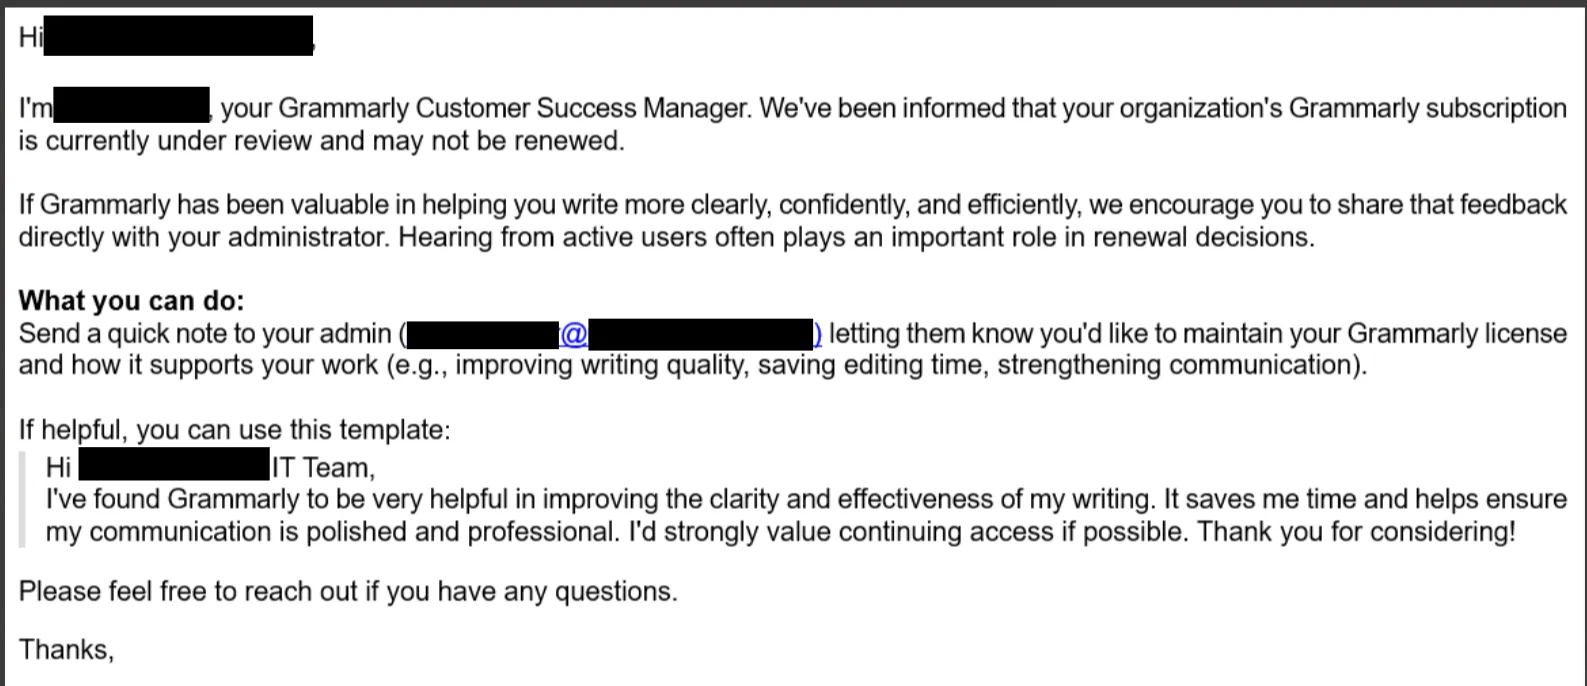
[Ons bedrijf had een Grammarly abonnement.] We lieten hen weten dat we ons abonnement niet zouden verlengen, waarna ze ongevraagde e-mails en pop-ups in hun app naar alle gebruikers met een licentie stuurden. Ze gaven ons geen waarschuwing vooraf, maar begonnen gewoon iedereen te bombarderen. Ze vermeldden zelfs het directe e-mailadres van de persoon in mijn team die de licenties beheert.
Grammarly is schrijfassistentiesoftware, ooit begonnen als grammatica/stijlchecker met plagiaatcontrole en Now With AI®? met onder meer een “Herschrijf in de stijl van Stephen King”-feature.

Je kunt als bedrijf een zakelijk abonnement afnemen zodat werknemers er gebruik van kunnen maken. Die hebben dan een eigen account binnen de paraplu van het abonnement. Dit is vrij standaard natuurlijk. Opzeggen is dat ook.

Niet standaard is dat als het bedrijf het abonnement opzegt, de leverancier al die accounthouders gaat mailen of via een popup meldt dat dat gaat gebeuren (zie plaatje hiernaast). “Send a quick note to your admin” – wil jij even je manager mailen dat hij dit niet moet doen? Raar.

Diverse tipgevers vroegen me of dat überhaupt wel mag.

Onder de AVG heeft Grammarly die mailadressen als verwerker; ze heeft die nodig voor het inloggen en misschien hier en daar een statusbericht. Voor eigen doeleinden die inzetten mag dan niet (de eigen nieuwsbrief naar zulke accounts is zeer donkergrijs).

De vraag is dus: is wat Grammarly doet, voor eigen doeleinden of valt dat binnen de verwerkerstaak? De gebruiker informeren dat het abonnement afloopt, is te zien als een verwerkerstaak. Maar de tekst ademt vrij duidelijk het belang van Grammarly zelf.

Arnoud


Moet een supermarkt het melden als ze met AI winkeldieven opsporen via het camerasysteem?

Photo by ElasticComputeFarm on Pixabay

Een lezer vroeg me:

Sommige winkels gebruiken beveiligingscamera’s met AI om gemaakte beelden te analyseren. Dit zou winkeldiefstal moeten tegengaan. Hoewel vrijwel iedereen keurig waarschuwt voor cameratoezicht, heb ik nog nergens bordjes gezien dat er ook een AI-analyse plaatsvindt. Is dat eigenlijk niet verplicht onder de AI Act?
Per 2 augustus jongstleden is de zogeheten transparantieplicht uit de AI Act (artikel 50 lid 1) van kracht geworden. “AI-systemen die voor directe interactie met natuurlijke personen zijn bedoeld” moeten die personen duidelijk maken “dat zij interageren met een AI-systeem”. Primair is dit bedoeld tegen misleidende chatbots die zich voordoen als mensen.

De AI Act definieert niet wat “directe interactie” betekent. De Richtsnoeren van de Commissie, die in juli verschenen  (sectie 3.1.1), vullen de term nader in: het moet gaan om realtime of near realtime interactie, waarbij de AI-uitvoer direct bij de betrokken persoon terecht komt. “Interactie” is dan een bidirectionele uitwisseling van informatie, waarbij iedere partij ten minste één bericht naar de ander stuurt.

Dit is waar het op misgaat met een antidiefstal-AI: die communiceert niet met shoppers, dus de shoppers hoeven niet te weten dat die AI wordt ingezet. Hooguit moet het personeel dat weten, als we “het scherm geeft een waarschuwing en jij moet op Ok klikken” lezen als een interactie. Maar als professioneel gebruiker zal dat wel duidelijk voor ze zijn, en dan hoeft een aparte melding niet.

Dat is alleen niet het hele verhaal. Zo’n AI-signalering is onder de AVG een vorm van geautomatiseerde besluitvorming. Ik ben er nog niet uit of dit onder het verbod van artikel 22 valt, want is dit “in aanmerkelijke mate treffen”? De AVG noemt zaken als automatisch een kredietaanvraag weigeren of een sollicitatie afwijzen, en de Richtsnoeren (WP251) geven als aanvullend criterium of het “de omstandigheden, het gedrag of de keuzen van de betrokken personen in aanmerkelijke mate [treft]”. Zeg het maar.

Maar los van die discussie, als er persoonsgegevens worden verwerkt met als doel te komen tot een signalering “mogelijk winkeldief” dan moet dat duidelijk worden gemeld (artikel 12 en 14). Op zijn minst vereist dat een toelichting in de privacyverklaring, maar ik denk dat je niet ontkomt aan een bordje gezien het nieuwe en bijzondere karakter van deze verwerking. Wie er eentje ziet: ik ontvang graag de foto!

Arnoud

Machteloze gemeenten zetten betonblokken in om sluipverkeer via Google Maps te voorkomen

Photo by Jan van der Wolf on Pexels

Sluiproutes van navigatie-apps bij files en wegafsluitingen zijn provincies en gemeenten een doorn in het oog. Dat meldde RTL nieuws vorige week. Overleg blijkt niet mogelijk, ondanks dat officiële omleidingen niet als voorkeursroute worden getoond. Vandaar de betonblokken bij wijze van code-as-law.

Het bericht zet Vijfheerenland centraal, dat vlak bij zowel de A27 als de A2 ligt waar vele files of werkzaamheden zijn. De navigatie-app vindt dan een snelle sluiproute, maar daar zijn die gemeentes niet blij mee. Want die keuze gebeurt op doorlooptijd voor de automobilist en niet op wat de gemeente aangeeft dat de officiële omleiding is.

Volgens [minister Vincent Karremans van Infrastructuur en Waterstaat] moet het belang van verkeersveiligheid zwaarder wegen. Hij zegt daarover in gesprek te willen gaan met de navigatiediensten. “Ik kan ze niet dwingen, maar ik ga kijken hoe ik gemeenten kan helpen. Nu ben ik minister van Infrastructuur en Waterstaat. Misschien nemen ze nu wel de telefoon op.”
Sinds 2010 (herzien 2023) is er een Europese Richtlijn voor realtimeverkeersinformatiediensten, aangevuld met een Verordening die regels stelt voor uitwisseling van gegevens inzake realtimeverkeersinformatiediensten (RTTI).

Artikel 6 lid 4 van de RTTI is vrij helder:

Dienstverleners verwerken en integreren in de relevante diensten die zij aan eindgebruikers verstrekken, zonder extra kosten, gegevens over alle tijdelijke verkeersbeheersmaatregelen die door de bevoegde autoriteiten zijn ingevoerd en via het nationale of gemeenschappelijke toegangspunt in een digitaal machineleesbaar formaat toegankelijk zijn gemaakt.
Probleem: Die verplichting houdt echter nog niet in dat Google zijn routekeuze moet laten samenvallen met de door de gemeente gewenste route. Specifiek daarvoor is er geen wettelijke plicht in die RTTI regels. Oostenrijk is bezig met een wetsvoorstel dat wel expliciet eist dat officiële routes gevolgd moeten worden.

Google Maps specifiek is sinds een tijdje een zeer groot online platform onder de DSA. Dat is juridisch voor “je bent te groot en daarmee te gevaarlijk om zelf te mogen bepalen hoe je je dienst inricht”.

Concreet betekent dit dat ze verplicht zijn zogeheten systeemrisico’s in kaart te brengen en te mitigeren. Haar laatste rapport laat zien hoe dat gaat, maar focust (p.82) eigenlijk alleen op het online stuk: reviews en omgang met persoonsgegevens. Nergens wordt ingegaan op de route-vaststelling en haar impact.

Voor VLOPs zoals Maps is de Europese Commissie exclusief bevoegd. De ACM kan (ook op verzoek van de minister) de Commissie vragen hier handhavend op te treden, met de data van de gemeenten als onderbouwing. Maar als we zelf iets willen doen, moet daar een aparte wet voor komen. Of meer betonblokken.

Arnoud


Mag ik een (beschadigd) pakket alsnog weigeren als de buurman het heeft aangenomen?

Photo by RDNE Stock project on Pexels

Een lezer vroeg me:

Hoe zit dat als een buurman met een beschadigd pakketje bij me komt. Kan ik die dan alsonog weigeren, hij is immers nog niet bij mij bezorgd. En wat moet die buurman dan, ik kan me niet voorstellen dat die dan verantwoordelijk wordt voor terugzending?
Hoofdregel uit de wet bij online bestellingen is dat het pakket pas voor jouw risico is als het bij jou over de drempel is gegaan. Dat staat in artikel 7:11 BW, en je kunt niet bijvoorbeeld in de algemene voorwaarden dat anders regelen.

Wordt het pakket elders afgegeven, dan is de vraag of dat in jouw opdracht is gebeurd, een “door jou aangewezen derde” zoals de wet dat omschrijft. Wijs je zelf een pakketpunt aan, of hang je een briefje op de deur dat het bij nummer 13 afgegeven moet worden, dan is dat zo’n opdracht.

Voor de vraag hangt het er dus van af of het pakket gevraagd of ongevraagd bij de buurman is afgegeven. Is het gevraagd, dan is het pakket van jou en moet je via de gewone route van klagen over nonconformiteit een oplossing zoeken. Is het ongevraagd, dan kun je (juridisch) de buurman nee verkopen en het hem of haar laten uitzoeken met de winkel.

Voor die buurman: je hebt een zorgplicht om dat pakket niet stuk te laten gaan (ik dénk zaakwaarneming, of bewaarneming) en de winkel te laten weten dat er een pakket van ze bij jou ligt. Aangenomen dat dat kan zonder dat je het open hoeft te maken.

Terugsturen hoef je pas te doen als de winkel je een zegel geeft (of aanbiedt het op te halen), waarbij ik het normaal vind dat je naar het pakketpunt gaat als dat een beetje te doen is. Dat is hoe we in het maatschappelijk verkeer met elkaar omgaan.

Dit voelt vervelend want je wilde alleen je buur helpen door een pakket aan te nemen, en dan moet je nu uitzoeken welke winkel dit is, correspondentie voeren over terugsturen en wachten tot je een zegel krijgt. Maar een andere route binnen de wet weet ik niet. Het pakket kwam niet ongevraagd bij jou, en als je buur je niet heeft gevraagd om dit te doen dan heb jij wettelijk het probleem op je bord.

(Heeft de buurman je wél gevraagd het pakket aan te nemen en weigert die het vervolgens op te halen, dan geef je ‘m een deadline en gaat het daarna in de kliko of over de schutting.)

Arnoud

Voormalig vrijwilligster moet beheerdersrechten Facebookpagina overdragen

Photo by Schluesseldienst on Pixabay

De voorzieningenrechter oordeelt dat een voormalig vrijwilligster de beheerdersrechten van een Facebookpagina aan de eisende organisatie moet overdragen. Dat meldde IT en Recht onlangs. Het is problematiek die regelmatig langskomt, en soms lastige juridische vragen kan geven. Wat ís een Facebookpagina eigenlijk, en welke plichten heb je als vrijwilliger?

Om maar met die eerste vraag te beginnen: een Facebookpagina is als zodanig niets, ik noem het vaak gestolde dienstverlening. Want uiteindelijk staat die pagina op mensen hun scherm omdat Facebook een overeenkomst met de beheerder sluit. En de vraag komt dan dus neer op: wie is die beheerder?

Het antwoord is niet hetzelfde als “de persoon die de overeenkomst sloot”. Als je dat als werknemer doet bijvoorbeeld, is je werkgever de contractseigenaar en dus de beheerder.

Als vrijwilliger ben je geen werknemer, dus dan ligt het lastiger. In 2019 bijvoorbeeld werd gekeken naar concrete opdrachten of waar het initiatief lag. Dit viel verschillend uit bij twee pagina’s van de vrijwilliger: eentje een “officiële” pagina van een politieke partij, een andere een groep daar omheen.

Die tenzij gaat op bij de pagina van de partij zelf. Deze is immers in 2014 aangemaakt voor de partij, en pas drie jaar later is het ex-lid gevraagd beheer daarvan te doen. … Voor de groep komt het anders uit. Het uitgangspunt blijft hetzelfde, maar deze groep is op eigen initiatief door het ex-lid aangemaakt, waarbij hij zichzelf als beheerder presenteerde en de groep niet als officieel of namens de partij aangemerkt had. Daarmee is er dan te weinig om te spreken van een groep die eigenlijk van de partij had moeten zijn.
Bij deze zaak gaat de redenering eigenlijk net zo. De pagina dateerde uit alweer 2013, en werd aangemaakt voor de organisatie door andere personen.
Vervolgens is [gedaagde] in verband met haar eigen dierenwebshop via [persoon 3] als website-beheerder van [eiser] in contact gekomen met [eiser] . In de loop van 2019 is zij de Facebookpagina gaan beheren en zij heeft in de jaren daarna de content verder uitgebouwd. Zij heeft dat in overleg met het bestuur van [eiser] gedaan. De omstandigheid dat aan [gedaagde] grotendeels de vrije hand is gegeven voor de bewerking van de Facebookpagina in het kader van de samenwerking maakt echter niet dat zij daardoor rechthebbend op de Facebookpagina is geworden.
Dat “vrije hand” argument hoor ik ook vaker: ik mocht alles zelf doen, dat bewijst dat ze vonden dat het mijn pagina was. Dat is dus niet juist. Ook niet als dat enorm veel werk was en de pagina alleen door al dat werk een gigantisch succes is geworden.

Ook telt niet het gegeven dat de organisatie je beheerder maakt. Die term suggereert weliswaar dat je iets bijzonders bent, maar dat is alleen in de relatie tot Facebook relevant. Het verandert niets in je relatie tot de organisatie.

Arnoud

Als ChatGPT je wetenschappelijke primeur voor je neus wegkaapt dankzij je chatlog

Photo by geralt on Pixabay

OpenAI claimt een van de zeven Millenniumprijsproblemen te hebben opgelost met een intern AI-model, meldde Tweakers gisteren. Twee menselijke onderzoekers stonden op het punt die oplossing te vinden. Kan gebeuren, maar ze gebruikten ChatGPT bij hun onderzoek. Is er meegelezen door OpenAI?

De Navier-Stokes-vergelijkingen geven snelheid, druk en richting van stromende vloeistoffen en gassen. Een volledige oplossing houdt in dat je die op op elk punt en op elk moment exact kunt voorspellen. Tot nu toe is dat niemand gelukt, maar onderzoekers Tristan Buckmaster en Levent Alpöge hadden gemeld er bijna te zijn.

Bij hun onderzoek gebruikten ze zowel Claude als OpenAI Codex, waaronder GPT-5.6 Sol en later Astra. Nadat geruchten rondgingen dat een oplossing in zicht zou zijn, liet OpenAI een bak rekenkracht los om deze met haar meest geavanceerde model te vinden. Men vond geen volledige oplossing, maar wel een forse stap: “finite-time blow-up voor geforceerde Navier–Stokes [], met gladde forcing volgens opties C en D uit Feffermans officiële probleemstelling.”

Nee, ik weet werkelijk niet wat dat betekent maar wiskundigen zijn er enthousiast over. Mij gaat het om de constatering dat  niemand nog die route had bewandeld behalve Buckmaster en Alpöge, en dat zij hierbij dus gebruik maakten van een (openbaar) AI-model van datzelfde OpenAI.

In haar verklaring geeft OpenAI dat

We (the researchers and the agents) did not see any of their work through any means until they released it publicly — in particular, no specific user data was accessed in order to solve this problem. While unlikely, we cannot rule out that de-identified data derived from their usage of our products helped improve our models?. However, our proofs differ significantly and even the precise results proved are different in the Euler case (forced vs unforced).
Als jurist haal ik hier uit: we hebben géén chatlogs of bijlagen gelezen, maar het is mogelijk dat delen van chats als “verbetering aan het model” zijn gevoerd en daarmee deel van het nieuwste model zijn geworden. Voor een taalmodel kan dat genoeg zijn om vervolgens op die input bij te sturen naar de goede richting.

Mag dat? Goede vraag. Als het goed is, weten de meesten dat je het vinkje “Improve the model for everyone” uit kunt zetten (Settings > Data Controls). Maar je moet óók naar je privacy controls om daar “Do not train on my content” uit te vinken. En als je daarna een keer feedback op een chat geeft (duimpje omhoog/omlaag) dan passeert dat die instelling, zeg ik er gelijk bij.

Een lastige vraag: hoe bewijs je ontlening als die via modeltraining verloopt? Er is geen log te vinden waarin iemand van OpenAI zich toegang gaf tot die chats. Als er wat is gebeurd, is die chat geautomatiseerd vermalen tot een serie tokens en is een trainingsproces daar lekker op gaan knabbelen. Waar specifieke teksten dan zijn gebleven, is niet te zeggen – sterker nog, ze zijn nergens meer.

In auteursrechtland speelt het issue van memorization, het reconstrueren van een specifiek stuk trainingsdata. Zeer theoretisch zou het dan mogelijk moeten zijn om te kijken of het paper (of grote prompts) te reconstrueren is. Dat geeft ze dan een morele overwinning, want het werk is er met toestemming in gezet dus de memorization er van is geen auteursrechtinbreuk.

Een bedrijf kan dus (mogelijk) profiteren van een nog niet publiek intellectueel inzicht zonder dat één medewerker dat inzicht ooit heeft gezien, zonder dat het oorspronkelijke werk wordt gereproduceerd en mogelijk zelfs zonder dat achteraf nog kan worden vastgesteld of dat inzicht causaal aan het resultaat heeft bijgedragen.

Of en welke vinkjes jij wanneer hebt aangevinkt, zijn dan je enige tegenargumenten, waarbij “we cannot rule out that de-identified data derived from their usage of our products helped” dan kennelijk daar overheen gaat. Ik weet even niet wat daarvan te vinden.

Arnoud