Rechtbanken nemen volgend jaar afscheid van de fax

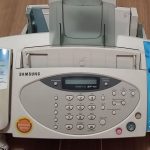
Rechtbanken doen in februari 2022 de fax in de ban, meldde Nu.nl vorige week. Vanaf dat moment sturen rechters en griffiers vertrouwelijke informatie via beveiligde e-mails. Een gedwongen innovatie: KPN stopt volgend jaar met de dienstverlening voor traditioneel faxen (ISDN). Het gaf vele reacties, vooral van verbazing. Heel gek is het niet, dat de rechtbank toch lang vasthield aan faxen. Maar als de rest van het land eigenlijk al vergeten is wat dat voor dingen zijn, dan wordt het misschien toch eens tijd.

De juridische wereld hangt sowieso heel erg van traditie en terughoudendheid aan elkaar, maar daar is een goede reden voor: het zijn bewezen werkende en betrouwbare werkprocessen. En dat is wat je wil wanneer jouw output de levens van mensen kan maken of breken, soms zelfs letterlijk. Je kunt niet zomaar in een gecontroleerde omgeving een test doen met robotvonnissen bijvoorbeeld, dat heeft serieuze impact.

De overstap van post naar fax was destijds al een grote stap. Ik kon niet precies achterhalen wat de eerste uitspraak was waarin faxverkeer als rechtsgeldig werd erkend, de strafzaak HR 13 september 1988, NJ1989,12 lijkt de eerste uitspraak te zijn geweest. Hierin stond ter discussie of een gefaxte pleitnota wel rechtsgeldig ondertekend was door de advocaat. Immers, hoe controleer je de echtheid van een korrelig plaatje? Gelukkig was de advocaat-generaal van de HR behulpzaam:

Nodig is dat de advocaat telefonisch of schriftelijk aan de griffie van de HR laat weten dat de gefotocopieerde handtekening zijn handtekening is. Waar zo een nadere mededeling ontbreekt zal slechts een toevallige omstandigheid, zoals de aanwezigheid in het dossier van een brief van de indienende advocaat met diens originele handtekening en de mogelijkheid om de overeenkomst van die handtekeningen zonder moeite vast te stellen, de schriftuur met de gefotocopieerde of ‘gefaxte’ handtekening kunnen redden.
In andere zaken werd vergelijkbaar geoordeeld, waarbij ook wel als argument werd geaccepteerd dat je het origineel naleverde en dat men achteraf kon zien dat dit identiek was aan de fax. Dan heb je je origineel maar kan het allemaal net wat sneller. Daar kon niemand op tegen zijn, maar zeker woog ook mee dat professionele procespartijen zoals advocaten of rechters er geen belang bij zouden hebben om vervalste faxen te sturen. De kans op vervalsingen zou dus klein genoeg zijn.

Anekdotisch zijn er natuurlijk genoeg verhalen over het tegendeel. Je had grapjassen die dan pagina 1 stuurde en een zelf alvast afgescheurde pagina 2 zodat ze ’s ochtends konden bellen en verbaasd zijn dat de fax het origineel had verscheurd, maar “ik stuur meteen de tekst ahem nogmaals”. Een pdf corrumperen zodat je “iets” kunt inleveren met dezelfde truc is wat technisch complexer.

Er bleven genoeg vragen, zoals wat rechtens is als de toner bijna op was zodat de fax onleesbaar is maar de afzender wél een technisch “bericht ontvangen” melding heeft gekregen? Of wat als pagina 1 om 23:58 was ontvangen maar de laatste pagina om 0:05 de volgende dag? Hoe expliciet moet je zijn over faxen willen ontvangen, is het dan genoeg dat je faxnummer op je briefpapier staat of moet een rechtbank zeggen “wij gaan u faxen”? (Benieuwd wie deze drie alledrie onderbouwd weet te beantwoorden.)

De transitie van faxen naar een digitale omgeving (we gaan het gewoon niet over e-mail hebben) heeft heel lang geduurd. De belangrijkste reden daarvoor was volgens mij dat men er eigenlijk het nut niet van inzag, post en faxen wérkt toch gewoon? Maar goed, als het moet, laten we het dan in een keer helemaal goed doen. En zoals iedere IT’er weet, een geheel werkproces vervangen door een nieuw proces dat in zijn geheel helemaal goed moet zijn, dat is een recept voor enorme vertragingen en complexiteit.  Maar goed, het gaat nu dus eindelijk gebeuren.

Arnoud
Oh help, nu gaan AI’s ook al uitvindingen octrooieren

In juli bepaalde een Australische rechtbank dat een AI-systeem rechtsgeldig als uitvinder vermeld kan worden op een octrooiaanvraag, zo las ik op de Copyright Blog van Kluwer. Daarmee staat in beginsel de weg open om in Australië automatisch gegenereerde uitvindingen (de aanvragen worden nog handmatig geschreven, geloof ik) als octrooi aan te vragen. In andere jurisdicties, met name de VS, Europa en Duitsland, zijn dergelijke aanvragen afgewezen op deze formele grond. Zuid-Afrika ging Australië voor, hoewel er geen expliciete motivatie is gegeven. Nu dus alleen nog een AI die octrooien genereert plus eentje die ze beoordeelt en we kunnen als octrooimensen weer wat leuks gaan doen.

Over het octrooisysteem hebben we het natuurlijk al veel gehad, vrijwel altijd in negatieve zin omdat zeker in de ICT sector octrooien om vele redenen ongewenst worden geacht. Slechte kwaliteit, vage claims en nodeloze blokkades in een al decennia prima werkend systeem. Building tollbooths where others will build roads, zei een oud-collega van me vroeger eens. Maar in ieder geval waren we het er over eens dat uitvinders mensen zijn. Vaak in dienst van werkgevers die dan  rare dingen deden, maar toch.

Deze discussie gaat over iets complexers: kan een niet-mens uitvinden? Je komt dan in hele fundamentele discussies terecht over het doel en wezen van het octrooisysteem.

De meest gehoorde theorie is dat je mensen wil prikkelen om een uitvinding bekend te maken, door ze een beloning te geven in de vorm van een monopolie van 20 jaar. Vanuit dat perspectief kan een AI/niet-mens geen uitvinder zijn, want die heeft niets aan die prikkel. Dit is grofweg wat het EPO en het USPTO deden, hoewel op de formele grond dat in de wet staat dat “aan hem of haar” (de uitvinder dus) octrooi wordt verleend op uitvindingen. Een AI is geen hem of haar (of hen) dus de aanvraag voldoet niet aan de letter van de wet.

Je kunt ook iets ruimdenkender zijn en erkennen dat vandaag de dag 90% van de octrooiaanvragen door bedrijven wordt ingediend, waarbij de mens-uitvinder slechts metadata-veld 72 is en genoemd wordt omdat we dat altijd deden. Het maakt de facto helemaal niets uit of die mens zelfs maar leeft of niet, de aanvraag gaat toch wel verder en levert rechten (of een afwijzing) op aan de aanvrager. Vanuit dat perspectief is er nul bezwaar tegen een AI als uitvinder.

Een meer fundamentele kwestie is natuurlijk of een niet-mens kan uitvinden in de zin van de octrooiwet. Een uitvinding moet immers nieuw zijn (nog niet bestaan) en geen voor de hand liggende variatie op het bestaande zijn. Iets nieuws zoeken kunnen AI’s prima, maar of het voor de hand ligt is een veel lastiger vraag. En waar je menselijk inzicht of handelen (zou iemand die A las, vervolgens B erbij proberen en C weglaten) nog kunt beoordelen, is dat bij AI handelen helemaal ingewikkeld.

Ik heb daar zelf altijd nog de fundamentele vraag bij of een AI überhaupt wel iets doet dat niet voor de hand ligt. Voor de hand liggen dingen die je normaal doet, gewoon stappenplannen volgen, de gebaande paden, doorrekenen en doorlopen. En dat is volgens mij precies wat dergelijke algoritmes doen, ook al ziet het er heel intelligent uit. Maar goed, dat is dus een heel lastige route om de vraag “moet het kunnen ja of nee” te beantwoorden. Dus dan is gaan zitten op de formele wet (er staat hij of zij, dat is een AI niet) een stuk slimmer, voor de korte termijn.

Ik ben ondertussen wel benieuwd of er al AI’s zijn die octrooiaanvragen kunnen beoordelen op haalbaarheid. (Als het EPO meeleest, ik doe graag een pilot.) Want als we dat eenmaal hebben, dan is de volgende stap dat we het hele systeem omver blazen: AI’s dienen tienduizend aanvragen per minuut in, andere AI’s schieten er tienduizend minus epsilon af per minuut en wij mensen gaan ondertussen iets anders doen. Wint de ICT toch nog van het octrooisysteem.

Arnoud

VN-commissaris roept op tot stopzetting van biometrische herkenning via AI

De commissaris voor mensenrechten bij de VN pleit voor een stopzetting op het gebruik van biometrische herkenning in de publieke ruimte, las ik bij Tweakers. Mevrouw Bachelet doet deze uitspraak in een rapport van de Verenigde Naties waarin de effecten van artificiële intelligentie op mensenrechten wordt besproken. Overheden zouden eerst moeten kunnen aantonen of er voldaan wordt aan de privacywetgeving en of er niet gediscrimineerd kan worden. En dat geeft weer gelijk discussie over de vraag of een AI wel kan discrimineren.
Het rapport stipt nog meer dingen aan, zoals dat AI vaak door private partijen wordt geleverd en dan totaal niet transparant is. Of dat je niet weet waar de data vandaan komt of wat men er nog meer mee doet. Ik vind dat soort dingen minstens zo ingewikkeld en juridisch vervelend.

Maar goed, discriminatie. Gewoon een neutraal woord in de wetenschap hoor, zo lees ik dan in de comments. En terecht: het betekent gewoon “onderscheid maken” en in de statistiek gebruik je dat voor iedere situatie waarin je data in groep A of B gaat onderverdelen. Maar juristen en ethici bedoelen er wat anders mee, namelijk het onderscheid maken op basis van verboden kenmerken zoals etnische afkomst, seksuele gerichtheid of politieke voorkeur. Dat willen we niet, en daar is een hele goede reden voor: deze kenmerken zijn fundamentele waarden van mensen, en ook niet te wijzigen zoals een kledingkeuze of zelfs woonplaats. Daar blijf je dus af.

Bovendien is er nooit enig oorzakelijk verband aangetoond tussen die kenmerken en welk gedrag dan ook. Iedere uitspraak van het soort “mensen met etnisch kenmerk X willen/hebben/kunnen/haten” is dus automatisch fout, dat is gewoon geen kenmerk waar je uitspraken op kunt baseren. Oké, heel misschien medische kenmerken (kroeshaar is lastiger te scheren, Aziaten verdragen koemelk niet) maar dat zijn echt de uitzonderingen. Het soort situatie waar we het bij AI vaak over hebben, past daar niet bij.

Dat wringt, omdat we vaak AI systemen correlaties zien aanwijzen: de criminaliteit is hoger bij groepen met etnisch kenmerk X, sollicitanten met huidskleur A zijn minder geschikt, seksuele gerichtheid X gaat niet samen met lesgeven op school. Voor een AI is dat inderdaad een neutrale constatering, als dat zo in de dataset zit en de functie komt daarbij op een goed werkend onderscheid (de test-dataset wordt correct als ja of nee gesorteerd) dan is het in orde.

Zo’n conclusie is voor de maatschappij echter niet in orde. In eerste instantie niet omdat de dataset waarschijnlijk niet compleet is (dit is namelijk bij vrijwel iedere AI applicatie een ware uitspraak). Maar zelfs als je wél alle relevante data hebt, blijft er een probleem.

Natuurlijk kan een AI ook een bestaande bias blootleggen. Huidskleur blijkt bij dit bedrijf een perfecte voorspeller van geschiktheid, omdat de HR-medewerker die de sollicitanten screende, zelf die bias had. Dan heb je dus een bias geformaliseerd, maar dat kun je het systeem niet verwijten toch? Die geeft neutraal aan hoe de werkelijkheid is, hoe de maatschappij er nu uit ziet.

Maar dat is niet waar. Een mens is allereerst niet zo hard als een AI. Die zal niet snel iemand in zijn of haar gezicht zeggen, je huidskleur past niet bij dit bedrijf. Die verzint excuses, blaast een smetje op het cv op of legt het gewoon op de stapel “tweede keus” wetende dat er al tien mensen op gesprek komen. Dat merk je niet. Een AI zegt gewoon letterlijk waar het op staat, zonder schroom of vergoeilijking of excuses. En dat valt veel meer op, komt veel meer binnen.

Bovendien, en dat vind ik problematischer, heeft een AI veel meer een aura van objectiviteit, betrouwbaarheid, echtheid. De cijfers zeggen het, deze huidskleur kan gewoon niet bij dit bedrijf. Helaas, objectief berekend met 88% betrouwbaarheid en achttien cijfers achter de komma. Maar in feite hebben we hetzelfde als die HR-medewerker die het met mooie smoesjes wist te verhullen.

Arnoud

Zijn robotlawyers nuttig of juist niet voor de rechtspraktijk?

mohamedhassan / Pixabay

Slecht nieuws voor juristen, maar goed voor hun klanten: het blijkt niet nodig om juridisch werk volledig te automatiseren voordat een robot het over kan nemen. Een deel met machine learning laten doen is al genoeg. Die stelling las ik in The Conversation, dat daarmee een onderzoek afrondde naar het automatisch zoeken naar jurisprudentie om een geschil in je voordeel te bepleiten. Op zijn minst kun je de zwaar overbelaste legal aid worker (zeg maar medewerker Juridisch Loket) daarmee een flinke hand helpen. Goed idee, of niet?

Al vaak schreef ik over legal tech, maar in de praktijk gaat dat vooral over de transactiepraktijk: het samenstellen, onderhandelen, screenen en beheren van contracten, meestal zakelijk. Hier gaat het over een ander aspect, namelijk het oplossen van geschillen via rechtspraak. Dat is waar de maatschappij als geheel het meeste aan zal hebben, zeker nu we zien dat de rechtspraak meer en meer verstopt raakt, zeker in het strafrecht. Maar gaat het er ooit van komen?

Tussen 2030 en 2040 zullen computers het merendeel van de vonnissen voor hun rekening nemen, aldus professor Jaap van den Herik in 2016. Alleen bij ingewikkelde gevallen zullen nog mensen rechtspreken. Het basisidee is dan hetzelfde als wat The Conversation had bedacht: neem een berg bestaande vonnissen of pleitnota’s, en destilleer daaruit wat in een gegeven casus het beste antwoord hoort te zijn. Dit idee had e-Court trouwens in hun robotrechter gestopt specifiek voor incassozaken. En in 2018 bleek men best aardig het Europese Hof voor de Rechten van de Mens te kunnen voorspellen.

Het is alleen dat “best aardig” (bij die laatste zaak: 79% accuraat) dat in de praktijk het probleem gaat zijn. Natuurlijk maken ook menselijke rechters fouten, daar is hoger beroep immers voor. Bij grote strafzaken gaat men in 41% van de gevallen in hoger beroep, maar ik kan geen cijfers vinden over het succespercentage (als in: Hof vernietigt uitspraak rechtbank). Ik heb echter sterk het vermoeden dat mensen een foutpercentage van zeg 20% van de strafzaken (de helft van die 41%) door menselijke rechters eerder accepteren dan een robotrechter die in 80% een rechtvaardig vonnis wijst.

Het onderzoek van The Conversation laat nog een ander probleem zien: dit soort systemen drijft eigenlijk altijd op bestaande data en kan dus die data niet overstijgen. Zoals ik in 2018 al blogde, AI rechters en het juridische novum:

Uiteindelijk is de kern echter wel dat een AI alléén afgaat op de eerdere dataset. Hij leert immers alleen daaruit hoe er recht gesproken moet worden. Een afwijking van die dataset is daarbij niet te verwachten. Computers zijn immers niet creatief, en niet gevoelig voor ongewone omstandigheden, nieuwe feiten of het overtuigendste pleidooi. Dat is ook de reden waarom robotrechters alleen voor standaardwerk ingezet moeten kunnen worden, én dat er altijd ruimte moet zijn om die ongewone omstandigheden te kunnen stellen waarna een mensenrechter er naar kijkt.
Het ontlasten van die arme legal aid workers is dus in zoverre reëel dat de standaardvragen sneller gedaan kunnen worden, waardoor standaardverzoeken minder gedoe opleveren en mensen dus eerder daarmee terecht kunnen. Maar dan help je dus alleen de standaardgevallen waarvan al bekend is dat ze succes gaan opleveren. Dat is vaak toch een beperktere groep dan je denkt, zeker wanneer de maatschappij in de tussentijd verandert en je dataset nog steeds uit 2004 is.

Het lastige daarvan is natuurlijk dat dit zelden opvalt. Mensen kunnen nu al vaak niet terecht met een rechtsvraag, dus je merkt nergens aan dat mensen wegvallen. De standaardzaken gaan goed, maar dat is geen verrassing. Het zijn de rare zaken die misgaan, maar dat merkt het systeem niet. Hoe dát op te lossen?

Arnoud


Wat hebben we aan menselijk toezicht op AI?

Algoritmes zijn neutraal, dus het is beter om algoritmes beslissingen te laten nemen. Met die waangedachte wordt met allerlei Artifical Intelligence (AI) systemen geëxperimenteerd. Voor de vorm is er dan menselijk toezicht, en zoals een recent Slate-artikel betoogt, daar heb je dus helemaal niks aan. Het lijkt me beter om eens wat harder in te grijpen, zoals de Europese Commissie van plan is.
Het idee van neutraliteit “omdat het algoritmes zijn” of “omdat het uit de data volgt” vind ik absurd. De voornaamste reden is omdat de data vrijwel nooit zelf neutraal is, maar vooral de bestaande vooroordelen of aannames uit de maatschappij reflecteert. Een AI is eerder een spiegel van hoe je maatschappij functioneert, maar dan zonder de flexibiliteit of menselijke redelijkheid die in de praktijk de scherpste randjes eraf haalt.

Mooi recent voorbeeld: een bedrijf dat met gezichtsherkenning de deur bedient, maar iemand in een rolstoel zit te laag volgens het algoritme en diens hoofd wordt dus niet als hoofd aangemerkt. De deur kan dus niet open.

In april publiceerde de Europese Commissie een concept-Verordening tot regulering van artificiële intelligentie. De kern: hoe meer risico de technologie met zich meebrengt, hoe strikter de regels die ervoor gelden. Er wordt daarom een verschil gemaakt tussen vier AI-systemen:

  1. Onaanvaardbaar risico. Hierbij gaat het onder meer om AI-systemen bij de overheid die burgers “sociale scores” geven, of biometrie voor grootschalige opsporing en surveillance. Dergelijke systemen zijn gewoon verboden.
  2. Hoog risico. Denk hierbij aan systemen die mensen selecteren bij sollicitatieprocedures en de toegang van burgers tot sociale zekerheid bepalen. Deze moeten aan hoge eisen voldoen voordat ze op de markt mogen.
  3. Beperkt risico. Dit is bijvoorbeeld het geval wanneer er een duidelijk risico op manipulatie bestaat, zoals bij het gebruik van chatbots. Voor deze systemen geldt een transparantieverplichting.
  4. Minimaal risico. Dit zijn bijvoorbeeld spamfilters. Deze AI-systemen mogen blijven worden ontwikkeld en gebruikt.
Bij de niveau’s 2 en 3 is het van belang dat er mensen meekijken, die dan ook “betekenisvol toezicht” uitoefenen. Aan mensen die alleen maar constateren

Zoals je in mijn elearning AI Compliance & Governance kunt leren, staan drie begrippen dan centraal: Human in the Loop (HITL), Human on the Loop (HOTL) en Human in Control (HIC). Bij HITL loopt een mens in elke stap mee. HOTL wil zeggen dat de mens op de achtergrond meekijkt en in kan grijpen waar nodig, en HIC betekent meer toezicht op afstand op het systeem als geheel. Dus zeg maar: de portier die naast de deur zit en gauw opendoet voor die persoon in rolstoel, de portier die een verdieping verderop de bel hoort en open komt doen, en de gebouwbeheerder die achteraf de klacht per email leest.

Klinkt leuk, maar er is een probleem. Zoals Slate schrijft:

People presented with the advice of automated tools are prone to “automation bias” (through which they defer to the automated system without proper scrutiny), struggle to evaluate the quality of algorithmic advice, often discount accurate algorithmic recommendations, and exhibit racial biases in their responses to algorithms.
Voor mij is die eerste het belangrijkste. Output van computers voelt voor veel mensen als doordacht en zeker, het algoritme zal erover nagedacht hebben zeg maar. Daar wordt dus niet snel van afgeweken. En dat speelt des te meer in situaties van toezicht en handhaving, omdat daar altijd wel iets te vinden is om nader te onderzoeken. Je krijgt daardoor niet snel het gevoel dat de computer het fout had, en je onthoudt vooral de gevallen waarin de computer spectaculair gelijk had.

Een bijkomend probleem is het kunnen inschatten wat de AI bedoelt. Dan kom je bij uitlegbaarheid terecht, en daar zit ook een enorme valkuil. Een AI kan met uitleg komen, maar dat is niet meer dan een verklaring van wat voor de AI de relevante factoren zijn. Zoals ik in 2017 schreef:

Je krijgt bijvoorbeeld te horen “als Venue bevat niet Californië en lengte < 800 woorden en Aansprakelijkheid bevat niet Dientengevolge dan goedgekeurd”. Ja, dat is een uitleg maar geen mens die ooit op die manier zou uitleggen waarom het contract goedgekeurd is. Plus je mist zo wat er met andere informatie is gebeurd, was die niet belangrijk?
De valkuil is dan dat je als mens een verklaring gaat verzinnen dat een korte tekst zonder dat woord en een rechtskeuze buiten Californië een logische tekst is. Wat een jurist prima kan. Maar die verklaring is dus niet waarom het systeem het contract goedkeurde. Het systeem hééft geen verklaring, alleen correlaties, dingen die horen bij een goedgekeurd contract. Wie dan zinvolle menselijke toelichting verwacht, zal ernstig teleurgesteld worden. Of erger nog: trappen in de verklaring die de mens erbij geeft.

Arnoud

Consumentenbonden EU dienen klacht in tegen WhatsApp wegens ‘druk op gebruikers’

Verschillende Europese consumentenorganisaties hebben een klacht ingediend tegen WhatsApp, las ik bij Tweakers. Volgens de organisaties oefent de chatapp te veel druk uit op zijn gebruikers om de nieuwe gebruiksvoorwaarden en het vernieuwde privacybeleid te accepteren: ‘Je kunt niet volledig gebruikmaken van WhatsApp totdat je de updates aanvaardt. Voor een korte periode kun je nog wel oproepen en meldingen ontvangen, maar je kunt geen berichten lezen of verzenden via de app.’
Volgens de consumentenorganisaties zorgt de inhoud van de meldingen en herhaling voor onnodige druk op consumenten en belemmeren ze hun keuzevrijheid. Daarmee zijn ze in strijd met de Europese regels. Uit het persbericht:

Sandra Molenaar, directeur Consumentenbond: ‘WhatsApp dreigt consumenten de toegang tot de app te weigeren als ze de voorwaarden niet accepteren. Terwijl helemaal niet duidelijk is waar ze toestemming voor geven. WhatsApp beperkt consumenten in hun keuzevrijheid: als je niet accepteert, kun je Whatsapp niet meer gebruiken. De contractvoorwaarden zijn bovendien niet transparant. En dat is in strijd met de wet.
Dat riep vele vragen op, want hoezo mag je niet gewoon als dienstverlener je voorwaarden wijzigen en afdwingen dat men ermee akkoord gaat. Nou ja, in principe mág dat ook (contractsvrijheid) maar specifiek bij zo’n groot bedrijf die zo massaal nieuwe voorwaarden er doorheen drukt en dan ook nog eens bij consumenten, dan komt dat anders te liggen. Bij consumenten hebben we namelijk extra regels die deze zwakke marktpartij moet beschermen tegen grote kolossen zoals WhatsApp.

Het meest voor de hand ligt om het op de agressieve marktpraktijk te gooien (art. 6:193h BW):

Een handelspraktijk is in haar feitelijke context, al haar kenmerken en omstandigheden in aanmerking genomen, agressief indien door intimidatie, dwang, waaronder het gebruik van lichamelijk geweld, of ongepaste beïnvloeding, de keuzevrijheid of de vrijheid van handelen van de gemiddelde consument met betrekking tot het product aanzienlijk wordt beperkt of kan worden beperkt, waardoor de gemiddelde consument een besluit over een overeenkomst neemt of kan nemen, dat hij anders niet had genomen.
Dit is primair geschreven voor fysiek agressieve praktijken, maar zeg me dat WhatsApp niet het virtuele equivalent van deze doet:
De volgende handelspraktijken zijn onder alle omstandigheden agressief: … de indruk geven dat de consument het pand niet mag verlaten alvorens er een overeenkomst is opgesteld;
En dat is dan ook precies wat men in de formele klacht (p. 9) heeft genoemd als grond. Wat ze daarbij (terecht, denk ik) zwaar laten wegen is dat de gebruiker de melding niet weg kan klikken. Je krijgt een groot scherm met alléén een “Accepteer” knop, en afgezien van de app dan afsluiten heb je geen opties.

Nog een hele mooie is wat men in de Richtlijn oneerlijke bedingen uit 1993(!) wist te vinden:

In het geval van overeenkomsten waarvan alle of bepaalde aan de consument voorgestelde bedingen schriftelijk zijn opgesteld, moeten deze bedingen steeds duidelijk en begrijpelijk zijn opgesteld. In geval van twijfel over de betekenis van een beding, prevaleert de voor de consument gunstigste interpretatie.
U ziet daar “duidelijk en begrijpelijk” en u moet meewarig lachen, dit is niet echt een op internet gehandhaafde regel zullen we maar zeggen. Maar het staat er en is gewoon bindend Europees recht. Dus als de update van WhatsApp (inclusief haar uitleg met mooie wollige taal) niet voldoet aan die eis, dan is die niet rechtsgeldig.

Arnoud

Vrouw staat vaker voor dichte deur bij gemeenteportaal dan man

Vrijwel standaard hebben alleen mannen bij gemeenten toegang tot belangrijke privégegevens over hun huishoudens, las ik bij de Stentor. Dat blijkt uit onderzoek van de krant. Steeds vaker schuiven gemeentes burgers naar online portalen voor persoonlijke informatie, belastingaanslagen (hond, huis), heffingen (riool, reiniging) en betalingsafspraken. Detail: slechts een persoon per huishouden (de belastingplichtige) krijgt toegang en dat de gemeente bepaalt wie dat is. Die keuze is onder meer gebaseerd op ‘veronderstelde betalingscapaciteit, doelmatigheid en doeltreffendheid van heffing en invordering’. Vandaar: de man.

Oké, dat was flauw. Afgezien van Staphorst (serieus) maakt geen gemeente de bewuste keuze om de man in een huishouden als enige de toegang tot de gezamenlijke belastinginformatie en dergelijke te geven. Er is gekozen voor toegang door één persoon, en daarbij wordt per gemeente een voorkeursvolgorde ingesteld. Voorheen stond “de man” daarbij als een van de criteria, maar dat is al even weg (behalve dus in Staphorst):

In de model-beleidsregels van de VNG voor het aanwijzen van een belastingplichtige is de gemene deler in de volgorde van kiezen nu zo: degene die het meeste eigendom heeft, een natuurlijk persoon boven een niet-natuurlijk persoon en de oudste ingeschrevene op het adres.
U mag nu even alle samenwonenden in uw omgeving langs deze lat leggen: wedden dat bij 80% of meer daarvan de man hier uit komt? In de meeste relaties is het huis of van de man of gezamenlijk en is de man ouder dan de vrouw. Een mooi voorbeeld van onbewuste bias zoals we die ook in de AI kennen: niemand bedóelt dat de man als enige die gegevens moet kunnen beheren, het komt alleen er zo uit (meestal) en omdat niemand heeft nagedacht dat dat onwenselijk is, is er dus geen procedure om dit eerlijker te maken:
Ook al ben je geboren en getogen in deze gemeente, en al 33 jaar getrouwd met dezelfde partner, woon je al die tijd samen in een huis dat gemeenschappelijk eigendom is en betaal je keurig op tijd de rekeningen, als jij de uitverkorene niet bent, is het systeem niet aardig tegen je en meldt het doodleuk: de ingelogde gebruiker is niet bekend.
Wat is dan wel de reden? Het lijkt een IT-keuze te zijn geweest, maar er zit iets juridisch achter. Beschikkingen zoals een aanslag onroerendezaakbelasting moeten op naam gesteld worden, je kunt niet aan “de familie Ten Brink” een aanslag richten want juridisch bestaat niet. Juridisch gezien hebben we op de Terwekselsestraat 1 de burgers Wim en Kornelia Ten Brink wonen, die een gedeelde huishouding hebben. Aan twee personen dezelfde aanslag uitreiken leidt tot gedoe zoals dubbele betalingen (of erger nog: burgers die gaan klagen dat ze twee keer moeten betalen). Daarom is zo veronderstel ik het IT-systeem ontworpen met een keuze welke van de twee burgers aangeslagen wordt.

Ja, ik zou ook denken dat enkel kíjken naar de status van een en ander geen probleem moet zijn. Je weet via de BRP of mensen gehuwd/GP zijn, en dan kun je ze (na inloggen met DigiD) toegang geven tot de informatie waartoe ze gerechtigd zijn. Je zou dan zelfs iets kunnen bouwen waarbij de eerste van het stel die de aanslag ‘pakt’ als enige ermee verder mag, of een algemene keuze inbouwen “wie van u gaat de financiën doen”. Maar dat is complex en vereist vele, vele koppelingen en dubbelchecks. Weinig dingen zo vervelend als dergelijke IT-projecten. Dus ik snap wel dat gemeenten kiezen voor de iets simpeler oplossing van zelf iemand aanwijzen.

Arnoud

De AI Hall of Shame laat zien waarom AI compliance officers nodig zijn

Heb je je wel eens afgevraagd hoe deze innovatie bijdraagt aan een afschuwelijke dystopie? Zo prikkelt machine learning engineer Sean McGregor zijn collega’s als die weer eens enthousiast doen over de inzet van AI voor het een of ander. Want maar al te vaak blijkt een goed idee uiteindelijk vooral nadelen voor kwetsbare mensen op te leveren of nodeloze rechtlijnigheid te introduceren in een op zich prima werkend menselijk proces. En om dat kracht bij te zetten, onderhoudt hij sinds een tijdje de AI Incident Database.
Zoals de site het zelf toelicht:

The AI Incident Database is a collection of harms or near harms realized in the real world by the deployment of intelligent systems. You are invited to submit reports to the database, whereupon accepted incidents will be indexed and made discoverable to people developing and deploying the next generation of AI technology to the world. Artificial intelligence will only be a benefit to people and society if we collectively record and learn from its failings. Learn more about the database, or read about it on the PAI Blog, Vice News, Venture Beat, and arXiv among other outlets.
Soms gaat het om gewoon hilarische storingen, zoals een surveillancerobot die zichzelf de fontein in rijdt omdat hij water niet van tegels kon onderscheiden. Wat ook weer heel naar kan uitpakken, zoals bij de lasrobot die niet geprogrammeerd was om mensen te vermijden – en iemand doodde toen die een losgelaten metalen plaat wilde verwijderen.

De pijn zit hem vaker niet in zulke extreme dingen, maar in de vaak schimmige manier waarop een AI tot haar conclusie komt. Bijvoorbeeld omdat je geen uitleg krijgt, zoals bij incident 96 waar een door de fabrikant geheimgehouden algoritme leraren beoordeelt en laat ontslaan. Of bij incident 78, waar een studente geweigerd werd bij geneeskunde in Duitsland omdat de AI had ingeschat dat ze lage cijfers zou halen. Of bij incident 95 waarin gezichts- en stemanalyse ertoe leidt dat sollicitanten geweigerd worden.

Die laatste is interessant omdat de gebruikte data is geanalyseerd en vrij van bias zou zijn bevonden. Ja, ik ben skeptisch want ik geloof dat niet – bijvoorbeeld omdat ik me niet kan voorstellen dat men bij stemanalyses de moeite neemt om stotteraars of mensen met slokdarmspraak te vragen om een representatieve hoeveelheid data aan te leveren.  (De kans is groter dat men het ding op porno getraind heeft, daar is immers veel sneller een grote hoeveelheid data voor te krijgen.)

Dat gebrek aan representativiteit zie je vaak opduiken. Bijvoorbeeld in incident 48, waarbij paspoortfoto’s worden gescreend op “ogen volledig open” wat natuurlijk misgaat bij Aziatische mensen. Die overigens ook niet hoog scoren in beauty contests waarbij een AI de jury speelt. Op het gorilla-incident van Google hoef ik al helemaal niet op in te gaan. Het aantal voorbeelden is talrijk.

De vraag is, hoe moet het dan wel. Daar zijn alweer eventjes geleden de EU Ethics Guidelines for trustworthy AI voor geformuleerd. Deze bevatten geen juridische eisen (die komen er wel aan, de Verordening AI) maar juist ethische kaders: hoe moet het wel, wat mag de burger verwachten en wat moet een bouwer of gebruiker van AI aan verplichtingen op zich nemen.

Wie wil leren hoe dat werkt: op 20 september start mijn tienweekse cursus AI Compliance in de praktijk weer. Leer in je eigen tijd (ongeveer 4 uur per week) de techniek én de ethische kaders rondom AI, met echte cases en echte data. Ik laat je zoeken naar bias in een dataset met leningaanvragen of puzzelen over waarom een snel en vrijwillig AI-loket bij de gemeente in strijd is met de mensenrechten. En ondertussen zet je je ook in om de gemeente Juinen met haar miljoenen kostende AI initiatieven hoog in de wereldranglijst te krijgen. Wees er snel bij!

Arnoud


Wat moet ik me voorstellen bij een 91% accurate lawyerbot? #legaltechtuesday

Na de lancering van lawyerbot Lynn kreeg ik veel reacties, waarbij ik één onderwerp eruit wilde lichten: hoe zit dat met die accuratesse, wat betekent het dat Lynn 91% accuraat een document screent? Hoe meet je überhaupt “accuraat” bij een juridische screening?

Om even met het getal te beginnen: die 91% is eigenlijk de F1-score of F1-maat uit de statistiek. Deze formule zoekt een balans tussen enerzijds de precisie (het percentage werkelijk correct gelabelde clausules) en de vangst of recall (het percentage correct positief gelabelde clausules), en dat zijn dan weer twee maten die iets zeggen over de kwaliteit.

De kern is dat deze maat ongevoeliger is dan bijvoorbeeld alleen kijken naar het aantal correcte labels. Computers zijn grappig wat dat betreft: als je stuurt op “ik wil 100% correcte labels” dan krijg je één label dat correct is, dat is namelijk honderd procent. En zeg je, ik wil niets missen uit categorie X, dan wordt je hele contract als X aangemerkt want dan heb je in ieder geval niets gemist. Volgens het boekje kun je dan beter naar de F1 score kijken, dus dat doe ik dan maar.

Je kunt natuurlijk nog een stapje dieper gaan. Wat is erger, een clausule missen (overslaan, niet relevant) die buitengewoon pijnlijk was, of een clausule verkeerd labelen? Of de clausule wel herkennen maar als onschuldige variant aanmerken? En maakt het dan uit of je aansprakelijkheid miste maar het wijzigingsbeding-als-de-AVG-verandert netjes aanwees, of andersom?

Wat me daarbij opvalt is dat de zorg over fouten bij lawyerbots hoog zit bij veel mensen. En dat snap ik, want we hebben allemaal een zekere onbewuste angst voor dingen die automatisch iets doen, helemaal als dat mensachtig werk is. Wat dan precies de angst is (wat is erger) dat verschilt bij personen.

Is het een gekke gedachte dat niemand dit ooit zo verifieert bij een menselijke jurist? Die wordt ook getraind met een grote trainingset, al het werk dat hij onder begeleiding van een collega/partner uitvoert. Maar niemand die ooit vraagt, laat eens zien welke NDA’s jij de afgelopen tien jaar hebt gereviewd zodat ik weet hoe goed jij bent in het inschatten van fouten en nasty clausules. Waarom moet een AI dat dan wel kunnen laten zien? Nieuwigheid dus bewijs maar dat je beter bent?

Arnoud

Politie arresteert man op verdenking ‘pump en dump’ met zelfgemaakte cryptocoins

De Nederlandse politie heeft een man van 39 uit Deventer aangehouden op verdenking van grootschalige oplichting met zelfgemaakte cryptovaluta. Dat las ik bij Tweakers. In het jargon heet dit een “pump and dump scheme”: je praat de koers omhoog en daarna verkoop je snel je eigen voorraad, waarna je er met het geld vandoor gaat en iedereen ineens door een koersdaling gedupeerd is. Dat is niet hetzelfde als speculeren, omdat de koers hier kunstmatig opgedreven werd. En dat kan dus ook bij cryptomunten, hoewel die niet onder de Wet financieel toezicht vallen.

De cryptowereld kent ondertussen een heleboel shady figuren, die op allerlei manieren proberen mensen geld afhandig te maken door ze te pushen “nu in te stappen”. De NOS had er een mooi achtergrondartikel over. Nou is dat op zich natuurlijk legaal – handig naïeve mensen bespelen is moreel niet echt netjes maar dat is wat anders. Maar dit soort trucs evolueren snel tot “koop zelf goedkoop, laat anderen instappen en verkoop zodra de koers omhoog gegaan is door hun aankopen”. En dát is wel een juridisch probleem.

In eerste instantie dacht ik, waarom is het de politie en niet de AFM die ingrijpt. Maar bij nader inzien logisch natuurlijk: cryptomunten vallen buiten de Wft omdat ze geen financiële instrumenten in de zin van die wet zijn. En dan valt dus handhaving op grond van art. 5:58 Wft af.

In het persbericht spreekt de politie van oplichting, wat me een tikje verrast omdat er gewoon een specifiek artikel in het Wetboek van Strafrecht is dat hierover gaat, namelijk art. 334:

Hij die, met het oogmerk om zich of een ander wederrechtelijk te bevoordelen, door het verspreiden van een leugenachtig bericht de prijs van koopwaren, fondsen of geldswaardig papier doet stijgen of dalen, wordt gestraft met gevangenisstraf van ten hoogste twee jaren of geldboete van de vijfde categorie.
Mogelijk dat men twijfelt of een cryptomunt een “koopwaar of fonds” is? In ieder geval is er jurisprudentie dat het verspreiden van half-ware berichten ook “leugenachtig” oplevert – zeggen dat de koers aan het stijgen is door een groot aantal aankopen, waarbij je niet zegt dat jij de persoon bent die die aankopen doet.

Wanneer je het oplichting noemt, kom je volgens art. 326 Strafrecht aan de vraag of je handelt

door het aannemen van een valse naam of van een valse hoedanigheid, hetzij door listige kunstgrepen, hetzij door een samenweefsel van verdichtsels.
Ik zou het dan op dat laatste gooien, daarmee wordt namelijk grofweg bedoeld zo veel mooie verzonnen praatjes dat mensen je gaan geloven en doen wat je zegt. De vaste jurisprudentie is dat je laat meewegen:
de vertrouwenwekkende aard, het aantal en de indringendheid van de (geheel of gedeeltelijk) onware mededelingen in hun onderlinge samenhang, de mate waarin de in het algemeen in het maatschappelijk verkeer vereiste omzichtigheid degene tot wie de mededelingen zijn gericht aanleiding had moeten geven de onwaarheid te onderkennen of zich daardoor niet te laten bedriegen en de persoonlijkheid van het slachtoffer.
Omdat bitcoins en andere cryptovaluta ‘goederen’ zijn in de zin van het strafrecht (de Runescape-zaak), voldoe je ook aan de eis dat men iemand beweegt tot afgifte van “enig goed”.

De tegenwerping is natuurlijk dat iedereen die met crypto bezig gaat, moet weten dat het gaat om speculatie op zeer snel op en neer bewegende koersen. Het kan bij iedere munt gebeuren dat je net instapt voor een crash, pardon dipje, al dan niet veroorzaakt doordat Elon Musk een emoji twittert. Dat is dan gewoon pech, en dat je adviseur wél net goed in- en uitstapte dat is dan wrang, meer niet.

Het gaat uiteindelijk echter om het oogmerk van de adviseur en om het kunstmatig karakter van de koersstijging. Dat is wat het oneerlijk maakt. De koers van die cryptomunt stijgt niet omdat de markt deze meer waard vindt, maar omdat iemand allemaal mensen voor het lapje houdt waardoor die gaan kopen. Zo’n self fulfilling prophecy is geen marktwerking maar oplichting. En als dat ook nog eens de bedóeling was van de adviseur, dan overtreedt zhij de strafwet.

Dit bewijs zal natuurlijk lastig zijn, als deze verdachte slim is en de mond houdt over motieven. Je houdt dan over dat er afgezien van deze persoon geen kopers waren tot het moment dat de reclame begon, en toen eigenlijk alleen de door deze persoon benaderde mensen aan het kopen sloegen, waarna de verdachte als eerste én grootschalig de cryptomunt verkocht. Ik kan dat niet anders zien dan lekker de winst pakken die je zelf gecreëerd hebt met je mooie praatjes, en dat is dus een vorm van oplichting.

Arnoud