Jaja, die rechter die ChatGPT gebruikte, wat gaan we daar van vinden?

Photo by ELG21 on Pixabay

Het is het gesprek van de dag onder juristen: het AI-programma ChatGPT is voor het eerst als bron genoemd in een uitspraak door een Nederlandse rechter. Zo vatte het FD de ophef van de dag (van vorige week samen). In een vonnis over rendementsverlies van zonnepanelen schatte de rechter de gemiddelde levensduur van zonnepanelen uit 2009 met behulp van ChatGPT.

Een keer moet de eerste keer zijn, en op zich is dit niet héél spannend. Het ging niet om een feitenonderzoek of het opbouwen van een juridische redenering (dit zou een hoogrisico-toepassing onder de AI Act zijn), maar om het achterhalen van een schatting. Om precies te zijn:

De kantonrechter schat, mede met behulp van ChatGPT, de gemiddelde levensduur van zonnepanelen uit 2009 op 25 à 30 jaar; die levensduur wordt daarom hier op 27,5 jaar gesteld.
Dit is nodig om het rendementsverlies over de resterende levensduur te kunnen berekenen. Dat is verder niet zo belangrijk, waar het hier om gaat is: kun je ChatGPT voor zo’n feitenonderzoek inzetten?

Enerzijds: we weten allemaal dat dit soort grote taalmodellen nog geen feit zou herkennen als het zichzelf paars had geverfd en naakt zou dansen op een klavecimbel. Het systeem genereert een stelsel van woorden op basis van waarschijnlijkheden, en dat is het. Geen redeneerregels, geen rekencapaciteit en geen besef van concepten. Na ‘gemiddelde’ komt vaak ‘levensduur’ en na ‘levensduur’ komt vrijwel altijd ‘van’.

Anderzijds: die waarschijnlijkheden komen niet uit de lucht vallen maar zijn gebaseerd wat Mensen Op Het Internet allemaal vinden. Je zou dan dus kunnen zeggen, de uitvoer van ChatGPT is grofweg de consensus over hoe je iets zegt, dit is gemiddeld wat men vindt. En op internet zégt iedereen dat de gemiddelde levensduur van zonnepanelen 25 à 30 jaar is, dus dat zal dan wel de consensus zijn.

Waarom deed de rechter dit eigenlijk? De eiser had een “moeilijk volgbare eigen berekening in de dagvaarding opgenomen” over wat de schade is (onder meer iets met gemiste subsidie). Wat de gedaagde aan schade had geschat zie ik niet terug. Het had mij dan logisch geleken om te zeggen, de schade is niet goed onderbouwd dus niet aangetoond, maar mogelijk dat de rechter dat te cru vond.

Echter, al in 2011 bepaalde de Hoge Raad dat rechters niet mogen googelen:

[de rechter mag geen] eigener beweging verkregen feitelijke gegevens aan zijn beslissing ten grondslag mag leggen zonder partijen in de gelegenheid te stellen daarvan kennis te nemen en zich daarover desgewenst uit te laten.
Als dit was gebeurd, had ik het een stuk minder opmerkelijk gevonden: heren, dit is de consensus voor wat betreft de levensduur, en dan kom je uit op dit schadebedrag, graag uw commentaar. Wie dan vindt dat de GPT-schatting van de consensus niet klopt, kan daar dan op reageren.

Arnoud


Valt jouw AI toepassing vanaf vandaag ook onder de AI Act?

Photo by Hans-Peter Gauster on Unsplash

Het is eindelijk zo ver: de AI Act is van kracht. Daarmee is een periode van zes maanden en eentje van twee jaar begonnen waarbinnen je aan deze nieuwe wet moet gaan voldoen met AI in je organisatie. En ik kan je vertellen, dat is een hele puzzel.

Grofweg liggen er voor organisaties (al dan niet geholpen met een CAICO® compliance officer) drie hoofdtaken:

  1. Uiterlijk februari: Inventariseer en stop met de verboden praktijken.
  2. Uiterlijk februari: Heb een AI geletterdheid programma op poten voor je medewerkers.
  3. Uiterlijk over twee jaar: Weet welke AI hoogrisico is en heb beheersmaatregelen staan.
De AI Act gaat op hoofdlijnen uit van het makkelijke geval. Er is een aanbieder of leverancier van een AI systeem in een doos, jij als gebruiksverantwoordelijke koopt die doos en zet de AI aan. Maar de praktijk is natuurlijk vaak genoeg niet zo.

Het meest voorkomende scenario is dat je als organisatie ergens een AI model vandaan haalt of een algemene AI fine-tunet voor je eigen toepassing. Wie krijgt dan met welke regels te maken?

De oplossing staat in artikel 25: je wordt ‘aanbieder’ (met de gehele berg aan compliance erbij) van een AI systeem als je

  1. Een bestaand hoogrisico AI systeem onder je eigen naam gebruikt of verder verspreidt;
  2. Een “substantiële” aanpassing doet aan een bestaand hoogrisico AI systeem;
  3. Je verandert het beoogd gebruik van een bestaand AI systeem naar een hoogrisico toepassing.
Het is met name optie 3 die de praktijk het meest zal raken. Wat er immers voornamelijk op de markt is, zijn zogeheten general-purpose AI systemen, systemen die drijven op een algemeen AI model maar wel gewoon als product of dienst inzetbaar zijn. De chatinterface van Claude of de API van ChatGPT bijvoorbeeld. We noemen dat wel vaak ‘modellen’, maar de AI Act noemt het een systeem zodra het een bruikbare oplossing is.

Een simpel voorbeeld: wie een eigen Copilot bouwt op basis van de Microsoft-dienst, komt in de situatie van optie 3 terecht. De enige open vraag is dan nog of je er een hoogrisico-toepassing mee realiseert. Een chatbot die je kennisbank vervangt is dat niet, een cv-screener voor de HR-afdeling is dat wel.

Mocht je bezig zijn met een eigen taalmodel (of ander AI model) te bouwen, of een bestaand model uit te breiden, dan heb je iets meer rek. Een “eigen model” voor “zuiver interne processen die niet essentieel zijn” voor de bedrijfsvoering of raken aan grondrechten, blijft buiten de AI Act.

Het grootste probleem voor nu zal zijn achterhalen waar allemaal AI processen actief zijn. Je mag daarbij de ophef vergeten over beslisbomen, Excelfilters en dergelijke randgevallen waar bij introductie van de AI Act ophef over was. De finale definitie kent vier componenten:

  • Het systeem opereert met enige autonomie
  • Het systeem heeft een specifieke doelstelling
  • Het systeem leidt zelf de regels af om van invoer tot uitvoer te komen
  • Het systeem heeft de capaciteit de omgeving te beïnvloeden met de uitvoer
Wat de AI Act “traditionele software- of programmeerbenaderingen” noemt, blijven hier per definitie buiten. Een beslisboom die door mensen is opgesteld, wordt dus geen AI systeem bijvoorbeeld. Een ML algoritme een beslislijn laten trekken in een dataset, en die lijn als criterium in je applicatie opnemen, is dat wél.

Hulp nodig bij onderzoek en implementatie? Gebruik onze gratis AI Act Checklist!

Arnoud

Wat is er juridisch mogelijk tegen nepauteurs en nepartikelen in al dan niet nepjournals?

Photo by Pixabay on Pexels

Academisch publiceren wordt steeds meer bedreigd door onwetenschappelijke krachten, zo opende een artikel over fictieve artikelen en/of auteurs recent. Dergelijke neppublicaties zijn sterk in opkomst, uiteraard dankzij generatieve AI dat wetenschappelijk klinkende tekst per strekkende meter produceert inclusief mooie bronvermeldingen. Is er juridisch wat aan te doen, zo vraagt de auteur zich af.

Nepartikelen en zelfs nepauteurs zijn van alle tijden, moet je dan als jurist zeggen, maar de laatste tijd loopt het wel de spuigaten uit. Bij Retraction Watch las ik zelfs dat drie tijdschriften in de CiteScore top 10 geheel nep zijn:

These journals are filled with automatically generated papers, all using the same template, extensively using buzzwords such as “blockchain,” “metaverse,” “deep learning,” “immersive visualization,” “neuro-engineering technologies,” and “internet of things.” Most papers claim to examine the recently published literature on these topics by “a quantitative literature review of the main databases.” They also claim to analyze initially (always!) between 170 and 180 articles that satisfied the undisclosed “eligibility criteria.”
Of Rian van Rijbroek heeft een nieuwe baan, of hier zijn mensen zeer creatief met ChatGPT aan de slag geweest.

Het onderliggende probleem is dat vrijwel alle waardering voor wetenschappelijke papers automatisch berekend wordt. Het tellen van citations is de bekendste manier. En een tijdschrift lift daar weer op mee: hoe vaker er uit dat tijdschrift wordt geciteerd, hoe beter het wel zal moeten zijn. Dus ja, als je dan steeds je eerdere nepartikelen citeert en nieuwe artikelen rechtstreeks uit de API live zet, dan kom je als tijdschrift al snel in de top 10.

Dit doet pijn, niet alleen door de vervuiling maar ook omdat wetenschappers afgerekend worden op publiceren in de “goede” tijdschriften. Die top 10 van CiteScore is een metric om te bepalen of een tijdschrift “goed” is, en daar staan nu dus nog maar zeven tijdschriften in waar je als mens in zou willen staan.

Nepnieuws dus, om de juridische term te gebruiken. Het probleem is dat nepnieuws an sich niet strafbaar is. Wie goedkoop buzzword-gebrabbel wil publiceren, en dat zelf kan organiseren, moet dat vooral doen. De markt lost dat vanzelf wel op, want wie wil er abonnementen nemen op zo’n tijdschrift?

Ik ben er nog niet helemaal achter wat het businessmodel is hier. Ik denk het verleiden van onoplettende wetenschappers om hier te publiceren – vraag 300 euro “review fee” en publiceer daarna ongezien. Strafbaar is dat niet echt, je krijgt een publicatie dus oplichting is moeilijk hard te maken. Ik zie ook zo snel geen misleidende beloftes zoals dat topresearchers een peer review gaan doen.

Het doet denken aan de oude problematiek van de bedrijfsgidsen, maar daar was de misleiding groter: die vragen of je je gegevens wilt checken en leggen jouw “het klopt” uit als een akkoord op een betaald abonnement van 1500 euro per jaar voor vijf jaar zonder tussentijdse opzegging.

Hier zie ik echt niet meteen een juridisch haakje om tegen deze publicaties op te treden. De enige echte route is die van de Digital Services Act – merk dit aan als een systeemrisico. Alleen zijn de aanbieders van CiteScore en collega’s geen groot platform dat een dergelijke plicht heeft. Dat wringt, want dit ís een systeemrisico. Alleen is er niemand voor verantwoordelijk.

Arnoud


VK neemt wet aan waarmee zelfrijdende voertuigen vanaf 2026 zijn toegestaan

Photo by Annie Spratt on Unsplash

Het Verenigd Koninkrijk heeft een wet aangenomen waardoor zelfrijdende voertuigen vanaf 2026 toegestaan zijn op de openbare weg. Dat meldde Tweakers afgelopen weekend. De Automated Vehicles Act 2024 is bij mijn weten wereldwijd de eerste wet die bepaalt dat een auto onbestuurd de weg op mag “[if it] satisfies the self-driving test by reference to intended travel on a road”. Hoe ziet die wet eruit?

De wet ziet er op het eerste gezicht goed doordacht uit. Er moet een kader komen (zeg maar door de Rijksdienst voor het Wegverkeer) waarmee vast te stellen is dat de veiligheid van een geautomatiseerd voertuig gelijkwaardig is aan of hoger dan die van zorgvuldige en competente menselijke bestuurders. Vervolgens mag een fabrikant toetsen aan dat kader, en als dat goed gaat dan mag de auto de weg op.

De toetsing kan voor de auto als geheel maar ook feature-gewijs, bijvoorbeeld alleen op de snelweg, alleen autonoom inparkeren of alleen met maximaal 5km/uur op een parkeerterrein naar de eigenaar toe rijden.

Wel moet er te allen tijde een persoon als de “authorised self-driving entity” aangewezen zijn. Deze persoon moet van goede reputatie en financiële standing zijn en ook overigens in staat de verplichtingen na te komen. Dat betekent zo veel als “bezit een geldig rijbewijs en is verzekerd”, en dit is niet perse de persoon in de auto die kan ingrijpen. Het zal eerder de eigenaar zijn, zoals een taxibedrijf dat de auto’s de weg op stuurt.

De aansprakelijkheid is apart geregeld. Grofweg ben je als bestuurder strafrechtelijk niet aansprakelijk als het een autonome handeling was die valt binnen de goedkeuring.  Minstens zo interessant is de civiele aansprakelijkheid, dit is nog niet helemaal uitgewerkt en zal neerkomen op een verzekeringsregeling. Er zijn wel expliciete verhaalsmogelijkheden voor managers en directeuren bij de fabrikant.

Als raamwerk een mooie opzet, dat net wat verder gaat dan de EU-regels die primair inzetten op veiligheid en certificering maar nog geen regels hebben over aansprakelijkheid als zo’n zelfrijdend voertuig een ongeluk veroorzaakt. Dit zal meegenomen worden in de AI Liability Directive waar nu hard aan gewerkt wordt.

In de comments de intrigerende vraag: gaat dit wel werken, zeker in steden? Als je als voetganger/fietser weet dat zo’n autonoom voertuig altijd voor veilig gaat (wat toch zal moeten), dan kun je dus gewoon rood licht negeren, voorrang pakken en andere gevaarlijke handelingen – de AI zal altijd tijdig ingrijpen. Plat gezegd: met genoeg autonome voertuigen wordt iedere stad autovrij, want die auto’s staan dan de hele dag te wachten terwijl de voetgangers overal lopen.

Arnoud

Onderzoek en ontwikkeling onder de AI Act: wat mag er nog?

Een lezer vroeg me:

Ik werk als onderzoeker aan AI en maak me zorgen over de nieuwe regels van de AI Verordening. Waar moet ik rekening mee houden?
De AI Verordening of AI Act bevat stevige regels voor wat deze wet “hoog-risico AI” noemt. De achtergrond van deze wet is die van productveiligheid, wat ook meteen maakt dat zaken die weinig met productie en vermarkten van producten (of diensten) te maken hebben, er gauw buiten vallen.

Wie de AI Act openslaat bij artikel 2 lid 6, ziet bijvoorbeeld:

Deze verordening is niet van toepassing op AI-systemen of AI-modellen, met inbegrip van hun output, die specifiek zijn ontwikkeld en in gebruik gesteld met wetenschappelijk onderzoek en wetenschappelijke ontwikkeling als enig doel.
Toch is het zo simpel nog niet als dat alle vormen van R&D zijn uitgezonderd. Het probleem is namelijk dat de AI Act niet definieert wat “wetenschappelijk onderzoek en ontwikkeling” inhoudt, of wat het betekent dat je dit “als enig doel” doet versus ook bijvoorbeeld met het doel van marktintroductie er naast.

Even verderop bepaalt de Act nog een keer dat zij niet van toepassing is op “onderzoeks-, test- of ontwikkelingsactiviteiten” zolang het nog niet gaat om producten of diensten die op de markt zijn. Dit komt grofweg neer op het zakelijk aanbieden van producten of diensten, hoewel ook gratis aanbieden (bijvoorbeeld met advertenties) er onder valt. De resultaten van wetenschappelijk onderzoek publiceren zal daar niet onder vallen. Een als experiment opgezette dienst na onverwacht succes voorzien van advertenties en zo gratis weggeven zal dat daarentegen wél doen.

Arnoud

Herman van Veen slaat alarm om diefstal eigen stem, Tweede Kamer wil ingrijpen bij AI-app Udio

Photo by Andy Makely on Unsplash

Een meerderheid van de Tweede Kamer wil actie ondernemen tegen de grootschalige ‘diefstal’ van stemmen en teksten van Nederlandse artiesten en tekstschrijvers door aanbieders van kunstmatige intelligentie. Dat meldde het AD onlangs. Apps zoals Udio kunnen middels AI liedjes maken met de stemmen van bekende artiesten, zoals Herman van Veen die zich hier erg kwaad over maakt.

Het artikel noemt twee juridische routes en stelt verder dat de Tweede Kamer iets kan doen om de positie van artiesten en tekstschrijvers kan verbeteren. Allereerst de Digital Services Act: deze regelt het verwijderen van illegale content (notice/action) en verplicht tot transparantie over de werking van algoritmen. Of Udio daaraan voldoet is de vraag, maar belangrijker: het is zeker niet gezegd dat een liedje “in de stijl van” of “klinkend zoals” onrechtmatig is en dus verwijderd zou moeten worden.

Dan komt ook de AI Act langs:

Het CDA wijst naar nog een andere wet: de Europese AI Act, een wet die vanaf 2025 eist dat creatieve makers eerst toestemming moeten geven. ,,De opkomst van Udio laat zien dat er geen tijd te verliezen is om die te vertalen naar concrete regels”, waarschuwt CDA-Kamerlid Herman Krul.
Ik denk dat hier sprake is van een misverstand, want de AI Act zegt alleen dat de producenten van algemene AI modellen (zoals LLaMa of GPT) iets met auteursrecht moeten en dan ook nog eens alleen in de vorm van een duidelijk beleid over hoe zij aan de wet voldoen. Toestemming vragen is zeer zeker niet genoemd in de AI Act.

Ook wie de Auteurswet erbij pakt, komt niet uit bij toestemming. Deze wet kent namelijk een uitzondering voor tekst- en datamining, die neerkomt op “je mag een AI trainen met auteursrechtelijk beschermde data”. De uitzondering daar weer op is als het auteursrecht op machinaal leesbare manier is voorbehouden – en dát kan alleen als er een standaard is over hoe je dat voorbehoud maakt. In een tekstbestand de letters op een rij zetten “Auteursrecht voorbehouden” is geen machinaal leesbaar voorbehoud. Dat is dus nog een probleem.

Meer algemeen is mij niet duidelijk wat de Tweede Kamer zou moeten doen aan dit probleem. Het auteursrecht is Europees geregeld, en onze wetgever kan en mag geen eigen regels aannemen die strenger zijn op dit punt. Ook collectief beheer (AI voor muziekuitvoer trainen mag mits Buma/Stemra geld krijgt) is niet mogelijk binnen het Europese stelsel.

De AI Act is ook een Europese wet, net als de DSA, en beiden bieden geen optie om aparte auteursrechtregels of toestemmingsvereisten in te voeren. De enige route die ik kan bedenken is dat de DSA-toezichthouder ACM via de open norm van een systemic risk assessment bij de app-aanbieders afdwingt dat deze anders met auteursrecht omgaan. Maar dat kan alleen als die apps VLOP zijn (zeer groot online platform), en volgens mij voldoen die bij lange na niet aan deze definitie.

Daar komt bij dat de ACM nog steeds niet formeel aangewezen is als toezichthouder onder de DSA. Dat is dan weer wél iets dat de Tweede Kamer snel zou kunnen regelen, overigens.

Arnoud


Zullen we héél erg alsjeblieft niet gaan beginnen met AI-verklaringen op je website?

Kennelijk zat er iets in het water, want afgelopen week zag ik het óveral: de AI verklaring. Ik snap dat mensen iets willen doen en dat de privacyverklaring een prettig en bekend iets is, maar ik wil dit graag per direct de kop indrukken want het hoeft niet van de Act, is niet interessant voor je bezoekers en voegt nul toe aan wat je wél moet doen. Dus nee.

De AI verklaring is bedoeld als analogie met de privacyverklaring. De diverse varianten die ik heb gezien, benoemen ook keurig onderwerpen die je in de AI Act langs ziet komen: waarom gebruiken we AI, welke beveiliging hebben we hierop, hoe kun je klagen of recht van uitleg krijgen (art. 86 AIA) en vele mooie woorden over het nastreven van afwezigheid van bias.

Moet dit van de AI Act? Welnee. Er staan geen informatieplichten in naar gebruikers of betrokkenen (“affected persons”). Je moet transparant zijn dát je met een AI te maken hebt (art. 50) en als een AI een beslissing neemt heb je recht op uitleg (art. 86), en dat is het wel zo’n beetje. Voor de rest gaat de AI Act er van uit dat je AI gewoon netjes werkt; dat hoef je niet te verklaren want als ie dat niet doet (bv. vanwege bias) dan mag het ding de markt niet op.

Eigenlijk was de privacyverklaring zelf ook altijd al een slecht idee. En nee, die moest niet van de AVG en ook niet van de Wbp. Je moest informatie verstrekken over wat je verzamelt en wat je ermee doet, maar dat hoefde zeer zeker niet als een dik boekwerk.

Die specifieke praktijk komt uit de VS: de FTC had ooit geoordeeld dat het een oneerlijke handelspraktijk is als je niet expliciet uitlegt wat voor persoonlijke informatie je verzamelt en waarom. En in de VS is een dik onleesbaar boekwerk neerplempen een geaccepteerde praktijk – jij als consument moet maar goed lezen en anders ben je gewoon de pineut.

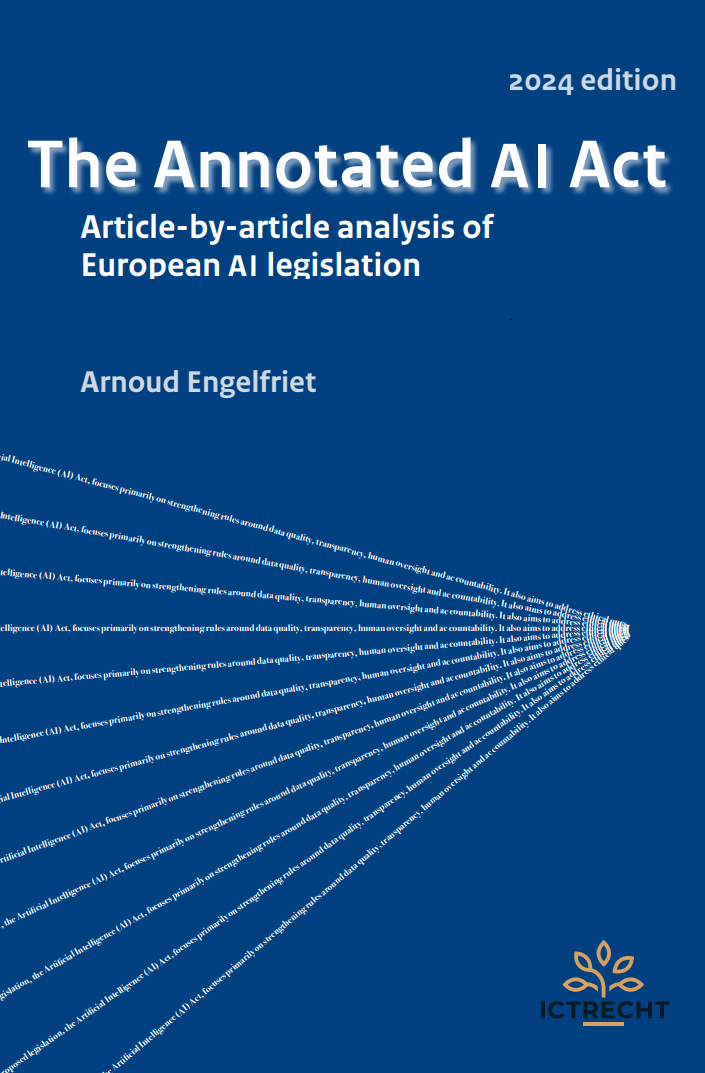
(Wat er wél moet onder de AI Act lees je in mijn nieuwe boek The Annotated AI Act, pre-order is nu al mogelijk.)

Arnoud


Creatief mixen van AI output kan je auteursrecht op het resultaat geven

Photo by ROMAN ODINTSOV on Pexels

Elisa Shupe werd aanvankelijk afgewezen toen ze probeerde auteursrecht te verkrijgen op een boek dat ze met hulp van ChatGPT had geschreven, las ik bij Wired. Toch is het haar gelukt, zij het niet met de argumentatie die ze liever had gehad. Het lijkt wel de jurisprudentie te bestendigen tot nu toe.

Het artikel legt uit:

Het [logboek van Shupe] bevat een vergelijking naast elkaar van de onbewerkte machine-uitvoer en de definitieve versie van Shupe’s boek. Op zinsniveau paste ze vrijwel elke regel op de een of andere manier aan, van veranderingen in woordkeuze tot structuur. Een voorbeeld dat een personage in de roman beschrijft: ‘Mark keek naar haar, een complexe mix van bezorgdheid en ergernis duidelijk zichtbaar in zijn blik’ wordt ‘Mark bestudeerde haar, zijn blik weerspiegelde zowel zorgen als irritatie.’
Het US Copyright Office ziet dit als een vorm van ‘selectie, coördinatie en rangschikking van tekst gegenereerd door kunstmatige intelligentie’. Het idee van een creatieve selectie en bewerking van op zichzelf niet beschermd bronmateriaal is al lang aanvaard als een criterium voor auteursrecht. We kwamen dit in januari nog tegen:
In Nederland bestaat deze constructie ook. Denk aan het creatief oppoetsen van een publiek-domeinwerk: dat geeft je ook auteursrecht op het opgepoetste resultaat (maar natuurlijk niet op het bronmateriaal). Ik zie geen reden waarom dit anders zou moeten werken als je een AI-werk ‘oppoetst’.
Shupe had echter een ander argument ingebracht dat ze zelf sterker vond:
[Namelijk] om een ??belangrijker pad te openen naar auteursrechterkenning voor door AI gegenereerd materiaal. “Ik probeer auteursrechten te verkrijgen op het door AI ondersteunde en door AI gegenereerde materiaal onder een ADA-vrijstelling vanwege mijn vele handicaps”, schreef ze in haar oorspronkelijke auteursrechtaanvraag.
Ze is als 100 procent gehandicapt beoordeeld en heeft moeite met schrijven vanwege cognitieve stoornissen die verband houden met aandoeningen als een bipolaire stoornis, borderline-persoonlijkheidsstoornis en een misvorming van de hersenstam. Dan zie ik hoe het handig kan zijn als tools je een heel eind vooruit helpen.

Maar wat betekent het voor het auteursrecht op het resultaat? Stephen Hawking schreef bijvoorbeeld met een tool die losse woorden voorstelde, en iets dergelijks zit ook in veel telefoon-invoerapps: typ een woord en krijg een suggestie voor het volgende. Weinig mensen zullen zeggen dat de zin die je zo typt, een AI zin is. Het is mijn zin, het is gewoon logisch dat na ‘gewoon’ ‘logisch’ komt.

Als het systeem na één woord de hele zin afmaakt, of zelfs er een alinea van maakt, dan wordt dat gevoelsmatig een ander verhaal. Is dat nog een handige invulling van jouw keuze of zijn we dan al in de vrije ruimte van de tool beland?

De vergelijking die Shupe maakt, is ook een intrigerende: ze vergeleek “haar gebruik van OpenAI’s chatbot met een geamputeerde die een beenprothese gebruikt”. Oftewel: welk percentage van je lijf moet nog origineel-organisch zijn om nog ‘mens’ genoemd te worden? Daar is geen rechtszaak over gevoerd – en wat zou ook de insteek zijn, bij zo veel procent metaal bent u ruimbagage?

Arnoud


The Annotated AI Act komt eraan

113 artikelen, 13 bijlagen, 180 overwegingen, verwijzingen naar 27 andere wetten: de AI Act is het meest complexe stuk wetgeving dat ik ooit heb gezien. Mijn nieuwe boek “The Annotated AI Act” verheldert en analyseert de wet in gewone taal. Je kunt nu al voorintekenen!

Op hoofdlijnen is de AI Act vast al bekend. Een risicogebaseerde regulering van AI systemen, met aparte regels voor general-purpose AI en een markeerplicht voor synthetische content. Maar de risicobenadering werkt nét even anders dan bijvoorbeeld de AVG; het gekozen model is dat van productveiligheid en conformeren aan standaarden (CE keurmerk).

Met name in de laatste maanden van 2023 is er veel gebeurd met de tekst. Er moest en zou een regulering van GPAI in komen, maar dat past niet echt bij die productveiligheidsbenadering, en de auteursrechtlobby had zich ook gemeld ondertussen. Dit leidde tot een paar marathonsessies in december, waar uiteindelijk een politiek akkoord uit kwam dat in de maanden daarna uitgewerkt werd.

(Ik ben gaan schrijven toen dat akkoord er was, en moest uiteraard alles omnummeren toen de definitieve tekst werd gedropt want toen werden artikel 29a, overweging 80z+1, het lege artikel 19 en de twee artikelen 54 en nog wat van die missers aangepast.)

De haast heeft helaas een aantal dingen laten we zeggen iets minder optimaal gestructureerd. Het is dus flink zoeken naar het juiste artikel, of de combinatie met andere artikelen. Dat is waar ik dit boek voor geschreven heb: kruisverwijzingen, contrasten en literatuur (100+ referenties) voor meer achtergrond of kritische beschouwing.

Het boek verschijnt in mei wanneer de AI Act gepubliceerd is. Maar je kunt nu al voorintekenen:

Bestel The Annotated AI Act nu!

Arnoud

Amerikaanse rechter weigert video als bewijs vanwege gebruik AI-software

Bron: "Chicken3gg" op Twitter

Een Amerikaanse rechter heeft geweigerd dat een video als bewijs wordt gebruik in een rechtszaak vanwege het gebruik van AI-software bij het bewerken van de video. Dat meldde Tweakers vorige week. Door gebruik van de software wilde de aanklager duidelijker maken dat het inderdaad ging om de verdachte.

Wat ging er nou precies mis?

De aanklager gebruikte Topaz Video AI om de video te upscalen, meldt NBC News. De software van het Amerikaanse bedrijf herkent gezichten en vult vervolgens details aan die niet in het oorspronkelijke beeld zaten. Dat is problematisch, zo redeneert de rechter, want de software ‘leunt op vage methoden om te bepalen wat het AI-model denkt wat we moeten zien’, aldus de rechtbank.
Topaz is videobewerkingssoftware: je kunt er beeld mee opknappen, zoals door het er scherper laten uitzien. Dat is mooi voor die vakantiefoto die niet helemaal goed gelukt is, of voor het aanvullen van beeld voor je reclamecampagne dat nét even iets extra’s nodig heeft.

Specifiek bij bewijs is dat allemaal net iets spannender. Het is natuurlijk prima als het bewijs beter te beoordelen wordt, maar dat moet niet gebeuren door er dingen bij te verzinnen, hoe mathematisch logisch het ook lijkt dat die pixels er tussen moeten.

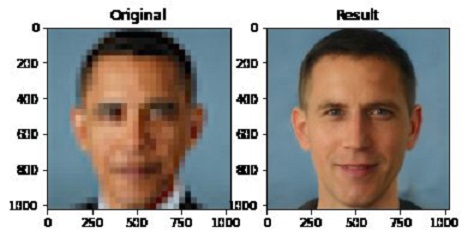
Het plaatje rechtsboven (van een experiment uit 2020 met hetzelfde doel) laat zien waarom: de dataset daarvan bevatte geen gezichten van kleur, waardoor de bekende foto van president Obama opgewerkt werd tot geheel iemand anders. Een recenter voorbeeld was beeldbewerkingssoftware die ongevraagd acteur Ryan Gosling toevoegde aan een video.

Mag dit nou van de AI Act? Ik zit even te peinzen of dit telt als biometrie, maar interpolatie van pixels kan ik moeilijk gelijk stellen aan analyse van gezichtskenmerken. Op de lijst (Annex III) staan wel diverse vormen van AI-gebruik door wetshandhaving, waar naast de politie ook het OM onder valt:

  • AI systemen gebruikt als leugendetector
  • AI om de betrouwbaarheid van bewijs te evalueren
  • AI om recidivisme in te schatten (waarbij meer dan profiling wordt gebruikt, want anders is het verboden)
  • AI voor het profileren van mensen in het kader van opsporing en vervolging
Het met AI mooier maken van bewijs lijkt mij onder het tweede item te vallen. Daarmee zou de inzet van Topaz door het OM aan de high-risk eisen moeten voldoen, wat lastig is omdat het systeem als zodanig daar niet op ontworpen is. Zo zal er geen inzage te krijgen zijn in de gebruikte trainingsdata of accuratesse, en moet het OM dan flink moeite doen om de verplichte adequate logging te bouwen.

Ook zullen dit soort systemen onder de transparantie-eis van “synthetic output generator” AI vallen. Die moeten zorgen dat hun beeld onzichtbaar en robuust gewatermerkt is zodat andere systemen (zoals het uploadformulier van Facebook) kan signaleren dat er synthetische afbeeldingen worden geupload.

Naar de letter van de wet is zulk beeld zelfs een deepfake:

“deepfake”: door AI gegenereerd of gemanipuleerd beeld-, audio- of videomateriaal dat een gelijkenis vertoont met bestaande personen, voorwerpen, plaatsen of andere entiteiten of gebeurtenissen, en door een persoon ten onrechte voor authentiek of waarheidsgetrouw zou worden aangezien;
Twintig bij twintig pixels uitvergroot en bewerkt zodat je er Ryan Gosling in ziet, lijkt mij wel “een gelijkenis vertonen” waardoor je ten onrechte het beeld voor waarheidsgetrouw aan gaat zien. Dit beeld moet dus expliciet gemarkeerd worden als niet-authentiek.

Is hiermee alle gebruik van beeldbewerking verboden? Nee. Nog even los van dat dit één uitspraak is; de betrouwbaarheid van via ict verkregen bewijs vaststellen is al decennia een aandachtspunt. AI maakt het manipuleren van bewijs eenvoudiger en sneller, maar dat is geen fundamenteel nieuwe kwestie.

Arnoud