Ik las dat Stanford een AI-tekstmodel had gebouwd dat voortbouwt op het Davinci model van OpenAI. De resultaten zijn verrassend goed ondanks hun veel kleinere aanpak, maar wat ik me nu afvroeg is of dit wel toegestaan is? Je zou zeggen dat dat model toch op een of andere manier beschermd moet zijn?
Vanuit juridisch perspectief kan ik niets onrechtmatigs ontdekken in wat deze groep Stanford-onderzoekers heeft gedaan. Dat komt neer op een eigen set met prompts en antwoorden aanleveren aan OpenAI, waarbij men het Davinci-003 taalmodel gebruikte. Dit model was de basis voor GPT-3, en kan via de API van OpenAI aangeroepen worden. Stanford deed dat vele malen en was daar zo’n $500 aan kwijt. Maar toen hadden ze wel wat, namelijk een dataset met 52.000 prompt/uitvoer-paren waar ze hun eigen AI op konden trainen.
Dit is een klassieke kloon-aanval, waarover ik al in 2016 blogde:
Is dat legaal? Op het eerste gezicht wel. Hooguit als je zegt, de Terms of Service van die API verbieden het aanroepen met als doel het klonen van de AI en/of het extraheren van alle informatie. Maar dat is alleen maar contractbreuk, daar kun je niet zo veel mee.
In Europa zou men wellicht nog van een schending van het databankenrecht kunnen spreken, maar Amerikaanse organisaties kunnen dat niet omdat de VS geen databankenrecht erkent. (Ze kunnen dat dus ook niet tegen een Europese entiteit die alhier deze kloon-aanval uitvoert.)
De Terms of Use van OpenAI hebben hier inderdaad een bepaling over:
(iii) use output from the Services to develop models that compete with OpenAI;
Het handelen van de Stanford-mensen is het gebruik van uitvoer van de diensten om modellen te maken, maar ik twijfel over dat “compete with OpenAI”. Men zegt immers:
We emphasize that Alpaca is intended only for academic research and any commercial use is prohibited. There are three factors in this decision: First, Alpaca is based on LLaMA, which has a non-commercial license, so we necessarily inherit this decision. Second, the instruction data is based on OpenAI’s text-davinci-003, whose terms of use prohibit developing models that compete with OpenAI. Finally, we have not designed adequate safety measures, so Alpaca is not ready to be deployed for general use.
Zou OpenAI er toch een issue van willen maken, dan hebben ze hier de mazzel dat deze researchers aangeven welke data ze gebruikt hebben. Want als ze er dat niet zelf bij zetten, dan is de bewijsproblematiek meteen onoverkomelijk volgens mij.
In een eerdere blog post van jou las ik dat je de AI-schrijfassistent Lex gebruikt. Nu vroeg ik mij af: wie is eigenlijk de auteur en eigenaar van een tekst die door een AI geschreven is? Mag ik claimen dat het mijn tekst is, of moet ik de AI een naamsvermelding geven? En hoe moet ik omgaan met eventuele plagiaat door de AI?
Het is onder juristen bepaald geen uitgemaakte zaak waar de auteursrechten liggen op werk gemaakt door een AI systeem. De hoofdregel van de wet is dat de feitelijk maker de rechten heeft, maar een maker (een mens dus) kan prima tools gebruiken om het werk te maken. We zeggen ook niet dat mijn digitale camera auteursrecht heeft op mijn foto’s, ondanks dat die 99% van het werk doet om er wat moois van te maken.
Ook speelt de vraag wíe de creativiteit inbrengt, wie de maker is. Is dat de persoon die de ‘prompt’, de vraag indiende bij de AI, of is dat de persoon die ervoor zorgde dat je met een prompt een mooie creatieve reactie kreeg?
We weten het echt niet. En vanuit die conclusie ben ik dan ook zeer geneigd te zeggen, vermeld gerust jezelf als de auteur want die AI gaat er echt niet over klagen. Misschien vind je het niet netjes naar je lezers, en dat is dan een afweging om het wél erbij te noemen, maar juridisch is er geen steekhoudend argument om het wel of niet te doen.
En wat betreft aansprakelijkheid: daar hang je zelf voor. Al heel lang geldt de regel bij het auteursrecht dat wie zo’n recht schendt, daarvoor aansprakelijk is. Dat de schending komt door een partner of leverancier is heel vervelend voor jou maar geen excuus om aansprakelijkheid af te wijzen. Je moet gewoon betalen en maar hopen dat die partner jou het gaat vergoeden. In zakelijke verhoudingen maak je daar afspraken over (jij vergoedt mijn schade als ik aangesproken wordt, beste leverancier) maar specifiek bij zo’n gratis AI dienst gaat niemand je dat geven natuurlijk.
“The EU’s new Cyber Resilience Act is about to tell us how to code”, las ik op de blog van Bert Hubert (aanrader). De CRA is een concept-Verordening over cyberbeveiligingseisen voor producten met digitale elementen, zeg maar alles dat we IoT (internet of [st]hi[nt]g?s?) noemen, maar dan breder want netwerkverbinding is niet perse een eis. Dergelijke apparaten moeten eindelijk, eindelijk een goede cyberbeveiliging hebben, maar dat zal nogal wat voeten in de aarde krijgen, zo laat Hubert overtuigend zien. Hoe gaat de toekomst van cybersecurityrecht eruit zien?
De CRA (originele concepttekst) maakt deelt uit van de Europese Digitale Decade, het grote strategieplan van Europa om de wereld te transformeren. Veiligheid van digitale apparaten hoort daar natuurlijk bij, ik zou het zelfs een van de speerpunten van iedere serieuze ict-strategie durven te noemen. En met boetes tot 15 miljoen (of 2% wereldwijde omzet indien hoger) maakt deze Verordening het echt wel een belangrijk onderwerp. Toch is het ook een hele spannende, want afbakenen wat er nu écht allemaal gebeurt is nog razend ingewikkeld.
Neem bijvoorbeeld de uitzondering voor open source, wat een terecht aandachtspunt is omdat je vrijwilligers niet hetzelfde wilt behandelen als commerciële bedrijven. Alleen, hoe baken je dat op een beetje rechtlijnige manier af? Want als ik als bedrijf apparaten gratis weggeef (met alle broncode open source) en geld vraag voor een gekoppelde, verplichte SaaS-dienst dan wil je wel dat die apparaten aan de CRA voldoen. En dan heb je ook nog bedrijven die werknemers opdragen aan open source projecten te werken, omdat ze daar indirect voordeel uit halen bij het implementeren van ict-oplossingen bij klanten. De CRA zegt nu (overweging 10):
In the context of software, a commercial activity might be characterized not only by charging a price for a product, but also by charging a price for technical support services, by providing a software platform through which the manufacturer monetises other services, or by the use of personal data for reasons other than exclusively for improving the security, compatibility or interoperability of the software.
Vervolgens val je onder de CRA als je een product (dus hardware met “digitale elementen” erin) op de markt brengt vanuit een “commercial activity”. Je zou zeggen dat die vrijwilliger die alleen een stuk software op internet zet, hier buiten valt alleen al omdat hij geen producten op de markt brengt. Maar let op: de definitie van een product is “software orhardware product”, dus ook enkel software online zetten kan er al onder vallen, als je daarmee een commerciële activiteit ontplooit. Dat dat bij Microsoft geldt wanneer die gratis software online zetten is dan één ding, een vrijwilliger met een “doneer nu”-knop voelt toch heel anders. Gezien de aard van de verplichtingen is dit wel een zwaar ding, dat echt nog fors op de schop moet. Gelukkig hebben een hoop partijen zich al hierover uitgelaten, dus ik ben benieuwd wat de volgende versie van de tekst gaat zeggen.
Waarom is het dan zo zwaar? De kern is dat ieder “product met digitale elementen” voldoet aan een serie basiseisen, en als je product op een aparte lijst staat dan ben je “critical” en krijg je nog een extra set eisen op je ontwerp-bord. (Stop je er AI in dan krijg je nóg meer eisen, waarover een andere keer.) Het is jouw taak als fabrikant aan te tonen dat je voldoet aan die eisen, en om dat vooraf schriftelijk uitgewerkt te hebben (een cybersecurity risk assessment). Maar alleen een papieren gaapdocument is niet genoeg: je moet gedurende 5 jaar (of levensduur indien korter) een proces hebben om kwetsbaarheden op te lossen (art. 10 lid 6).
Maar er is meer, in die lijst met basiseisen staan namelijk deze twee heel belangrijke componenten:
Products with digital elements shall be designed, developed and produced in such a way that they ensure an appropriate level of cybersecurity based on the risks;
Products with digital elements shall be delivered without any known exploitable vulnerabilities;
Die tweede klinkt meteen héél erg sterk: een product mag niet worden verkocht als er bekende kwetsbaarheden in zitten. Hoe ga je dat doen met een productielijn waarbij het zeg drie maanden duurt van fabriek tot schap in de winkel? Dat kun je zien als een bug, maar ik zie het als een feature: ontdekt men een fout dan moet je dus meteen een update realiseren die direct bij verkoop beschikbaar komt. Of inderdaad je distributeurs instrueren dat apparaat niet te verkopen tot het is opgelost, zeg maar een recall net zoals bij glasscherven in de pindakaas. Ik zou dat wel een goeie vinden, dat we cybersecurity net zo ernstig vinden als glasscherven.
Om dit alles vorm te geven, wordt het aloude CE-keurmerk opgepoetst. Wie dit keurmerk voert, geeft aan dat zijn producten voldoen aan de CRA. Dat maakt aansprakelijkheid een heel stuk makkelijker, zeker in combinatie met de recent besproken AI Liability Directive die gewoon de bewijslast omkeert: wie het CE keurmerk voert en een onveilig product blijkt te hebben verkocht, moet bewijzen dat er niets aan de hand was anders moet hij alle schade vergoeden.
De grote uitdaging, zoals Hubert ook opmerkt, is wie dit alles gaat overzien. Zonder standaarden gaat het niet, maar wie zal de standaard maken over cybersecurity? Hubert:
I have personally been part of a few standardisation processes, and it is extremely worrying how these are dominated by just a few parties, most of them non-European and with strong commercial goals to get a standard passed that works for them.
Dit beeld zal herkenbaar zijn voor iedereen (ikzelf ook) die ooit met standaardisatie heeft meegekeken. Dit zou wel eens het grootste struikelblok kunnen gaan worden. Tegelijkertijd: alleen met een open norm eisen dat een product veilig genoeg is, gaat hem ook niet worden. Dan verzint iedereen eigen criteria en krijgen we jarenlange discussie over waar welke lat zou moeten liggen. Een standaard set eisen is de enige optie. Dus dit gaat nog erg pijnlijk worden, en ik ben bezorgd dat het hierdoor veel langer gaat duren dan nodig is.
Het gebruik van Eminems stem, die door AI is gegenereerd, tijdens een liveshow van David Guetta roept juridische en ethische vragen op. Dat las ik in de KIJK vorige week. Deze openingszin, in ieder geval zijn formulering, tijdens het lezen riep bij mij taalkundige hobbels op, maar dat terzijde. Want het is natuurlijk een gaaf onderwerp: twee wereldberoemde artiesten, waarvan de meeste lezers er maar eentje kennen, én de inzet van AI, én ze gebruiken mijn format “mag dat”, maar ik heb het dan ook weer van mijn theorie-examen.
The artist added, “I discovered those websites that are about AI; basically, you can write lyrics in the style of any artist you like. So I typed ‘write a verse in the style of Eminem about future rave. And I went to another AI website that can recreate the voice. I put the text in that and I played the record and people went nuts!”
Guetta gebruikte de twee zinnen in Eminem-stijl als voice-over bij de opening van zijn act op een festival, meer omdat het kan dan om er nu echt groot commercieel profijt van te halen. En gezien de context zal niemand denken dat rapicoon Eminem werkelijk meedeed aan een EDM nummer. Sampling oftewel hergebruik van andermans muziek is bij deze muziekstijl niet echt ongebruikelijk, maar omdat het hier niet gaat om een sample uit een écht nummer van Eminem voelt het toch anders.
In 2020 blogde ik over een rechtszaak van rapper Jay-Z tegen Youtubekanaal Voice Synthesis, die ook iets dergelijks uithaalden. Daar lijkt niets van terechtgekomen, de video’s staan er althans nog steeds. Ik citeer mezelf even:
In Nederland hebben we twee zaken gehad over stemrecht. Gert-Jan Dröge moest een imitator tolereren, onder meer omdat het volgens de rechter vooral ging om zijn geaffecteerde manier van spreken en niet perse een imitatie van hém. Maar toenmalig koningin Beatrix kon wél zich verzetten tegen gebruik van haar stem (althans een imitator). Heel sterke precedenten zijn dat niet. Het enige Amerikaanse equivalent is die Let’s get ready to rumble-man die 2.5 miljoen won van een imitator, op basis van imagoschade (ongewenste associatie met een chipsmerk).
Naar Nederlands recht zou ik niet meteen weten hoe Eminem zich zou kunnen verzetten tegen dit gebruik. De associatie die Guetta creëert, voelt voor mij te weinig om het onrechtmatig te noemen. Merkinbreuk zie ik ook niet direct, en auteursrechtelijk zou het een hele leuke casusvraag voor mijn boek zijn maar de tekst is afgesloten – je kunt nog wel voorintekenen als je snel bent.
De US Copyright Office, waar je auteursrechtelijk beschermde werken registreert als je rechtszaken wilt voeren, weigerde recent de registratie van de graphic novel Zarya of the Dawn omdat een deel van het werk door AI Midjourney gegenereerd was. Dat las ik bij The Verge. Weliswaar erkent men dat de tekst en plot en dergelijke het werk zijn van de mens Kris Kashtanova, maar de afbeeldingen zijn “not the product of human authorship” en daarmee niet voor registratie vatbaar. Betekent dit nu iets voor de rechtsontwikkeling van AI? Meh.
Kashtanova is artiest en productontwikkelaar bij Ministudio.AI, een dienst gericht op AI-gedreven visuele ontwerpen. Zoals graphic novels dus, waarvoor zhij een jaar geleden het plot schreef en met de Midjourney tool de bijbehorende grafische voorstellingen creëerde. De registratie bij de US Copyright Office was bedoeld om duidelijkheid te krijgen waar de auteursrechten dan liggen.
De US Copyright Office is formeel niet meer dan een registrerende instantie: je kunt daar naar Amerikaans recht je werk deponeren, en met de registratie ben je dan bevoegd een rechtszaak te starten en statutory damages (zeg maar een wettelijk gefixeerde schadeclaim) te doen. Er zit geen inhoudelijke toetsing in, hoewel men wel de bevoegdheid heeft registraties af te wijzen als ze evident niet aan de formele eisen te doen. En dat bleek hier het geval: Kashtanova had haar plan op de socials gedeeld, en dat was een medewerker van het Copyright Office opgevallen.
Dat leidde tot een afwijzingsbrief, die gezien het belang van de zaak gepubliceerd werd.
[W]hile the word “Midjourney” appears on the cover page of the Work, there is no indication of the intent or meaning of the word on the cover. … Because the application had not disclosed the use of artificial intelligence, the Office determined that the application was incorrect, or at a minimum, substantively incomplete.
De USCO vat haar taak van het promoten van het auteursrecht breed op, want ze geeft vervolgens een uitgebreide juridische analyse waarom een AI geen (co-)auteur kan zijn, met zoals het hoort prachtige caselaw:
In cases where non-human authorship is claimed, appellate courts have found that copyright does not protect the alleged creations. For example, the Ninth Circuit held that a book containing words “‘authored’ by non-human spiritual beings” can only gain copyright protection if there is “human selection and arrangement of the revelations.”
Voor de afbeeldingen die Kashtanova via Midjourney genereert, ziet de USCO te weinig menselijke tussenkomst. Weliswaar voert zhij een prompt in, maar die leidt tot meerdere afbeeldingen waarop de mens geen invloed heeft. Dat laat zien dat de overwegende mate van creativiteit dus in de tool zit. Als de prompt leidend was, dan zou er één afbeelding uitkomen, zeg maar:
Rather than a tool that [Mx]. Kashtanova controlled and guided to reach her desired image, Midjourney generates images in an unpredictable way. Accordingly, Midjourney users are not the “authors” for copyright purposes of the images the technology generates. … A person who provides text prompts to Midjourney does not “actually form” the generated images and is not the “master mind” behind them. Instead, as explained above, Midjourney begins the image generation process with a field of visual “noise,” which is refined based on tokens created from user prompts that relate to Midjourney’s training database. The information in the prompt may “influence” generated image, but prompt text does not dictate a specific result.
Men trekt de vergelijking met Adobe Photoshop, dat ook een forse mate van eigen intelligentie inbrengt met de bewerkingstools, maar daarbij geldt wel steeds dat Photoshop doet wat je vraagt (niet lachen daar achterin). De controle ligt daarmee nog steeds bij de mens die Photoshop gebruikt. Dat het veel werk is om de juiste prompts te verzinnen en de beste afbeeldingen te selecteren, dat gelooft men graag, maar is geen creatieve inbreng in de zin van het auteursrecht.
De aanvraag wordt daarmee afgewezen, zij het dat Kashtanova deze mag aanvullen door bijvoorbeeld een disclaimer toe te voegen op de AI afbeeldingen. Zijn die dan publiek domein? Nou ja, in de opinie van de USCO dus wel, maar de Copyright Office is geen rechtbank. Hoewel hun opinie zwaar weegt (en goed onderbouwd is), is dit dus zeker geen uitgemaakte zaak.
Een rechter in Colombia heeft ophef veroorzaakt door de chatbot ChatGPT om advies te vragen bij het beoordelen van een zaak over de medische kosten van een autistische jongen. Dat meldde RTL Nieuws onlangs. Als hij “autisme minderjarige vrijstelling therapie vergoeding” in een juridische zoekmachine had getypt, had niemand er wat van gevonden, maar omdat hij er een vraagzin van maakte en het antwoord in essayvorm terugkreeg, is het een ding.
Of nou ja. ChatGPT is natuurlijk geen AI in de zin van intelligentie: het is een voorspellend algoritme, dat op basis van statistiek bepaalt wat het gaat zeggen. ChatGPT snapt dus geen jurisprudentie, maar zou bijvoorbeeld afgaan op Colombiaanse blogs en daaruit een vaak voorkomend antwoord destilleren. Als je ChatGPT vraagt of je als veertienjarige een krantenwijk mag, dan zal het antwoord “ja” zijn, want dat is wat de meeste sites zeggen. Dat dit antwoord juist is, is mooi meegenomen maar voor ChatGPT in het geheel niet relevant.
Bij iets als therapievergoedingen voor minderjarige autisten naar Colombiaans recht zul je evenzo al snel uitkomen bij juridische loketten, verenigingen voor ouders van autisten en ga zo maar door. Die lezen de wet en wat de uitvoeringsinstantie erover zegt, en parafraseren dat op vele manieren voor de doelgroep. Daaruit kan ChatGPT dan prima halen dat het modale antwoord is “ja, een minderjarige is vrijgesteld”, en dat dan in juridische taal. Of het klopt, is dus irrelevant – ChatGPT heeft data tot 2021 en zou dus een wetswijziging van vorig jaar zomaar gemist hebben.
Zou het in Nederland mogen? Nou ja, je mag als rechter prima je vonnis baseren op een sjabloon, of voor standaardkwesties een standaardfrase gebruiken. Bij ieder vonnis waarin bijvoorbeeld de uitingsvrijheid botst met de privacy, krijg je eerst een riedel dat grondrechten gelijkwaardig zijn en dat de HR toen en toen heeft gevonnist dat de afweging op basis van alle omstandigheden van het geval moet. En dat is prima: die frase klopt, zet het juiste kader en is dan ook gewoon wat je verwacht in zo’n vonnis. Waarom zou een robot dat niet in iets uitgebreidere vorm mogen oplepelen?
We hebben het in het verleden gehad over googelende rechters: je mag feiten niet zomaar uit openbare bronnen vissen zonder ze aan de partijen voor te leggen voor hun reactie. Dus als je dat pas bij het vonnissschrijven gaat doen, dan ben je te laat. Maar let wel: het gaat in dat oordeel over feiten, niet over rechtsregels die je op die feiten loslaat. Het hele punt van een rechter is dat die het recht toepast, en zelf opzoeken wat de wet zegt en dat op de feiten betrekken is dus gewoon toegestaan. Ook als de partijen niet bedacht hadden dat dat wetsartikel relevant kon zijn.
Naar Nederlands recht zie ik dus niet meteen een probleem met wat deze rechter deed, zeker omdat hij vervolgens de tekst wel redigeerde en daarmee tot zijn eigen werk maakte. Plagiaat in een vonnis is volgens mij niet echt een ding, ik zou als rechter geen probleem zien in copypasten uit een collega haar vonnis als dat stuk goed past bij mijn eigen zaak. Zolang je maar de feiten goed hebt en de rechtsregels toepast zoals de wet voorschrijft. En dat is hier goed gegaan.
Minister Dijkgraaf van Onderwijs is gevraagd om het gebruik van chatbot ChatGPT in het klaslokaal te verbieden, zo las ik bij Security.nl. Naar aanleiding van berichtgeving dat studenten de chatbot gebruiken voor het maken van hun huiswerk, besloot het parlement 4000 euro stuk te slaan om publiciteit te genereren met het idee dat een verbod hier iets zinnigs toevoegt. En ik trap erin want ik schrijf erover, maar dat is mede omdat ik mijn opleiding wil pluggen natuurlijk.
Op 30 november vorig jaar bracht instituut OpenAI de tool ChatGPT uit. Deze tool is getraind op miljarden woorden en kan gegeven een prompt een serieus klinkend maar puur op statistiek gebaseerd antwoord produceren. Ik vind de tool erg handig als schrijfhulpje, zolang je maar beseft dat je het alleen gebruikt voor mooi klinkende teksten en niet voor kloppende teksten.
Het probleem is natuurlijk dat ChatGPT bij oppervlakkige lezing een best redelijk verhaal produceert, zeg maar wat je krijgt als je zonder inhoudelijke kennis flink googelt voor je essay, liberaal copypaste toepast en dan wat herschrijft zodat het niet direct opvalt in de plagiaatcontrole. En ik zie hoe dat in het onderwijs een nakijk-uitdaging oplevert, mede omdat leraren niet de tijd of de middelen (zoals een ChatGPT-detector) hebben om hier adequaat op te reageren.
Je kunt ook als school de vlucht naar voren nemen, en de tool actief inzetten ent zoals je mediavaardigheden leert en mensen met de spellingscontrole laat werken als ze een essay maken. Of een rekenmachine leren gebruiken (weet iemand nog waarom die in onze tijd grafisch moest zijn, trouwens) voor complexe reken-opgaven. Werken met een chatbot en feit van fictie leren scheiden is een best nuttige vaardigheid.
Dat laatste is dus tegen het zere been van de politiek, vandaar de kamervragen om de tool te verbieden in het onderwijs. En ja, juridisch is dat prima te regelen. De wet stelt kaders en scholen vullen deze nader in, daar zijn genoeg haakjes om te bepalen dat in lessen mediawijsheid niet wordt onderwezen over AI-chatbots en dat leerlingen niet mogen nagaan hoe deze werken. Maar het lijkt mij compleet onzinnig.
Wat ik vooral wil weten: waarom is ChatGPT in zo korte tijd zón enorm ding geworden?
DoNotPay will pay any lawyer or person $1,000,000 with an upcoming case in front of the United States Supreme Court to wear AirPods and let our robot lawyer argue the case by repeating exactly what it says. … We have upcoming cases in municipal (traffic) court next month. But the haters will say “traffic court is too simple for GPT.” So we are making this serious offer, contingent on us coming to a formal agreement and all rules being followed. Please contact me if interested!
Joshua Browder is de oprichter en directeur van de legal tech dienst DoNotPay, die begon als een bezwaargenerator voor parkeerboetes maar ondertussen vrij generiek juridisch advies én procedures ondersteunt. Deel van de technologie is IBM’s Watson AI systeem en het bedrijf zou nu 210 miljoen dollar waard zijn. Dus een lege toezegging zou ik dit niet noemen.
Punt is natuurlijk: een advocaat die bij de US Supreme Court komt pleiten, mag geen oortjes in hebben of op een iPad kijken wat zhij ook weer gaat zeggen. Nog even los van klakkeloos nazeggen wat een ander gaat zeggen, daar zijn ongetwijfeld gedragsregels tegen. Dat maakt het dus een vrij spannende uitdaging, want je zet je professionele carrière op het spel voor een kans op 1 miljoen dollar.
Zou het in Nederland mogen? Het is advocaten zeker toegestaan om elektronica (zoals een iPad) mee te nemen, en je mag er ook prima op kijken als je even twijfelt over wat te zeggen. Maar je pleitnota (wat je gaat zeggen, zeg maar) moet je vooraf ingeleverd hebben, dus heel veel ruimte voor spontane toevoegingen heb je niet.
Voor het reageren op wat de wederpartij zegt zou zo’n oortje-met-AI nuttig kunnen zijn, maar ik zou niet weten hoe je dát onopvallend doet – de andere advocaat komt met een opmerking tussendoor, jij kijkt twee seconden glazig met je vinger op je oor en je komt met een perfect weerwoord? Ik zou er als rechter niet vrolijk van worden.
Het meer algemene punt van Browder vind ik zeker wel interessant, maar ik denk wel dat je het in de openheid moet doen: beide partijen weten dat er AI’s meedenken, en kunnen daar dan dus op inspelen. Bij een ‘gewone’ rechter gaat dat niet werken, maar je kunt in Nederland prima afspreken dat je een particuliere partij zult volgen (de Rijdende Rechter is er groot mee geworden), en als die in zijn reglement zegt dat alleen AI’s verhalen mogen houden, waarom niet? De AI-ende Rechter?
Stockfotodatabank Getty Images heeft Stable Diffusion-maker Stability AI aangeklaagd, las ik bij Tweakers. Stability AI zou haar plaatjesgenerator (mede) hebben getraind op ‘miljoenen’ afbeeldingen van Getty, en daarbij de verkeerde (lees: te goedkope) licentie hebben afgenomen om bij de bronbeelden te kunnen. Het roept natuurlijk de vraag op, is het überhaupt inbreuk op auteursrechten als je een AI traint op beschermde werken?
Ik heb al eerder geblogd over je foto als datapunt in iemands AI, waarbij de kern is of het leren van een foto telt als een inbreuk op het auteursrecht. Hoofdregel van het auteursrecht is immers dat een stukje van het werk in de uitvoer terecht komt, en als ik alleen maar de onderliggende informatie extraheer dat “ondergaande zon” hoort bij een halfronde gelige bol, dan zie ik niet hoe ik een auteursrecht schend.
Dit soort plaatjesgeneratoren werkt alleen subtiel net iets anders. Ze extraheren niet de informatie van hoe dingen eruit zien (zoals een leerling-kunstenaar zou doen) om daar vervolgens nieuwe werken mee te maken. Zoals Matthew Butterick (die ook Github aanklaagt over hun AI) uitlegt:
The first phase in diffusion is to take an image (or other data) and progressively add more visual noise to it in a series of steps. (…) At each step, the AI records how the addition of noise changes the image. By the last step, the image has been “diffused” into essentially random noise. The second phase is like the first, but in reverse.
Het systeem bewaart dus een soort-van gecomprimeerde versie van elke bronafbeelding, waarbij bij elke afbeelding termen onthouden worden waar ze over gaan. Butterick laat dit zien met deze afbeelding:
De originele afbeelding linksboven wordt via twee stappen omgezet naar ruis, wat je kunt zien als een soort-van hash, een soort-van compressie. Reconstructie gebeurt door die ruis als invoer te nemen en via een omgekeerde functie te vertalen naar een bronafbeelding.
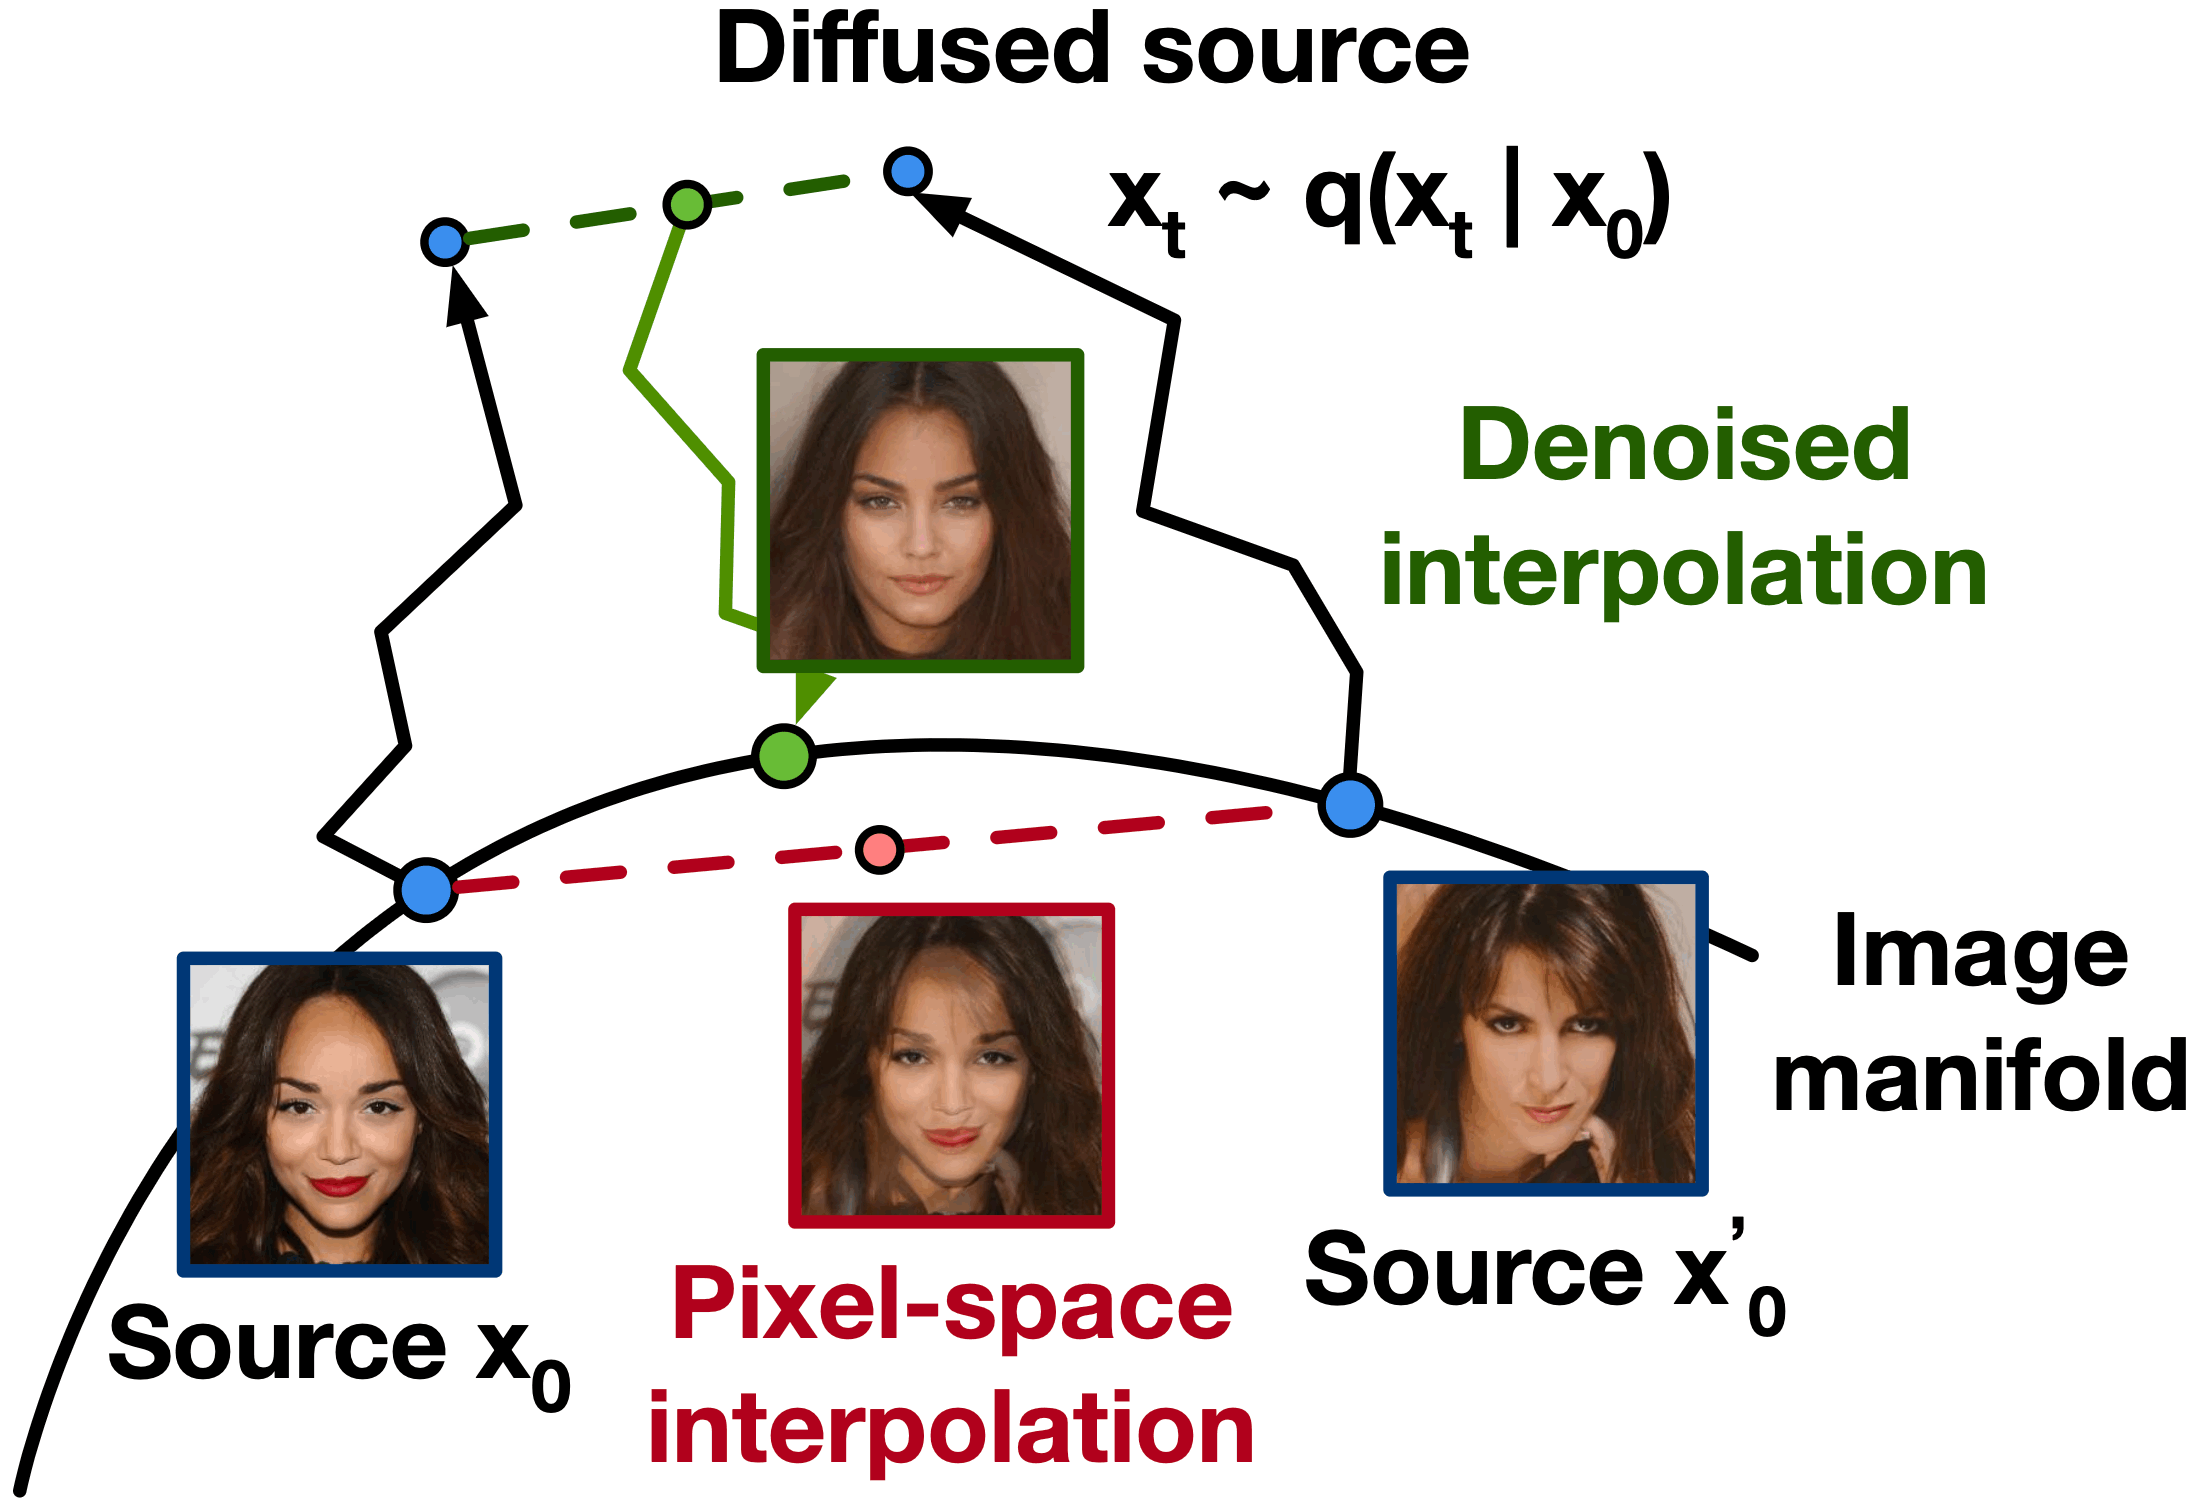
De volgende stap is het genereren van nieuwe afbeeldingen. Dit illustreert Butterick met de volgende afbeelding, die laat zien hoe men van twee portretafbeeldingen een nieuwe maakt (klik voor groot):
De groene afbeelding is waar het uiteindelijk om gaat. Deze wordt niet gemaakt door pixels samen te voegen (zoals bij de rode) maar door de soort-van hashes van de twee bronafbeeldingen samen te voegen en daar de reconstructie op los te laten.
Het wordt dan nog iets complexer door de constructie van prompts, die zeg maar bepalen welke bronafbeeldingen worden gebruikt. Maar de kern blijft: bronafbeeldingen worden in soort-van gecomprimeerde vorm samengevoegd en daaruit wordt dan een nieuwe afbeelding gereconstrueerd. Deze techniek kent geen analogie, maar heel breed gekeken zou je dit wellicht een vorm van collageren kunnen noemen? Daar gaat het om kleine stukjes uit vele werken, hier meer om vage versies van vele werken.
Kom ik terug bij die hoofdregel: als een stukje van een werk herkenbaar in andermans werk zit, en dat stukje geeft blijk van het creatief vermogen van de maker van het origineel, dan is sprake van inbreuk (tenzij citaatrecht et cetera). De analyse van Butterick laat zien dat er stukjes van bronwerken in gegeneerder werken terechtkomen, zij het vaag. Dat roept de vraag op of die stukjes blijk-van-creativiteit nog wel aan te wijzen zijn – nog los van de vraag hoe een individuele rechthebbende kan aantonen dat zijn werk gebruikt is.
Bij Getty is dat laatste iets minder een issue, als bewezen is dat er miljoenen afbeeldingen in het systeem ingelezen zijn dan zou de inbreuk vrij snel vast moeten staan. Alleen is het de vraag of dit wel “inbreuk” te noemen is, gezien Stability AI op basis van een licentie de afbeeldingen gebruikte. En mogelijk zijn ze dan de voorwaarden te buiten gegaan, maar dat noemen we eerder contractuele wanprestatie dan een rechtenschending. (Dat heeft gevolgen voor de schadeclaim, proceskosten enzovoorts.)
Het zou in het algemeen wel raar zijn als vaststaat dát er grootschalig allerlei rechten worden geschonden door dit transformatieve proces, maar dat geen enkele rechthebbende kan optreden tenzij deze door de vage schimmen heen kan prikken en zijn individuele foto aanwijzen.
De telecomministers van de EU-lidstaten hebben een akkoord bereikt over de Artificial Intelligence Act, een wetsvoorstel met als doel om te verzekeren dat AI-systemen in de EU veilig zijn en de fundamentele vrijheden en Unie-waarden eerbiedigen. Dat meldde Tweakers onlangs. De AI Act is een unieke aanpak om de technologie en haar toepassingen te reguleren, omdat ze uitgaat van risicogebaseerde regulering: hoe enger, hoe strenger. Daardoor kan dus ook een Excelfilter onder de wet vallen. Het streven is dat in de herfst van volgend jaar een definitieve overeenstemming is bereikt, waarna de verordening in de lidstaten van kracht wordt.
Bij EURActiv vatten ze de belangrijkste wijzigingen in meer detail samen. Het eerste grote discussiepunt was de definitie van AI. Deze was in de eerste tekst (van de Commissie) wel héél generiek opgezet, welbewust met het doel zo veel mogelijke potentieel risicovolle inzet van AI te kunnen vangen. Want ja, ook met slaafs een Excelfilter opvolgen of een drieregelige if/then/else constructie het werk van je HR-afdeling laten doen ben je in feite bezig met computers managementbeslissingen laten nemen. En dat is dus eng.
De nieuwe definitie is iets beperkter door haar nadruk op machine learning, kennissystemen en dergelijke, maar laat ruimte aan de Commissie om de wettelijke definitie te herzien als daar aanleiding toe blijkt te zijn. Maar volgens mij is er niets wezenlijk uitgesloten dat in het eerste concept beoogd was eronder te laten vallen. Een punt is wel dat een AI alleen onder de Act valt als deze ingezet wordt om een voorspelling, content, aanbeveling of actie te doen. Een algemeen AI model (zoals het GPT-3 taalmodel) zou er dan niet onder vallen, want die doet an sich niets. De Commissie gaat dit nader onderzoeken en kan zulke generieke modellen er onder brengen als een impact assessment laat zien dat dit nodig gaat zijn.
In het risicogebaseerde model zijn er drie niveaus, met daarnaast een regulatory sandbox. Het hoogste niveau zijn toepassingen van AI die in strijd zijn met onze fundamentele waarden (zoals het beruchte “social credit scoring”), die zijn simpelweg niet toegestaan. AI’s die geen tot weinig risico’s voor mensen geven (zoals de chatbot bij Bol.com) hoeven vrij weinig, behalve zichzelf als zodanig bekend maken. Daartussen zit het soort AI waar het om gaat: die verhoogde risico’s hebben voor mensen, maar in een gebied dat op zich niet héél fundamenteel is.
Of nou ja? Zaken als screening van sollicitanten of biometrische herkenning kunnen behoorlijk wat impact hebben, maar zijn toch niet verboden. Wel moet hier een zwik documentatie bij beschikbaar zijn, inclusief kwaliteitsgaranties op de dataset en een adequate aansprakelijkheid voor schade. Ga het maar regelen, en als je leverancier je er niet voor wil vrijwaren (leuke vraag, wellicht zit je nu rond de contractsverlenging 2023) dan wordt het tijd om over te stappen.
Een goede stap dus, het lijkt erop dat er Europese overeenstemming bereikt is over wat AI wel en niet zou moeten doen dus de volgende stap bij de Raad en Parlement zou hopelijk snel afgerond moeten zijn.
(Meer leren over AI en wat daarbij hoort? Je kunt hieronder ons nieuwe boek voorintekenen, of onze eenjarige opleiding voor juristen Specialist ICT doen die in april begint.)
 Een lezer vroeg me: