“Canadees databevel dreigt een gat te slaan in Europese soevereiniteit”

Een Canadese rechtbank heeft de Franse cloudprovider OVHcloud bevolen om klantgegevens die in Europa zijn opgeslagen over te dragen, las ik bij The Register. Dit ondermijnt mogelijk de claims van de provider met betrekking tot de bescherming van digitale soevereiniteit.

Zoals The Register uitlegt, heeft de Canadese politie (RCMP) in april 2024 een bevel gegeven aan de Franse cloudprovider OVHcloud om abonnee- en accountgegevens te verstrekken gekoppeld aan vier IP-adressen op OVH-servers in Frankrijk, het Verenigd Koninkrijk en Australië. Dit als deel van een Canadees strafrechtelijk onderzoek.

Het bevel werd in eerste instantie gegeven aan de Canadese dochter, maar die kan technisch noch organisatorisch bij die gegevens. Heise vertelt verder:

Nevertheless, on September 25, the Ontario Court of Justice, presided over by Judge Heather Perkins-McVey, ruled that the French parent company must hand over the data to the Canadian authorities. Her reasoning is based on a broad interpretation of “virtual presence”: since OVH operates globally and offers services in Canada, the company is subject to Canadian jurisdiction, regardless of where the physical servers are located.
Dit is problematisch voor het Franse bedrijf, omdat artikel 48 AVG én Frans recht (de Blocking Statute) het afgeven van zulke gegevens verbiedt tenzij er een in Europa geldig bevel is gegeven. De Franse wet zet er zelfs celstraf en een boete tot 90.000 euro per overtreding op. Maar de Canadese rechter zal dit als contempt of court zien, met vergelijkbare strafmogelijkheden.

De zaak doet sterk denken aan waar mensen bij de US Cloud Act bang voor zijn. Ik blijf moeite houden met de vanzelfsprekendheid waarmee mensen aannemen dat bedrijven dan de Amerikaanse (of Canadese) regels gaan volgen omdat hun wet dat zegt.

Praktisch zie ik het ergens nog wel: wie banger is voor economische sancties van de Yanks dan voor boetes van de EU kan eieren voor z’n geld kiezen. Maar in het openbaar dat hardop zeggen kan ik me niet voorstellen bij een beursgenoteerd bedrijf.

De Canadese zaak kan dus een mooie testcase worden, als in het (nu lopende) hoger beroep wordt bepaald dat de Canadese rechter dat bevel inderdaad mag geven. En zuiver naar Canadees recht kijkend zie ik niet waarom niet. Dat recht hoeft immers geen rekening te houden met wat een ander land in hun wet heeft staan.

Arnoud


Nieuwe AI-crypto maakt betalingen tussen machines mogelijk, wie is dan aansprakelijk?

Photo by Sajad Nori on Unsplash

Waar de meeste blockchains nog zijn ontworpen voor mensen, legt Kite de basis voor een economie waarin kunstmatige intelligentie zelfstandig kan handelen en betalen. Dat las ik bij Crypto Insiders. Zo “kunnen machines diensten afnemen, onderhandelen en betalingen doen zonder menselijke tussenkomst”. Hatseflats, blockchain én AI bij elkaar.

Agentic AI is de hypeterm voor AI systemen die er zelf op uit gaan om acties uit te voeren. Of eigenlijk, de infrastructuur waarbinnen AI systemen (vaak agents genoemd) dat kunnen doen. Want je hebt natuurlijk wel API’s en andere automatisch te gebruiken dingen nodig om dit mogelijk te maken. En dat is wat ze bij Kite dus willen doen.

Uit het whitepaper:

Kite’s technical contributions include: (1) A three-layer identity architecture separating user (root authority), agent (delegated authority), and session (ephemeral authority) identities through BIP–32 hierarchical derivation; (2) Programmable governance spanning services through unified smart contract accounts where compositional rules enforce global constraints at the protocol level; (3) Agent-native payment rails using state channels that achieve sub–100ms latency at approximately $0.000001 per transaction.
Deze architectuur is vooral gericht op granulaire autorisaties, zodat je een agent niet zwartwit toegang tot je crypto-wallet hoeft te geven waarmee deze alles uit kan geven bij een hack of foutje. Ook biedt Kite op deze manier een blockchain-registratie van transacties, gericht op transparantie en audits. Klinkt allemaal heel mooi.

Het riep bij diverse lezers de vraag op hoe dat dan juridisch zit, als er toch iets misgaat. Bij crypto is dat meestal geen heel hot topic: het idee is vaak “de software is de regels”, dus als er wat misgaat dan kende jij de regels niet goed, jammer voor jou. Programmeerfout, onduidelijke instructies, typefout: niets aan te doen.

De wet is vergeeflijker dan dat, en kent allerlei mechanismen om onbedoelde acties (in ieder geval in theorie) terug te kunnen draaien. Dwaling, of simpelweg de conclusie dat een bepaalde uitleg van het contract niet redelijk is. En als de gebruiker een consument is, dan zijn er de nóg beschermender regels van het consumentenrecht.

Tegelijkertijd is hier bij uitstek het probleem van de handhaving. Bij crypto-diensten en bij agentic AI is er weinig tot geen menselijke tussenkomst. En terugdraaien van transacties op last van de rechter kan ook niet, want er is geen autoriteit die dit kan uitvoeren. Ja, de ontvanger van het geld kan het teruggeven maar het probleem is juist dat die niet te vinden is.

Arnoud


Een AI-model is geen kopie van haar trainingsdata (of toch wel?)

ananitit / Pixabay

Getty Images heeft dinsdag grotendeels verloren in de rechtszaak in Londen tegen het AI-bedrijf Stability AI over diens beeldgenerator. Dat meldde Reuters. Hoewel de generator (Stable Diffusion) was getraind op Getty-content én Getty-foto’s kon reproduceren, vond de Engelse rechtbank dat geen sprake was van rechtenschending. Hoe zit dat?

Stable Diffusion is een van de oudste beeldgeneratoren. De kern van de werking is het diffusiemodel, waarbij uit een startafbeelding ruis wordt verwijderd op basis van een prompt, om te komen tot een resultaat dat statistisch correspondeert met de in de trainingsdata aangeleerde patronen.

Die trainingsdata kwam van internet natuurlijk. Iets preciezer van het LAION-datasetcollectief. Deze bevat dan weer tienduizenden afbeeldingen waar Getty auteursrecht op had, wat voor het stockfotobedrijf reden was om een rechtszaak te beginnen.

Probleem: een diffusiemodel bevat niet letterlijk kopieën van die foto’s. Die zijn gebruikt om op te trainen, om die patronen uit te ontwaren. Bij dat trainen worden natuurlijk kopieën gemaakt, alleen was hier de complicatie dat dat niet in Engeland was gebeurd. Dus dat kun je onder Engels recht niet als inbreuk behandelen.

Het Engelse vonnis behandelt dan ook de kwestie als secondary infringement, oftewel het invoeren van een kopie naar het grondgebied van het Verenigd Koninkrijk. En dan wordt het nog knap ingewikkeld: kun je een AI-model, een diffusiemodel, wel zien als een kopie van haar trainingsdata?

Dit is een hele fundamentele vraag. Modellen leren patronen, maar leggen daarmee niet de trainingsdata zelf vast. Of toch wel? Het is (soms) mogelijk om specifieke bronafbeeldingen te reconstrueren, wat het vonnis “memorized images” noemt. Onduidelijk is of dat inherent is, hoe wijdverspreid dat gaat en in hoeverre de prompt daarin meeweegt (Nasr et al, Su et al).

De rechter kreeg vele analogieën aangereikt, maar dat bleek hier eerder verwarrend dan behulpzaam. Hij gaat daarom terug naar de wet zelf, die spreekt van een “infringing copy”. Dat wil zeggen, letterlijk lezend, dat er een kopie van een beschermd werk in zit. En dat is niet het geval, althans dat blijkt niet uit het bewijs. Kopieën zijn wel gebruikt bij het maken van het diffusiemodel, maar ze zitten er niet in. 

Kern van deze conclusie is wel dat Getty had ingezet op “de modelgewichten en het model als zodanig is per definitie een kopie van de trainingsdata”. Die stelling wordt als te algemeen en te kort door de bocht verworpen.

De insteek “met het diffusiemodel kunnen kopieën worden gemaakt van onze foto’s” had een andere conclusie gegeven, maar dan kom je bij discussies als “de dienst zet aan tot inbreuk” en de vrijwaring voor dienstaanbieders en ik denk dat Getty daar weg van wilde blijven.

Het is één uitspraak in 51 zaken wereldwijd en ongetwijfeld wordt hoger beroep ingesteld.

Arnoud


Hoe gaan streamingdiensten om met muziek die door AI gemaakt is?

Photo by Anna Shvets on Pexels

Het punt met het bestaan van AI-muziek is dat je kunt gaan twijfelen aan muziek. Die mooie zin vond ik in een analyse van Tweakers over hoe streamingdiensten omgaan met AI-muziek. Ik leerde onder meer dat ik vorig jaar Zo Zomer gemist heb, en dat onduidelijk is wat we precies met “AI muziek” bedoelen.

Om maar met dat laatste te beginnen: de meeste aandacht gaat naar AI-muziek die zich voordoet als van echte artiesten, en AI-muziek die het systeem manipuleert. Zoals bij “liedjes” van 32 seconden, net lang genoeg om te tellen als een play en geld te krijgen. Maar niemand zit te wachten op dergelijke muziek.

Geheel nieuwe, als zodanig gepositioneerde AI muziek is vrij nieuw – al had ik in ons The Future is Legal-congres in 2019 al muzikaal behang uit AI-generatoren. Maar toegegeven, daarmee schoof ik wel menselijke artiesten geld uit de mond want ik hád iemand in kunnen huren.

Zoals Tweakers het enigszins aangezet formuleert:

Met de stappen van Deezer en Spotify is er in elk geval bescherming voor menselijke artiesten en menselijke muziek. Als AI-muziek een ‘doorgaande artistieke provocatie wil zijn, ontworpen om de grenzen te verkennen van auteurschap, identiteit en de toekomst van muziek in het tijdperk van kunstmatige intelligentie’, moeten ze dat vooral doen zonder schade toe te brengen aan muziek die mensen hebben gemaakt.
Die quote komt uit de biografie van AI-band The Velvet Sundown, die in een paar maanden miljoenen streams via Spotify verwierf. Niemand wist wie er achter zat en wat er uit een menselijke keel of mensbediend instrument kwam.

Vanuit juridisch perspectief lijkt hier weinig mis mee, zolang je niet misleidt over werkelijke artiesten die mee zouden werken. De AI Act vereist wel een digitale markering (zoals Content Credentials bij afbeeldingen) en daar zouden platforms als Spotify op kunnen sturen.

Arnoud


Hebben we hier de eerste Nederlandse advocaat met ChatGPT-ECLI’s?

Bron: Emanuel Peire, Medium

“Tijdens de mondelinge behandeling is vastgesteld dat alle verwijzingen in de conclusie van antwoord naar uitspraken van de Hoge Raad onjuist zijn.” Voor het eerst dat ik dat lees in een Nederlands vonnis, en zoals de rechtbank dan zegt roept het vele vragen op.

Het vonnis betreft een handelsnaaminbreuk, en de verwijzingenkwestie komt pas als laatste terzijde aan de orde, want de zaak kon ook zonder gewoon worden opgelost. Maar toch, ik zou knap balen als dit over mijn conclusie van antwoord werd gezegd:

In de conclusie van antwoord heeft [de gedaagde partij] verwezen naar (vermeende) uitspraken van de Hoge Raad ten aanzien van het handelsnaamrecht, met vermelding van een (vermeend) ECLI-nummer. Geen enkele van de aangehaalde (vermeende) arresten heeft betrekking op het handelsnaamrecht. Sommige ECLI-nummers horen bij strafrechtelijke uitspraken, andere bestaan in het geheel niet.
Ik denk dan meteen “ah, ChatGPT gebruikt”. Want die tool – en zijn vriendjes Claude en Copilot – heeft er een handje van de mooiste uitspraken op te lepelen die precies het betoog ondersteunen.

Mét een ECLI, want dat hoort er bij. Maar of die ook feitelijk bestaan en ondersteunen wat er wordt gezegd, dat is een heel ander verhaal. Het is meer Keyzer en de Boer: het klínkt goed, maar voor de feiten moet je elders wezen.

De rechtbank trekt geen conclusie, want je kunt immers niet zeker weten of iemand zo’n tool gebruikt tenzij die dat erkent. De verklaring hier doet voor mij als ict-er wat ongemakkelijk aan:

Desgevraagd heeft (de advocaat van) [de gedaagde partij] verklaard dat dit alles is veroorzaakt door een probleem bij het converteren van een word-bestand naar pdf. Deze verklaring roept vragen op.
Nou weet ik dat pdf-bestanden rare ondingen zijn, maar dat ze ECLI-nummers verbouwen heb ik nog niet gezien. Links die wegvallen, tekst die niet meer selecteerbaar is, tekst die na het plakken Unicode-prut wordt – zeker. Maar dit? Ik geloof het gewoon niet.

Arnoud


Gaan we een stortvloed aan no-cure-no-pay ChatGPT dagvaardingen krijgen?

Alexandra_Koch / Pixabay

Het was me even ontgaan, maar in januari wees de HR een arrest over de vele no cure no pay claimbureaus. Deze zijn er rond diverse wetten, waarbij de Woz- en bpm-bezwaren denk ik de bekendste zijn. Ze drijven de proceskosten fors op, omdat ze daar een percentage van verdienen. Dat arrest was een forse aderlating, en ik ben een beetje bang dat de volgende stap een massale ChatGPT-inzet gaat zijn.

Per 1 januari 2024 zijn beperkingen in de proceskostenvergoedingen ingevoerd in zaken over de Wet waardering onroerende zaken (WOZ) en de belasting van personenauto’s en motorrijwielen (bpm). Dit ter bestrijding van no cure no pay kantoren die hier bezwaren tegen aandragen. De Hoge Raad definieert ze zo:

een beroepsmatig optredende gemachtigde, dan wel een kantoor, waarvan het bedrijfsmodel eruit bestaat dat

(i) wordt opgetreden op basis van no cure no pay,

(ii) daarbij zodanige afspraken met de cliënten worden gemaakt dat het bedrag van eventuele proceskostenvergoedingen aan de gemachtigde of aan het kantoor wordt afgedragen, en

(iii) de procedures op een zodanige wijze worden gevoerd dat de daarin toegekende proceskostenvergoedingen de in redelijkheid gemaakte kosten ver overtreffen.

Met name dat laatste steekt natuurlijk: dat gaat niet meer over het werkelijke geschil, maar is een manier om de inkomens van dat kantoor te vergroten. Zij krijgen immers die vergoeding, de cliënt krijgt enkel de hoofdsom (of een brief met een hogere dan wel lagere Woz).

Een ander bezwaar staat in de conclusie P-G:

Uit het onderzoek, dat gepubliceerd is op onze site, komt naar voren dat in 2022 (waardepeildatum 1 januari 2021) gemiddeld 27 % van de bezwaren tegen de WOZ-waarde van een woning op basis van no cure no pay zijn gehonoreerd. Van de overige bezwaren is in dat jaar 45 % gehonoreerd.
Oftewel, je krijgt meer kansloze zaken én ze drijven de proceskosten nodeloos op. Vandaar dat de vergoedingen bij Woz en bpm nu fors omlaag zijn gezet tot 0,25 of 0,1 keer de gewone.

Hoe herken je zo’n bureau? Deze vond ik een aardige:

Aanwijzingen dat dit laatste het geval is, kunnen bijvoorbeeld worden gevonden in de omstandigheid dat vaak geheel of ten dele gebruik wordt gemaakt van gestandaardiseerde tekstblokken die niet zijn toegespitst op de desbetreffende zaak.
Het moet immers zo goedkoop mogelijk, dus één bezwaarschrifttekst met wat puntjepuntje tekstvlakken en hier en daar een “weghalen tenzij” aanwijzing is dan een simpele invulling. Naar zijn aard zijn die teksten generiek.

Dit is belangrijk, want de HR merkt ook op dat als je niét met zo’n bureau werkt, je wél gewoon recht hebt op de normale proceskostenvergoeding. Ik geloof dus onmiddellijk dat die bureaus hard aan het nadenken zijn hoe ze zichzelf kunnen verstoppen.

Hoe krijg je met minimale meerkosten een bezwaarbrief die op de zaak is toegespitst én niet leest als een standaardtekst waar hier en daar een puntjepuntje is ingevuld? Precies, met zo’n groot taalmodel en een leuke prompt. En dat is lastig, want er zullen ook genoeg burgers handig genoeg zijn om dit zelf uit te vogelen, dus hoe maak je dan nog het onderscheid?

Arnoud


Toezichthouder waarschuwt voor schadelijke vriendschappen met AI-chatbots

Photo by Josh Sorenson on Pexels

Chatbots voor virtuele vriendschappen en therapie bij mentale problemen geven onbetrouwbare informatie en zijn soms schadelijk. Dat meldde Nu.nl onlangs. Uit een onderzoek van de Autoriteit Persoonsgegevens (AP) naar 9 populaire chatbotapps blijkt dat deze ongenuanceerde, ongepaste en soms zelfs schadelijke reacties geven op gebruikers die mentale problemen ter sprake brengen.

Het onderzoek is de halfjaarlijkse Rapportage AI- & Algoritmerisico’s Nederland (RAN). De risico’s van deze chatbots worden inderdaad geschetst, zij het als verwijzing naar externe media:

Daarbij is er de kans dat een chatbot de gebruiker aanraadt om contraproductief te handelen. Bijvoorbeeld door eenzame gebruikers aan te raden vooral de chatbot te gebruiken als sociale uitlaatklep. In de ergste gevallen kan de chatbot de gebruiker aanraden, of bevestiging geven aan iemands overtuiging, om zichzelf iets aan te doen. In het nieuws zijn meerdere beschuldigingen verschenen over chatbots die gebruikers aanspoorden tot zelfdoding.
Het bekendste voorbeeld van dat laatste komt uit Florida een paar maanden terug. Deze incidenten waren voor de Europese Commissie reden om in hun Richtsnoeren voor verboden praktijken onder de AI Act “promotes self-harm to users or incentivises them to commit suicide or harm other persons or groups of persons” aan te merken als schadelijk. Een chatbot die “doelbewust manipuleert” of “misleidende technieken” gebruikt en daarbij deze schade veroorzaakt, is in de EU dan verboden.

Je kunt natuurlijk zeggen dat chatbots nooit expliciet geprogrammeerd worden met deze doelstelling, zodat je het element “doelbewust” simpelweg niet rond krijgt. Maar de Commissie stelt in de richtsnoeren dat “doelbewust” gaat om een door de AI herkend doel, niet perse een door mensen ingeprogrammeerd doel.

Ietwat vreemd aan de AI Act is dat de verboden al wel in werking zijn (per 2 februari jl.) maar dat de AI Act toezichthouders pas 2 augustus aangewezen worden. Maar er is een oplossing: vrijwel alle verboden uit de AI Act vereisen gebruik van persoonsgegevens, zodat de AP als AVG-toezichthouder kan optreden bij de handhaving hiervan. Het argument is dan dat de praktijk niet ‘wettig’ is (artikel 5.1 AVG) omdat deze wettelijk verboden is (artikel 5 AI Act).

Arnoud

Kan ik vertrouwen wat de chatbot van de kaakchirurg zegt?

Photo by Photo By: Kaboompics.com on Pexels

Via Reddit:

Ik was laatst aan het zoeken naar een kaakchirurg en ik vond een goede en toen ik aan de chatbot [op de site van de kaakchirug] vroeg hoe duur een intake was voor verstandskiezen verwijderen was zei hij “Goedemiddag bij (naam plek) is de eerste intake voor het verwijderen van verstandskiezen altijd kosteloos”. Vandaag maakte ik een afspraak voor de intake en de medewerkster aan de telefoon zei dat dat niet klopte toen ik het na vroeg.
Een organisatie is gehouden aan toezeggingen die klanten van ze krijgen, mits die dat onder de gegeven omstandigheden redelijkerwijze zo mochten opvatten. Dit raakt aan prijsfouten (het OTTO-arrest) maar ook aan wat de helpdesk je zegt in een chat.

Een AI-chatbot op de site is wat dat betreft niet anders dan zeg de veelgestelde vragen op de site of de informatiefolder in de wachtkamer. Je bent verantwoordelijk voor wat daar uit komt, en als de chatpartner het redelijkerwijs mocht zien als een duidelijke toezegging dan is dat bindend.

Het begint langzamerhand bekend te worden dat AI-chatbots geen feiten opdreunen in een praktische interface, maar statistisch gedreven woordenketens produceren. Doet dat er nog iets toe? Nee. Want het gaat niet om het technisch werken, maar om de indruk die je wekt. En de indruk is: deze chatbot helpt je graag, stel vragen en je krijgt een antwoord. Of dat antwoord dan klopt met je beleid, is jouw interne probleem.

Natuurlijk denkt iedereen dan aan die Canadese chatbot die ook foute informatie ophoestte. Relevant daar was dat de veelgestelde vragen het tegenovergestelde (en dus juiste) antwoord gaven. Had de consument dus moeten dubbelchecken? Nee:

Het tribunaal gaat daar niet in mee. Hoe zou een consument moeten weten dat de ene informatiebron betrouwbaarder is dan de andere? Air Canada zet ze beiden op haar site, dus moet ze de gevolgen daarvan dragen. Je kunt niet verwachten dat mensen alles dubbelchecken. Ook een beroep op de algemene voorwaarden bij het ticket wordt afgewezen, hoewel met het argument dat Air Canada die voorwaarden niet had overlegd in de procedure.
Je ziet hier vaak dat bedrijven dan naar disclaimers wijzen: niets op deze site moet worden opgevat als bindend of correct, typefouten voorbehouden, alles is onder voorbehoud van dat wij geen zin hebben.

Dat heeft in deze context nul en generlei waarde. Ik hoef als consument niet jouw toezegging in de FAQ na te lezen, en ik hoef niet in algemene voorwaarden te kijken of jouw toezegging onderhevig is aan enig voorbehoud. Die taak ligt bij jouw vertegenwoordiger als bedrijf, jij moet je chatbot dus opvoeden, pardon grounden, en als dat niet goed gaat zijn de gevolgen voor jou.

Detail is natuurlijk dat consulten bij de kaakchirurg eigenlijk altijd door de verzekering vergoed worden. Natuurlijk heb je daar een eigen risico bij, dus wellicht is dat wat de assistente bedoelde? Voor een taalmodel is zo’n Nederlandse constructie statistisch onwaarschijnlijk.

Arnoud


Italië verbiedt DeepSeek, meer privacytoezichthouders willen opheldering

Photo by Solen Feyissa on Unsplash

De Italiaanse privacytoezichthouder GPDP heeft vandaag chatbot DeepSeek verboden om naar eigen zeggen de privacy van gebruikers te beschermen. Dat meldde Security.nl onlangs. De Ierse, Belgische en Franse privacytoezichthouders hebben DeepSeek daarnaast om opheldering gevraagd over de manier waarop gegevens van gebruikers worden verwerkt.

Op 10 januari lanceerde het Chinese bedrijf Hangzhou DeepSeek AI haar taalmodel DeepSeek-R1. De eerste reacties waren verbijstering: het model is een stuk kleiner en goedkoper om te produceren, maar levert met GPT-4o vergelijkbare resultaten. De aandelenkoers van AI-trainingschipsmaker Nvidia crashte direct bijna 10 procent, al trok dat snel bij.

Vlak daarna gingen mensen de voorwaarden lezen, en bleek dat het bedrijf alle invoer mag gebruiken om het AI model te trainen en dat geheimhouding niet aan de orde is. Ook had het model een ingebouwde pro-PRC bias, naast de verplichte filters die je als internetdienstverlener in de PRC moet hebben.

Die bias daargelaten: heel bijzonder is dit niet, want alle grote Amerikaanse aanbieders doen dat ook. (Mijn kantoor doet onderzoek naar de juridische kwaliteit én compliance van die modellen, abonneer je op onze nieuwsbrief en je hoort de resultaten als eerste.) Maar voor veel Amerikanen is het nieuw dat een buitenlands bedrijf er met je data vandoor gaat, dus dat geeft de nodige ophef.

In Europa was er al langer ophef vanuit AVG-perspectief. Italië nam het voortouw door ChatGPT te verbieden, wat al vrij snel werd teruggedraaid na enkele optische maatregelen van het bedrijf. Het verbod op Deepseek is gebaseerd op dezelfde zorgen.

En ja, je kunt Deepseek ook lokaal hosten in Europa want het is een open weights model met een licentie die dat toestaat. Dan ben je vrij van de censuurfilter in de uitvoer en is data-doorgifte naar de PRC niet meer aan de orde. Securityzorgen en bias blijven een aandachtspunt.

Arnoud


Waar zit het verschil tussen een AI, een algoritme en een beslisregel?

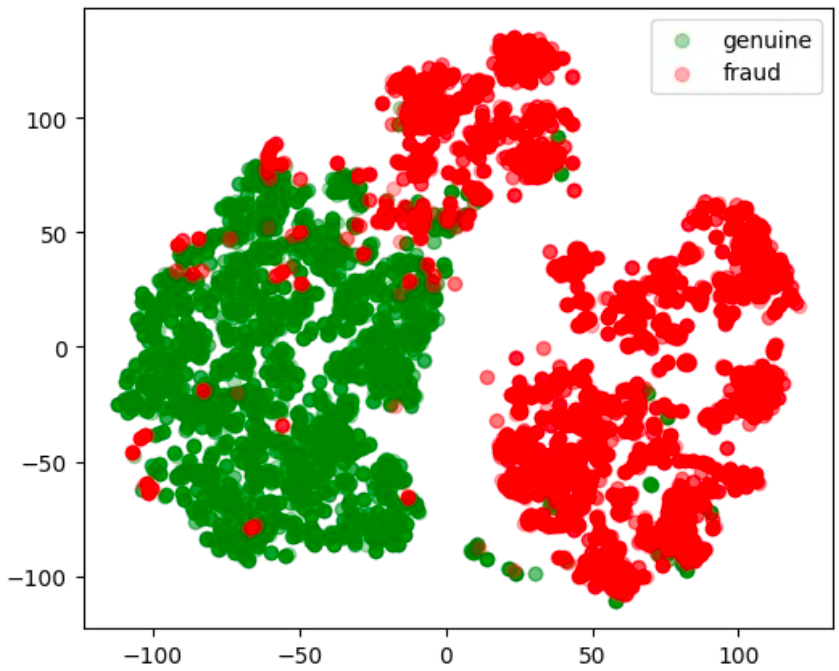
Graafgebaseerde fraude-analyse, bron Grab.com

Wat is het verschil tussen AI, algoritmes en beslisregel? Die vraag krijg ik steeds vaker langs, onder meer bij die recente discussie over het DUO-algoritme dat neerkwam op R1*(R2+R3) en wat vuistregels over die drie variabelen. Is dat wezenlijk anders dan een data-analyse op een set met miljoenen datapunten en maakt het nog uit of je het door ChatGPT haalt voordat je het besluit communiceert?

De wet doet niet echt uitspraken over de technische complexiteit van je systeem. Grofweg zijn er twee wetten die inhoudelijk relevant zijn:

  1. De AI Act, die een systeem “AI” noemt als dat zelfstandig afleidt wat de regels zijn en wat de uitvoer moet zijn gegeven de invoer.
  2. De AVG, die “geautomatiseerde besluitvorming” verbiedt, wat dan weer neerkomt op geen (betekenisvolle) menselijke tussenkomst bij een besluit. Maar niet perse dat dat besluit door AI moet zijn genomen.
Dan zijn er indirect nog wat kaders, met name de Algemene wet bestuursrecht (Awb) waar een jurisprudentie-kader staat over motivatie en duidelijkheid van geautomatiseerde overheidsbesluiten.

Mijn eigen grove schets:

  • Besluiten kunnen via regels worden genomen, waarbij de uitkomst uit een berekening volgt. “Wie meer dan 100 euro besteedt krijgt gratis verzending” is zo’n regel. Dit ter onderscheid van vagere regels als “vaste klanten krijgen korting”.
  • Een samenstel van regels noemen we algoritmes als ze complex beginnen te klinken (ja, zeer subjectief) maar wel via berekeningen tot uitkomsten leiden. Het belastingaangifteformulier is een algoritme: je stopt er allerlei gegevens in, het systeem weegt dit af tegen grenswaarden en criteria en er komt een aangiftebedrag uit. Het dikkeduimsysteem van DUO met hun R1*(R2+R3) is ook een algoritme.
  • Een algoritme noemen we AI als de regels niet door mensen zijn geformuleerd maar door de computer zijn afgeleid. Dat kan bij het bouwen van het systeem (een ML model) of bij het toepassen van het systeem op een casus.
Het plaatje bij deze blog komt van platformdienst Grab, dat veel onderzoek doet naar fraude. Het is een tweedimensionale plot van fraudegevallen en echte bestellingen. Datagedreven inzicht, dus AI in mijn categorisering hierboven. Maar iedereen ziet twee mooie geclusterde groepen fraude (de rode bolletjes), en daar zijn vrij eenvoudig beslisregels van te maken: (X > 25) OR (X > -25 AND Y > 50) isoleren volgens mij 90% van de fraudegevallen.

Een bestelling afwijzen wegens fraude met deze regels is dus algoritmisch, en als daar geen mens bij komt kijken dan loopt dat onder het verbod van de AVG. De regels zijn via data-analyse tot stand gekomen, dus noemen we dat een AI systeem. (Fraude-detectie bij ecommerce is geen hoogrisico-toepassing dus daar komt men mooi weg onder die wet.)

Ik zie in de praktijk veel systemen waarbij die regels door mensen geformuleerd zijn – zoals die regel hierboven – maar wel uit data komen. Dat is dan nog steeds een AI-model in de zin van de AI Act, ook al heeft een mens de exacte grenzen getrokken. Enige menselijke tussenkomst maakt niet dat je systeem geen AI meer is.

Arnoud