Toezichthouder waarschuwt voor schadelijke vriendschappen met AI-chatbots

Photo by Josh Sorenson on Pexels

Chatbots voor virtuele vriendschappen en therapie bij mentale problemen geven onbetrouwbare informatie en zijn soms schadelijk. Dat meldde Nu.nl onlangs. Uit een onderzoek van de Autoriteit Persoonsgegevens (AP) naar 9 populaire chatbotapps blijkt dat deze ongenuanceerde, ongepaste en soms zelfs schadelijke reacties geven op gebruikers die mentale problemen ter sprake brengen.

Het onderzoek is de halfjaarlijkse Rapportage AI- & Algoritmerisico’s Nederland (RAN). De risico’s van deze chatbots worden inderdaad geschetst, zij het als verwijzing naar externe media:

Daarbij is er de kans dat een chatbot de gebruiker aanraadt om contraproductief te handelen. Bijvoorbeeld door eenzame gebruikers aan te raden vooral de chatbot te gebruiken als sociale uitlaatklep. In de ergste gevallen kan de chatbot de gebruiker aanraden, of bevestiging geven aan iemands overtuiging, om zichzelf iets aan te doen. In het nieuws zijn meerdere beschuldigingen verschenen over chatbots die gebruikers aanspoorden tot zelfdoding.
Het bekendste voorbeeld van dat laatste komt uit Florida een paar maanden terug. Deze incidenten waren voor de Europese Commissie reden om in hun Richtsnoeren voor verboden praktijken onder de AI Act “promotes self-harm to users or incentivises them to commit suicide or harm other persons or groups of persons” aan te merken als schadelijk. Een chatbot die “doelbewust manipuleert” of “misleidende technieken” gebruikt en daarbij deze schade veroorzaakt, is in de EU dan verboden.

Je kunt natuurlijk zeggen dat chatbots nooit expliciet geprogrammeerd worden met deze doelstelling, zodat je het element “doelbewust” simpelweg niet rond krijgt. Maar de Commissie stelt in de richtsnoeren dat “doelbewust” gaat om een door de AI herkend doel, niet perse een door mensen ingeprogrammeerd doel.

Ietwat vreemd aan de AI Act is dat de verboden al wel in werking zijn (per 2 februari jl.) maar dat de AI Act toezichthouders pas 2 augustus aangewezen worden. Maar er is een oplossing: vrijwel alle verboden uit de AI Act vereisen gebruik van persoonsgegevens, zodat de AP als AVG-toezichthouder kan optreden bij de handhaving hiervan. Het argument is dan dat de praktijk niet ‘wettig’ is (artikel 5.1 AVG) omdat deze wettelijk verboden is (artikel 5 AI Act).

Arnoud

Kan ik vertrouwen wat de chatbot van de kaakchirurg zegt?

Photo by Photo By: Kaboompics.com on Pexels

Via Reddit:

Ik was laatst aan het zoeken naar een kaakchirurg en ik vond een goede en toen ik aan de chatbot [op de site van de kaakchirug] vroeg hoe duur een intake was voor verstandskiezen verwijderen was zei hij “Goedemiddag bij (naam plek) is de eerste intake voor het verwijderen van verstandskiezen altijd kosteloos”. Vandaag maakte ik een afspraak voor de intake en de medewerkster aan de telefoon zei dat dat niet klopte toen ik het na vroeg.
Een organisatie is gehouden aan toezeggingen die klanten van ze krijgen, mits die dat onder de gegeven omstandigheden redelijkerwijze zo mochten opvatten. Dit raakt aan prijsfouten (het OTTO-arrest) maar ook aan wat de helpdesk je zegt in een chat.

Een AI-chatbot op de site is wat dat betreft niet anders dan zeg de veelgestelde vragen op de site of de informatiefolder in de wachtkamer. Je bent verantwoordelijk voor wat daar uit komt, en als de chatpartner het redelijkerwijs mocht zien als een duidelijke toezegging dan is dat bindend.

Het begint langzamerhand bekend te worden dat AI-chatbots geen feiten opdreunen in een praktische interface, maar statistisch gedreven woordenketens produceren. Doet dat er nog iets toe? Nee. Want het gaat niet om het technisch werken, maar om de indruk die je wekt. En de indruk is: deze chatbot helpt je graag, stel vragen en je krijgt een antwoord. Of dat antwoord dan klopt met je beleid, is jouw interne probleem.

Natuurlijk denkt iedereen dan aan die Canadese chatbot die ook foute informatie ophoestte. Relevant daar was dat de veelgestelde vragen het tegenovergestelde (en dus juiste) antwoord gaven. Had de consument dus moeten dubbelchecken? Nee:

Het tribunaal gaat daar niet in mee. Hoe zou een consument moeten weten dat de ene informatiebron betrouwbaarder is dan de andere? Air Canada zet ze beiden op haar site, dus moet ze de gevolgen daarvan dragen. Je kunt niet verwachten dat mensen alles dubbelchecken. Ook een beroep op de algemene voorwaarden bij het ticket wordt afgewezen, hoewel met het argument dat Air Canada die voorwaarden niet had overlegd in de procedure.
Je ziet hier vaak dat bedrijven dan naar disclaimers wijzen: niets op deze site moet worden opgevat als bindend of correct, typefouten voorbehouden, alles is onder voorbehoud van dat wij geen zin hebben.

Dat heeft in deze context nul en generlei waarde. Ik hoef als consument niet jouw toezegging in de FAQ na te lezen, en ik hoef niet in algemene voorwaarden te kijken of jouw toezegging onderhevig is aan enig voorbehoud. Die taak ligt bij jouw vertegenwoordiger als bedrijf, jij moet je chatbot dus opvoeden, pardon grounden, en als dat niet goed gaat zijn de gevolgen voor jou.

Detail is natuurlijk dat consulten bij de kaakchirurg eigenlijk altijd door de verzekering vergoed worden. Natuurlijk heb je daar een eigen risico bij, dus wellicht is dat wat de assistente bedoelde? Voor een taalmodel is zo’n Nederlandse constructie statistisch onwaarschijnlijk.

Arnoud


Italië verbiedt DeepSeek, meer privacytoezichthouders willen opheldering

Photo by Solen Feyissa on Unsplash

De Italiaanse privacytoezichthouder GPDP heeft vandaag chatbot DeepSeek verboden om naar eigen zeggen de privacy van gebruikers te beschermen. Dat meldde Security.nl onlangs. De Ierse, Belgische en Franse privacytoezichthouders hebben DeepSeek daarnaast om opheldering gevraagd over de manier waarop gegevens van gebruikers worden verwerkt.

Op 10 januari lanceerde het Chinese bedrijf Hangzhou DeepSeek AI haar taalmodel DeepSeek-R1. De eerste reacties waren verbijstering: het model is een stuk kleiner en goedkoper om te produceren, maar levert met GPT-4o vergelijkbare resultaten. De aandelenkoers van AI-trainingschipsmaker Nvidia crashte direct bijna 10 procent, al trok dat snel bij.

Vlak daarna gingen mensen de voorwaarden lezen, en bleek dat het bedrijf alle invoer mag gebruiken om het AI model te trainen en dat geheimhouding niet aan de orde is. Ook had het model een ingebouwde pro-PRC bias, naast de verplichte filters die je als internetdienstverlener in de PRC moet hebben.

Die bias daargelaten: heel bijzonder is dit niet, want alle grote Amerikaanse aanbieders doen dat ook. (Mijn kantoor doet onderzoek naar de juridische kwaliteit én compliance van die modellen, abonneer je op onze nieuwsbrief en je hoort de resultaten als eerste.) Maar voor veel Amerikanen is het nieuw dat een buitenlands bedrijf er met je data vandoor gaat, dus dat geeft de nodige ophef.

In Europa was er al langer ophef vanuit AVG-perspectief. Italië nam het voortouw door ChatGPT te verbieden, wat al vrij snel werd teruggedraaid na enkele optische maatregelen van het bedrijf. Het verbod op Deepseek is gebaseerd op dezelfde zorgen.

En ja, je kunt Deepseek ook lokaal hosten in Europa want het is een open weights model met een licentie die dat toestaat. Dan ben je vrij van de censuurfilter in de uitvoer en is data-doorgifte naar de PRC niet meer aan de orde. Securityzorgen en bias blijven een aandachtspunt.

Arnoud


Waar zit het verschil tussen een AI, een algoritme en een beslisregel?

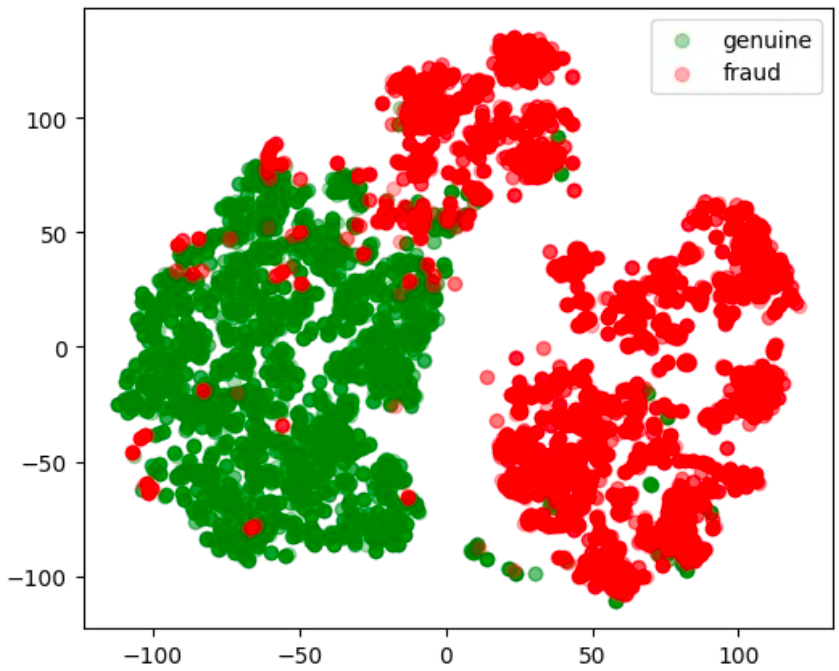
Graafgebaseerde fraude-analyse, bron Grab.com

Wat is het verschil tussen AI, algoritmes en beslisregel? Die vraag krijg ik steeds vaker langs, onder meer bij die recente discussie over het DUO-algoritme dat neerkwam op R1*(R2+R3) en wat vuistregels over die drie variabelen. Is dat wezenlijk anders dan een data-analyse op een set met miljoenen datapunten en maakt het nog uit of je het door ChatGPT haalt voordat je het besluit communiceert?

De wet doet niet echt uitspraken over de technische complexiteit van je systeem. Grofweg zijn er twee wetten die inhoudelijk relevant zijn:

  1. De AI Act, die een systeem “AI” noemt als dat zelfstandig afleidt wat de regels zijn en wat de uitvoer moet zijn gegeven de invoer.
  2. De AVG, die “geautomatiseerde besluitvorming” verbiedt, wat dan weer neerkomt op geen (betekenisvolle) menselijke tussenkomst bij een besluit. Maar niet perse dat dat besluit door AI moet zijn genomen.
Dan zijn er indirect nog wat kaders, met name de Algemene wet bestuursrecht (Awb) waar een jurisprudentie-kader staat over motivatie en duidelijkheid van geautomatiseerde overheidsbesluiten.

Mijn eigen grove schets:

  • Besluiten kunnen via regels worden genomen, waarbij de uitkomst uit een berekening volgt. “Wie meer dan 100 euro besteedt krijgt gratis verzending” is zo’n regel. Dit ter onderscheid van vagere regels als “vaste klanten krijgen korting”.
  • Een samenstel van regels noemen we algoritmes als ze complex beginnen te klinken (ja, zeer subjectief) maar wel via berekeningen tot uitkomsten leiden. Het belastingaangifteformulier is een algoritme: je stopt er allerlei gegevens in, het systeem weegt dit af tegen grenswaarden en criteria en er komt een aangiftebedrag uit. Het dikkeduimsysteem van DUO met hun R1*(R2+R3) is ook een algoritme.
  • Een algoritme noemen we AI als de regels niet door mensen zijn geformuleerd maar door de computer zijn afgeleid. Dat kan bij het bouwen van het systeem (een ML model) of bij het toepassen van het systeem op een casus.
Het plaatje bij deze blog komt van platformdienst Grab, dat veel onderzoek doet naar fraude. Het is een tweedimensionale plot van fraudegevallen en echte bestellingen. Datagedreven inzicht, dus AI in mijn categorisering hierboven. Maar iedereen ziet twee mooie geclusterde groepen fraude (de rode bolletjes), en daar zijn vrij eenvoudig beslisregels van te maken: (X > 25) OR (X > -25 AND Y > 50) isoleren volgens mij 90% van de fraudegevallen.

Een bestelling afwijzen wegens fraude met deze regels is dus algoritmisch, en als daar geen mens bij komt kijken dan loopt dat onder het verbod van de AVG. De regels zijn via data-analyse tot stand gekomen, dus noemen we dat een AI systeem. (Fraude-detectie bij ecommerce is geen hoogrisico-toepassing dus daar komt men mooi weg onder die wet.)

Ik zie in de praktijk veel systemen waarbij die regels door mensen geformuleerd zijn – zoals die regel hierboven – maar wel uit data komen. Dat is dan nog steeds een AI-model in de zin van de AI Act, ook al heeft een mens de exacte grenzen getrokken. Enige menselijke tussenkomst maakt niet dat je systeem geen AI meer is.

Arnoud

Bitcoins zijn geen geld, dus moeten als bitcoin worden teruggegeven

Photo by Traxer on Unsplash

Bitcoin kwalificeert niet als geld in de zin van Afdeling 11 van Titel 1 van Boek 6 BW, zodat de vordering tot betaling van de tegenwaarde in Euro niet toewijsbaar is. Aldus het Hof Den Haag, ietwat droge bewoordingen voor “krijgt de eiser een paar duizend euro of bijna anderhalve ton”.

Het achterliggende geschil is wat rommelig omschreven, er komt ineens een mining park om de hoek kijken bijvoorbeeld. Maar de kern is dat er ergens in 2018/begin 2019 twee bitcoins (naast €2500 aan geld) zijn uitgeleend, en die wilde de uitlenende partij terug. Dat is een paar duizend tegen de toenmalige koers – maar rond de €140 duizend euro vandaag de dag, als ik het goed reken.

De rechter kende de eis tot terugbetaling toe, en rekende daarbij met de geldswaarde van de bitcoins op de datum van vonnis, wat toen € 38.889 betrof. In hoger beroep keurt het Hof dat af:

De primaire vordering tot betaling van de tegenwaarde (tegen de koers van 20 april 2022) in Euro van twee bitcoins, is niet toewijsbaar. Bitcoin kwalificeert niet als geld in de zin van Afdeling 11 van Titel 1 van Boek 6 BW, zodat artikel 6:123 lid 1 BW toepassing mist. [verweerder] heeft geen (andere) grondslag aangevoerd voor zijn hier bedoelde primaire vordering. Het hof zal daarom het bestreden vonnis vernietigen voor zover [appellant] is veroordeeld tot betaling van die tegenwaarde van twee bitcoins tegen de koers van 20 april 2022, en de vordering in zoverre afwijzen.]
De rechter mag alleen vonnissen dat je de dagwaarde betaalt van iets dat geld is. Bitcoin is geen geld, iets dat we al vaker langs hebben zien komen. En dan moet het ding zelf, dus de bitcoin teruggegeven worden.

De exacte uitgeleende bitcoins zijn niet meer te achterhalen, dus dan mogen het twee andere zijn, zolang het er maar precies twee zijn. En ja, dat kan dus betekenen dat je er nu twee moet gaan kopen op de vrije markt en die twee moet geven aan je uitleenovereenkomstwederpartij.

Dus voor wie pakt dit gunstig uit? Op het eerste gezicht voor de uitlener – die krijgt immers twee bitcoins ter waarde van €140.000 terug voor een lening die oorspronkelijk ‘slechts’ enkele duizenden euro’s waard was. Maar is dat wel eerlijk? En belangrijker: is dat wel wat we willen in een volwassen cryptomarkt?

Of moeten we juist blij zijn met deze uitspraak omdat die dwingt tot betere contracten en risico-inschatting? Want laten we eerlijk zijn: wie in 2019 bitcoins uitleende zonder duidelijke afspraken over terugbetaling, speculeerde bewust of onbewust op waardestijging.

Arnoud


Is fraudebepaling op basis van afstand nu ook al discriminatie?

Photo by RDNE Stock project on Pexels

Een fraudeaanpak van de Nederlandse Dienst Uitvoering Onderwijs was discriminerend en onrechtmatig, zegt de Autoriteit Persoonsgegevens. Dat meldde Tweakers onlangs. De frauderisicoscore werd berekend op basis van onderwijssoort, afstand en leeftijd. Dat mag niet, en ik grijp deze casus aan om eens héél fundamenteel naar algoritmische fraudedetectie te kijken.

De kern van het probleem staat in het persbericht van de AP:

DUO gaf studenten een ‘risicoscore’ door naar onderwijssoort, afstand tussen adressen en leeftijd te kijken. Voor die criteria was geen objectieve rechtvaardiging. Dat maakte deze werkwijze discriminerend en dus onrechtmatig.
Volgens de Grondwet is onderscheid op íedere grond in principe verboden – je moet een (objectieve) rechtvaardiging hebben om die grond te mogen inroepen. Je moet 16 zijn om op een ebike te mogen, omdat je (gemiddeld) pas dan genoeg ontwikkeld bent deze veilig te gebruiken. Je mag niet meer dan een uur reizen van je werk wonen, want de reistijd breekt je op zo weten wij uit ervaring. Zulke dingen.

Dat zijn bewezen regels: we hebben gezien dat deze vaak genoeg kloppen, dus daar trekken we een grens. Steeds vaker zien we datagedreven regels, waarbij de data laat zien waar de grenzen liggen. Die grenzen worden dan de criteria, en dat heet dan objectief omdat het uit Excel komt.

In dit onderzoek komt het algoritme neer op drie individuele scores, met een totaalscore (“risicofactor” of RF) als R1*(R2+R3):

  • R1: het soort onderwijs. Een MBO-opleiding levert een hogere risicoscore op dan een WOopleiding.
  • R2: een combinatie van leeftijd en kortste afstand tussen het adres van de student en het adres van (een van de) ouder(s). Een kortere afstand tussen de student en de ouder(s) leidt tot een hogere risicoscore.
  • R3: een extra risicofactor op basis van leeftijd: Een lagere leeftijd resulteert in een hogere risicoscore.
De score werd platgeslagen tot zes niveaus, van zeer hoog tot zeer laag (+onbekend). Sorteer je datadump op deze niveaus en je weet bij wie je langs moet.

Oké, maar hoe kwam men dan aan die drie factoren? Welke data-analyse had laten zien dat dat de factoren waren? Ik citeer het onderzoeksrapport: “ervaring en gezond verstand”. Dat kan ik vrij moeilijk een ‘algoritme’ of ‘data-analyse’ noemen. En ja, heel formeel is dan sprake van onrechtmatige verwerking want je kunt niet rechtvaardigen waarom deze keuzes. “Gezond verstand” is geen reden.

Maar goed, stel dat men nu wél de originele datadump had voorzien van labels “gebleken fraudeur” en “geen fraudeur”. En dan een machine learning model had laten ploegen op het onderscheid tussen die twee. En dat model had dan een correlatie gevonden volgens R1*(R2+R3). Had het dan wél gemogen?

“De data laat het zien”. Want wat ziet die data dan precies? Een correlatie, een statistisch verband. Maar correlatie is geen causatie. Als uit de data blijkt dat MBO-studenten vaker frauderen, betekent dat nog niet dat MBO het frauderen veroorzaakt. Misschien worden MBO-studenten wel vaker gecontroleerd, waardoor er meer fraude wordt ontdekt. (En dat versterkt weer de dataset, een klassieke feedbackloop.) Of misschien spelen sociaal-economische factoren een rol die we helemaal niet meenemen in de analyse en die toevallig samengaan met MBO student zijn.

Stel, we hebben een complete dataset: alle studenten, alle controles, objectief en eerlijk verdeeld. En dán blijkt dat 30% van de MBO’ers fraudeert tegenover een algemeen gemiddelde van 10%. Dan kan ik me wat voorstellen bij “is MBO student” als criterium, hoewel dit nog steeds een vorm van collectieve verdachtmaking  blijkt: je bestempelt 100% van de MBO’ers als risicogeval terwijl nog steeds 70% van hen gewoon netjes studeert.

Meer algemeen is dit een bolvormige koe: nooit van z’n leven krijg je zo’n complete, accurate en eerlijke dataset op basis waarvan je analyse gaat doen. Alleen dat zou al genoeg moeten zijn om hier zeer huiverig in te zijn.

Verder heb ik er nog een fundamenteel bezwaar bij. Datagedreven analyse mist het normatieve fundament dat we anders wél hebben bij het maken van regels. Neem die fatbike-regel: die is er niet omdat Excel dat zei, maar omdat we als maatschappij vinden dat ernstige ongevallen voorkomen moeten worden. De data ondersteunt dat (16-jarigen hebben inderdaad minder ongelukken), maar de réden voor de regel zit in onze waarden: mensenlevens beschermen, zorgkosten beheersen, verkeersverantwoordelijkheid.

Bij pure data-analyse verdwijnt dat normatieve kader. We vinden wel verbanden, maar het systeem kan niet uitleggen waarom die verbanden relevant zouden moeten zijn voor ons beleid. Tot welke grondslag, welke maatschappelijke opvatting de regel te herleiden is. Waarom we dit moeten willen. En dan belanden we in een gevaarlijke cirkel: we baseren regels op data omdat die data het “aantoont”, en vervolgens gebruiken we diezelfde data als rechtvaardiging voor de regel. Maar nergens in die cirkel zit nog het antwoord op de vraag: waarom willen we deze regel eigenlijk? Welk maatschappelijk belang dienen we ermee? Het wordt een soort zwevend systeem dat zichzelf in stand houdt, zonder verbinding met de waarden waar het eigenlijk om zou moeten gaan.

Arnoud
Wanneer verdient gefotoshopte content het label “AI assisted”?

Photo by Florinel ZONE on Unsplash

Een probleem bij Facebook en collega’s: je krijgt al vrij snel het label “AI assisted” of vergelijkbaar aan je beeldmateriaal. Moederbedrijf Meta worstelt met hoe dit aan te pakken, omdat zij nepbeeld wil aanpakken maar er nauwelijks goede criteria zijn. Maar op dit moment is het “als je Adobe®? Photoshop gebruikt, krijg je het label” en dat is ook weer niet heel handig.

De opkomst van AI-beeldgeneratoren heeft geleid tot een stortvloed aan nepbeeld en AI-revisies. Soms bizar (zoals Shrimp Jesus), soms gewoon nieuwe kunst en soms welbewuste manipulatie van de werkelijkheid – en van alles daar tussenin.

Dit aanpakken begint bij het herkennen, en daar ligt ook meteen het probleem. De meeste bedrijven in deze sector doen mee aan wat Adobe Content Credentials heeft genoemd: een label in de metadata waarin kort opgesomd staan welke handelingen met AI zijn uitgevoerd. Deze is via een stevige hash verbonden aan de afbeelding, en kan dus ook geverifieerd worden als het label uit het beeld gehaald worden (en ook na bepaalde triviale manipulaties zoals roteren).

Facebook, Instagram en collega’s screenen op dit label, en tonen dan een waarschuwing: “Made with AI”, tegenwoordig “AI Info”. Van tegenhouden of andere maatregelen is (vooralsnog) geen sprake, en in het kader van transparantie is dit al een mooie stap natuurlijk. (Het moet ook in het kader van de zorgplicht onder de DSA die deze platforms hebben.)

Probleem is natuurlijk: wanneer is iets “made with AI” of “AI assisted”. Heel veel aanpassingen die we de afgelopen twintig jaar als “image was enhanced using Adobe® Photoshop® software” (deze frase is verplicht) hebben omschreven, worden tegenwoordig als AI-aanpassingen gezien. Niet alleen generatief (het uitbreiden van je canvas) maar ook basale zaken als objecten herkennen en vervangen. Dit speelt natuurlijk ook bij andere tools.

Ik denk niet dat je hier ooit echt uitkomt. Het compromis dat nu gevonden is, komt neer op een onderscheid tussen “de afbeelding kwam in de basis uit een genAI tool” en “de afbeelding is aangepast met AI-achtige tools”. Die eerste krijgen het label, bij die tweede zie je het pas als je de foto-informatie opvraagt. Ideaal is dat niet, maar ik weet niet hoe het beter zou moeten.

Arnoud


AI gaat helpen op de SEH, mag dat van de AIA?

Foto DennisM2, Flickr (PD)

Op de spoedeisende hulp van het St. Antonius Ziekenhuis in Utrecht wordt sinds begin deze maand gebruikgemaakt van artificiële intelligentie (AI). Dat meldde lokale krant DUIC. Het systeem adviseert bij de beslissing of mensen moeten worden opgenomen of niet, zodat men eerder kan beginnen met plannen. Een mooiere aanleiding om mijn boek te pluggen, pardon het over de AI Act te hebben weet ik even niet.

Het ziekenhuis legt uit hoe het werkt:

Het algoritme gebruikt gegevens zoals leeftijd, bloedwaarden, hartslag en de hoofdklacht, om te voorspellen welke patiënten waarschijnlijk moeten worden opgenomen en welke ontslagen kunnen worden. Voor elke patiënt berekent het algoritme elke 5 minuten opnieuw de kans op opname of ontslag en past de verwachting aan als nieuwe uitslagen daar aanleiding toe geven.
Het voornaamste doel is sneller het proces van opnemen (bed vrijmaken, behandelaars alarmeren et cetera) op gang brengen. Dit kan in de praktijk soms uren duren, zeker als een buitenbed geregeld moet worden. Het blijft een advies, zo benadrukt men: uiteindelijk beslist altijd de arts.

Valt dit nu onder de AI Act als een hoogrisico-toepassing? Dat kan in twee gevallen in de context van gezondheidszorg:

  1. De AI is een gereguleerd apparaat onder de Medical Device Regulation (MDR), of een veiligheidscomponent daarvan.
  2. De AI is bedoeld om noodoproepen te classificeren of afhandeling te prioriteren, of voor de triage van patiënten die dringend medische zorg behoeven.
Over die tweede kan ik kort zijn. We zijn hier al voorbij de triage, want de patiënt is al binnen bij de SEH en er moet worden vastgesteld wat er nu met deze moet gebeuren. Triage is bij de deur bepalen hoe kritiek de hulpbehoefte is en of de patiënt naar binnen moet. Dat is dus niet van toepassing.

De MDR reguleert medische hulpmiddelen. Dit zijn apparaten, isntrumenten “of andere artikelen” die bestemd zijn om bij de mens te dienen voor

diagnose, preventie, monitoring, voorspelling, prognose, behandeling of verlichting van ziekte, diagnose, monitoring, behandeling, verlichting of compensatie van een letsel of een beperking, [etc]
Deze softwaretool wordt gebruikt voor monitoring en voorspelling bij mensen met ziekte, letsel of beperking. Dat het enkel gaat om een advies, maakt daarbij niet uit. Deze tool is dus een medisch hulpmiddel op zich, en daarmee hoogrisico.

Hoogrisico betekent: doe een conformiteitsassessment, heb een kwaliteits- en risicomanagementsysteem en zorg dat je data kwalitatief goed is. Screen op dingen die mis kunnen gaan, en heb een proces om in te grijpen.

Gelukkig voor het Antonius krijgen ze pas over drie jaar met deze eisen te maken, want voor gereguleerde producten kent de AI Act een uitgesteld regime. Heel erg is dat niet, want de MDR kent zelf ook al dergelijke eisen, waar een ziekenhuis overigens prima mee om kan gaan.

In deze analyse ben ik totaal niet ingegaan op hoe accuraat, zorgwekkend, vernieuwend of anderszins risicovol de toepassing is. Daar is een leuke boom of wat over op te zetten, natuurlijk. Er is het al wat oudere voorbeeld van een triage-AI die patiënten met een mogelijke beginnende longontsteking aanraadt het nog een nachtje aan te kijken. Prima advies, alleen niet als de patiënt astma heeft – dan moet je direct naar de SEH. Alleen zat die uitkomst niet in de dataset.

Het punt van de AI Act is: dat doet er niet toe. De analyse is formeel. Je kijkt of je valt onder een van de gereguleerde producten of een van de genoemde use cases. Zo ja, ben je hoog risico. Zo nee, ben je dat niet. Dat de AVG of andere wetgeving er iets van vindt in termen van risico, staat daar helemaal los van.

Weten hoe de AI Act precies in elkaar steekt? Koop dan mijn boek The Annotated AI Act. In 411 pagina’s krijg je elk artikel van deze nieuwe wet geduid en van context voorzien.

Arnoud


Mag een cryptobeurs eisen dat ik de herkomst van crypto uit 2015 kan bewijzen?

Photo by David McBee on Pexels

Een lezer vroeg me:

Bij een herkomst van middelen-onderzoek bij een Nederlandse crypto-beurs kon ik gelukkig bewijs vinden in een toevallig gevonden backup uit 2015. De Belastingdienst had alleen de gegevens van de afgelopen 7 jaar, en de bank kon maar vijf jaar teruggaan. Bovendien zijn bankafschriften alleen niet genoeg als bewijs, volgens die beurs. Hoe zit dat wettelijk, zijn legale investeringen van 7 jaar oud ineens zwart tenzij je kunt bewijzen dat ze wit zijn?
Dit soort onderzoeken zijn inderdaad wettelijk verplicht (Wwft), al is de exacte scope en diepgang nog onderwerp van veel discussie. De kern is dat men geld verkregen uit misdrijven (witwassen) maar ook geld waarover geen belasting is betaald (grijs geld) wil kunnen opsporen, en deze schone taak bij banken en cryptobeurzen heeft gelegd.

De bewijslast bij dit soort zaken ligt bij de bezitter van het geld. Die moet kunnen aantonen dat het geld legaal verkregen is. Althans, in de praktijk. Op papier moet het OM of de Belastingdienst natuurlijk hardmaken dat sprake is van fraude, belastingontduiking of witwassen. Maar heel vaak komt dat neer op aantonen dat de oorsprong niet evident legaal is en een aanwijzing dat er iets schimmigs rondom de bezitter hangt. Daarna komt de bal bij de bezitter te liggen: waar komt het geld dan wél vandaan?

De juridische rechtvaardiging hiervoor is dat jij in principe eenvoudig kunt zeggen waar je geld vandaan komt. Je krijgt immers zelden geld zonder dat jij weet waarom of van wie. En het OM kan moeilijk aan een sok met bankbiljetten zien of dat uit “enig misdrijf” afkomstig is.

Deze harde regel komt in ieder geval zo terug bij hoe banken en cryptobeurzen handhaven. Bij ‘oud geld’ kan het inderdaad zijn dat je dan in bewijsnood komt, want wie weet er nog hoe hij in 2015 een bitcoin had verkregen? Maar de wet biedt daarvoor geen escape.

(Ik heb zelf ooit in 2013 een bitcoin gemined puur om te zien of ik het kon, maar zou niet weten hoe ik nu de herkomst daarvan had moeten bewijzen.)

Arnoud

“Dit gesprek kan worden opgenomen voor AI-trainingsdoeleinden”

Photo by Petr Machá?ek on Unsplash

Talkdesk en veel andere [Customer Care]aaS-leveranciers gebruiken de inhoud van de gesprekken van de klanten van hun eigengebruikers om hun AI-modellen te trainen. Dat las ik bij Ziptone onlangs. Aanleiding was een rechtszaak aangespannen door een Californische consument die daar niet op zat te wachten. Het riep de vraag op: hoe zou je dat legaal kunnen inrichten in Nederland?

Iedereen denkt wellicht aan de AI Act, maar die zegt niet zo gek veel over hoe je aan databestanden komt om een AI mee te trainen. Ja, als je toepassing hoogrisico is dan moet die data “relevant, voldoende representatief, en zoveel mogelijk foutenvrij en volledig met het oog op het beoogde doel” zijn (artikel 10 lid 3 AIA). Maar eisen zoals “met toestemming verkregen” zul je niet terugvinden in deze wet.

Wél daarover gaat natuurlijk de AVG: het opnemen van een zakelijk telefoongesprek, of het loggen van een zakelijke chat, is een verwerking van persoonsgegevens. Dat gebeurt met een doel – het bewijzen van de geleverde dienst of eventuele geschillen (uitvoering overeenkomst), of het meer algemeen verbeteren van de dienstverlening (“service- en trainingsdoeleinden“). Het kan ook met toestemming, maar buiten salesgesprekken zie je dat eigenlijk nooit.

Het AVG-technisch probleem is met name dat doel, in vaktermen de doelbinding. De gegevens worden verkregen voor het ene doel (die servicedoeleinden, bewijsvoering, etc) en nu ingezet voor iets anders, namelijk het samenstellen van een dataset waarmee een AI getraind gaat worden. Je kunt dat op twee manieren doen:

  1. Binnen de AVG, waarbij je te maken krijgt met beperkingen zoals doelbinding en grondslagen.
  2. Buiten de AVG, waarbij die beperkingen niet gelden maar je wel écht anonieme data moet hebben.
Het is vrij moeilijk om data echt te anonimiseren, ook bij spraak: in zo’n gesprek kan een klantnaam of -nummer worden genoemd, of een uitspraak worden gedaan over betaling, adressen en ga zo maar door.

De enige escape is dan wellicht nog de bepaling uit de AVG dat verdere verwerking voor statistische doeleinden (art. 5 lid 1b AVG) geen probleem met doelbinding is. Het is alleen onduidelijk of deze bepaling ingeroepen kan worden als het “statistische doeleind” eigenlijk een commercieel inzetbaar AI datamodel is.

Arnoud