Chinese rechtbank ziet AI-gegenereerde kunst als inbreuk op auteursrecht

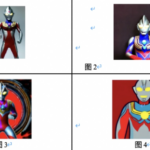
De Guangzhou Internet Court heeft recent geoordeeld dat de uitvoer van een AI inbreuk op auteursrecht kan zijn, las ik in de Global Times. De rechthebbende had ontdekt dat als je vroeg om plaatjes van zijn werk – Ultraman – je dan plaatjes kreeg die auteursrechtelijk gezien inbreukmakend waren. De AI-dienst is daarvoor aansprakelijk, zo bepaalde de rechter.

Helaas is de naam van de AI-plaatjesdienst niet te vinden, maar de eiser is de rechthebbende op de Japanse Ultraman franchise, en die had dus zelf ontdekt dat vragen om plaatjes van dat werk (zie plaatje, klik voor groter) je de ‘echte’ Ultraman kreeg.

Niet heel raar zou je zeggen: je vraagt om X en je krijgt X, dat voelt de bedoeling van een computersysteem. Maar specifiek als X onder iemands auteursrecht (of merk) valt, is dit een tikje problematisch. Auteursrechtelijk gezien mag je ook niet een illustrator vragen om zo’n afbeelding te maken, immers.

Uniek is het niet: in januari verscheen een artikel in de New York Times waarbij men ‘ontdekte’ dat als je vraagt om “popular movie screencap Joker” je een afbeelding van Batman-personage The Joker krijgt die erg sterk lijkt op de wijd en zijd gepubliceerde foto van Joaquin Phoenix in die rol. Maar dit is wel de eerste keer dat een rechtbank dit ook als inbreuk ziet.

De rechtbank in Guangzhou oordeelde d dat de afbeelding inbreukmakend was, omdat deze duidelijke overeenstemming had met het beschermde personage van Ultraman. Iets verrassender was de bevinding dat de aanbieder van de dienst hiervoor aansprakelijk was. (Er moet een slordige €1200 aan schadevergoeding worden betaald.)

Het lijkt erop dat de reden vooral was het niet adequaat waarschuwen en optreden tegen inbreuken:

[T]he judgment specified that since users lack clear awareness of the potential copyright infringement risks to others, especially copyright owners, providers of generative AI services should remind users through service agreements. The court also ordered AI service providers to establish a complaint-reporting mechanism to assist rights holders in protecting their copyrights.
Een dergelijke uitspraak zou ook naar Europees recht logisch kunnen zijn. Goed verdedigbaar is dat zo’n generatieve AI-dienst valt onder wat de Digital Services Act een “platformdienst” noemt, met bijbehorende bescherming voor aansprakelijkheid. Die moeten echter wel adequate notice&action mechanismes hebben om klachten te ontvangen en af te handelen, en de voorwaarden van de dienst moeten duidelijk en in detail gemotiveerd aangeven wat er wel en niet mag en welke sanctie er bij overtreding kan volgen.

Arnoud
Basic-Fit zet camera’s in die gezondheidsproblemen en agressie detecteren

edwardbrownca / Pixabay

Fitnessketen Basic-Fit zet AI-gestuurde ‘slimme camera’s’ en sensoren in om agressie, ongeautoriseerde toegang, gezondheidsproblemen, zoals flauwvallen, en andere incidenten te herkennen. Dat meldde Security.nl onlangs. Technologieleverancier Axis spreekt van een “revolutionaire oplossing”, ik spreek van een interessant AI Act-vraagstuk.

Het is moeilijk op de Axis-site een uitleg te geven die niet leest als een ChatGPT tekst, maar bij deze:

Smart cameras that are used for their sensory-like functions and remote control mechanisms are deployed in each gym. The various Axis products work together with a specifically designed AI algorithm to quickly detect and address issues on site, while also enabling gyms to operate 24 hours a day. Gym members can therefore feel safe, even when there is no staff around. In case of need or an emergency, a specially designed remote control room can be contacted from the Basic-Fit location. From there health concerns, aggression, fraud, and even foot traffic is monitored.
De kern is dus “slimme camera’s” die aan emotieherkenning doen, en op basis daarvan alarmpjes geven aan een menselijk toezichthouder. En dat gaf mij dan weer een alarmpje, want ‘emotieherkenning’ is zeg maar een dingetje onder de AI Act die binnenkort van kracht wordt.

Emotieherkenning is een van de controversieelste toepassingen van AI/ML. Het idee is dat je door analyse van uiterlijke kenmerken kunt vaststellen hoe iemand zich voelt – plus dat je dat kunt terugbrengen tot een serie labels zoals vreugde, woede, angst, walging, minachting, verdriet en verrassing. Voor geen van deze twee dingen is wetenschappelijke consensus, maar door het in een computer te stoppen en die “AI” te noemen creëert men een sfeer dat dit een opgelost probleem is. Dus als de AI zegt dat persoon A “woedend” is, dan gaat er een bewaker naar de locatie om persoon A de-escalerend aan te spreken en te verwijderen.

Mag het? Op dit moment wel. De AVG regelt het een en ander over cameratoezicht (zie het reglement), en bevat daarnaast regels over profileren en automatische besluitvorming. Maar wat hier gebeurt, is nog geen besluitvorming. De AI stuurt er een mens op af, waarna de mens op locatie het besluit neemt (“oh nee, hij was stoom aan het afblazen omdat hij leg day niet ziet zitten”). De analyse wordt verder niet aan je klantprofiel gekoppeld en er wordt verder ook niets mee gedaan. AVG-technisch lijkt dit dus wel in orde.

De AI Act kijkt er wat anders tegenaan. Het is niet verboden – het verbod op emotieherkenning geldt alleen bij gebruik op het werk of in het onderwijs. Bij vrij sporten zoals hier, is dat niet aan de orde (de trainers/werknemers worden hier niet mee gemonitord). Het is wel een hoog-risico AI (artikel 1(ab) van Annex III), dus het triggert een berg eisen zoals een risicomanagementsysteem, uitgebreide logging, adequaat menselijk toezicht en marktmonitoring op incidenten.

De AI Act is nog niet formeel aangenomen (verwachting: april) dus het is niet raar dat Axis nog niets zegt over hoe ze aan de wet voldoet. Daar hebben ze net als iedereen nog (slechts) twee jaar voor, want op dat moment moeten alle aspecten opgezet zijn. En dat is minder tijd dan je denkt.

Een bijkomstigheid: op de Axis-pagina zie ik diverse producten zoals een domecamera of een intercom. Ik weet zeker dat daar het bekende CE-logo op zit. Vanaf het moment dat de AI Act van kracht is, gaat dat logo óók betekenen dat het product aan die wet voldoet.

Arnoud

Kan ik een datalekkend bedrijf laten vervolgen wegens doxing?

Een lezer vroeg me:

Een bedrijf lekt mijn persoonlijke gegevens online. Criminelen gebruiken deze gegevens om mij schade te berokkenen. Is het bedrijf nu te vervolgen voor doxing?
Nee. ‘Doxing’ is in de wet gedefinieerd als het publiceren van persoonsgegevens “met het oogmerk om die ander vrees aan te jagen dan wel aan te laten jagen, ernstige overlast aan te doen dan wel aan te laten doen of hem in de uitoefening van zijn ambt of beroep ernstig te hinderen” (art. 285d Strafrecht).

Het lekken van persoonsgegevens gebeurt normaliter niet met het doel om de klant of relatie bang te maken, overlast te bezorgen of te hinderen in zijn werk. Dat kan natuurlijk best het gevólg zijn van het datalek, maar strafbare doxing is het pas als dat de bedoeling was van de persoon (of bedrijf) die het veroorzaakte.

Mij lijkt logischer dat de crimineel aan te pakken is wegens doxing, omdat deze de gegevens publiceert met schade-oogmerk. Grote kans dat dit een vorm van vrees of overlast is die dit wetsartikel bedoelt. En afhankelijk van de schade zijn er nog meer artikelen denkbaar uit het wetboek van strafrecht, denk aan oplichting of afpersing (chantage).

Arnoud

Ruim 1000 klachten in een jaar over slimme deurbel: ‘Mensen voelen zich bespied’

“Fermax doorbell with camera, Schiebroek, Rotterdam (2020) 01” by Donald Trung Quoc Don (Ch? Hán: ???) licensed under CC BY-SA 4.0

De Autoriteit Persoonsgegevens (AP) maakt zich grote zorgen over het toenemende aantal privacyklachten over slimme deurbellen, las ik bij RTL Nieuws. Het gaat om 200 klachten meer, over een inmiddels totaal van 1,2 miljoen deurbellen met camera in het land. En intrigerend: de meldingen zijn van burgers die dachten dat een particuliere camera zoals een slimme deurbel in de buurt meer filmde dan is toegestaan.

Het bericht haakt natuurlijk mooi in op die recente discussie over politievorderingen van beelden van deurbelcamera’s, waarbij ook al langs kwam dat je niet zomaar de openbare weg mag filmen. Het feit dat de politie impliciet die camera’s goedkeurt ‘irriteert’ de AP.

“Het is niet toegestaan dat de slimme deurbel de openbare ruimten filmt of bezittingen van anderen, legt de woordvoerder van de AP uit”, zo lees ik dan. Dat is mij wat te kort door de bocht, want er kúnnen redenen zijn dat het wel mag, maar als reactie op die vele extra klachten snap ik wel dat je er scherp in gaat.

De vraag is alleen wel wat de toezichthouder doet met die klachten:

“Bij de meeste meldingen kunnen mensen er onderling uitkomen, bijvoorbeeld door de camera anders in te stellen zodat die wel aan de eisen voldoet.” Een andere optie is dat de AP een brief stuurt om de regels nogmaals toe te lichten. In het uiterste geval kunnen mensen naar de rechter stappen.
Ik mis hier de stap dat de AP een boete of bevel geeft voor een illegaal opgehangen camera, want dat “mensen” naar de rechter moeten impliceert dat de AP niet zelf gaat handhaven. En natuurlijk, die “heeft niet de capaciteit om in alle gevallen te handhaven”, maar juist hier denk ik: twee handhavende acties met enige publiciteit zouden best een stevig signaal kunnen geven.

Arnoud


Avast krijgt 16,5 miljoen dollar boete voor verkopen van data aan adverteerders – en méér

text
Photo by Tamanna Rumee on Unsplash

Antivirusbedrijf Avast krijgt in de Verenigde Staten een boete van 16,5 miljoen dollar omdat het jarenlang gebruikersdata verkocht aan adverteerders. Dat meldde Tweakers onlangs. Het gaf wat ophef: op een jaaromzet van een slordige 1 miljard dollar is dat niet echt imposant. Maar er is meer.

De Amerikaanse toezichthouder FTC meldt:

Since at least 2014, Avast has distributed browser extensions that it promoted through promising users enhanced privacy. It claimed, for example, that its products would “block[] annoying tracking cookies that collect data on your browsing activities” and “[p]rotect your privacy by preventing . . . web services from tracking your online activity.” It also stated that any sharing of user information would be in “anonymous and aggregate” form. (…) The complaint details how Avast collected highly detailed browsing data from millions of users and then, through its subsidiary Jumpshot, sold those browsing records to over a hundred clients, including major advertising firms. Avast also released this data in individualized, re-identifiable form, allowing these browsing histories to be traced back to specific people—in direct contravention of what Avast had promised.
De boete is dan wel voor de FTC de hoogste ooit in de categorie privacyschending, maar ik zie wel hoe dit gedrag met meer bestraft zou moeten worden dan enkel een bedrag overmaken.

Gelukkig ís er ook meer, zo blijkt uit het eigenlijke besluit (dank aan Floor T. die het quotte op Tweakers):

  • Prohibition on Selling Browsing Data: Avast will be prohibited from selling or licensing any browsing data from Avast-branded products to third parties for advertising purposes;
  • Obtain Affirmative Express Consent: The company must obtain affirmative express consent from consumers before selling or licensing browsing data from non-Avast products to third parties for advertising purposes;
  • Data and Model Deletion: Avast must delete the web browsing information transferred to Jumpshot and any products or algorithms Jumpshot derived from that data;
  • Notify Consumers: Avast will be required to inform consumers whose browsing information was sold to third parties without their consent about the FTC’s actions against the company; and
  • Implement Privacy Program: Avast will be required to implement a comprehensive privacy program that addresses the misconduct highlighted by the FTC.
Ik had het al eerder gezegd, maar zo’n bevel om data te wissen én om dat bij je klanten te gaan effectueren hakt er natuurlijk veel meer in. Dat zouden meer toezichthouders moeten doen.

Arnoud

‘Reddit sluit licentiedeal met AI-gigant voor trainen AI-modellen’, mag dat?

red and white 8 logo
Photo by Brett Jordan on Unsplash

Reddit heeft een licentiedeal gesloten met een ‘groot AI-bedrijf’, ten behoeve van het trainen van AI-modellen. Dat meldde Tweakers vorige week. persagentschap Bloomberg. Het zou gaan om Google, waar Reddit in 2023 nog tegen dreigde de crawlers van te blokkeren. Diverse redditors vonden dit heel vervelend nieuws. Dus vandaar de vraag: mag Reddit dat doen?

Tweakers vult aan:

De licentiedeal zou betekenen dat de inhoud van de door gebruikers gegenereerde inhoud op Reddit zal worden gebruikt om de AI-modellen van een niet nader genoemd bedrijf te trainen, meldt Bloomberg op basis van ingewijden. Het zou gaan om een overeenkomst ter waarde van omgerekend ruim 55,5 miljoen euro op jaarbasis.
De honger naar kwalitatieve content om generatieve AI mee te trainen is enorm. Reddit is een van de grootste social news aggregatoren, waar mensen commentaar geven op nieuws en andere links die men met elkaar deelt (“read it”). De discussie is vaak van goede kwaliteit, en er is ook veel context om inhoud te duiden – reacties krijgen up- en downvotes en onderwerpen worden in zogeheten subreddits op onderwerp verdeeld. Dankbaar voer om AI mee te trainen.

De Reddit Terms of Use zijn afgelopen september aangepast. De site hanteert daarbij de gebruikelijke mooi klinkende constructie van “je blijft eigenaar maar wij krijgen een beperkte licentie”. Of nou ja, ‘beperkt’:

a worldwide, royalty-free, perpetual, irrevocable, non-exclusive, transferable, and sublicensable license to use, copy, modify, adapt, prepare derivative works of, distribute, store, perform, and display Your Content and any name, username, voice, or likeness provided in connection with Your Content in all media formats and channels now known or later developed anywhere in the world. This license includes the right for us to make Your Content available for syndication, broadcast, distribution, or publication by other companies, organizations, or individuals who partner with Reddit.
In gewoon Nederlands staat hier dat Reddit alles mag doen dat ze willen, inclusief als dataset verkopen aan andere bedrijven. En vanwege dat ‘irrevocable’ kun je die licentie dus ook niet meer snel intrekken. Je kunt natuurlijk je account opheffen, maar de licentie blijft gegeven.

In Europa kun je via de AVG eisen dat je persoonsgegevens niet langer verwerkt worden. Weghalen van je account of je naam bij publicaties is dus zeker mogelijk. Verdedigbaar is dat je posts ook persoonsgegevens kunnen zijn, afhankelijk van de inhoud. Over weghalen daarvan zegt de privacy policy:

Please note, however, that the posts, comments, and messages you submitted prior to deleting your account will still be visible to others unless you first delete the specific content. After you submit a request to delete your account, it may take up to 90 days for our purge script to complete deletion. We may also retain certain information about you for legitimate business purposes and/or if we believe doing so is in accordance with, or as required by, any applicable law.
Ik lees dat “we may retain certain information for legitimate purposes” dus als een recht om tóch je berichten te blijven gebruiken, zij het zonder je naam erbij. In de context van verhandelen voor het trainen van AI is dat een logische verwachting. Het lijkt me ook AVG-compliant, omdat een bericht zonder naam zeker niet perse een persoonsgegeven is.

Arnoud

Chatbot zat fout: Air Canada moet reiziger compenseren

ai-generated, monster, robot
Photo by AlexandraKoch on Pixabay

De Canadese luchtvaartmaatschappij Air Canada moet een passagier zijn geld terugbetalen nadat een chatbot hem verkeerd had geïnformeerd. Dat meldde RTL Nieuws vorige week. Het opmerkelijke verweer op de klacht was dat de chatbot een ‘aparte juridische entiteit’ zou zijn, ‘verantwoordelijk voor zijn eigen acties’. Wacht, wat?

De kern was een klacht over het willen gebruiken van het ‘rouwtarief’, een bereavement flight. Dit concept komt erop neer dat je voor een vlucht naar een uitvaart een goedkoper lastminute ticket kunt krijgen. Het bestaat nauwelijks meer,  maar Air Canada had dat in 2022 nog wel:

In November 2022, following the death of their grandmother, Jake Moffatt booked a flight with Air Canada. While researching flights, Mr. Moffat used a chatbot on Air Canada’s website. The chatbot suggested Mr. Moffatt could apply for bereavement fares retroactively. Mr. Moffatt later learned from Air Canada employees that Air Canada did not permit retroactive applications.
Het probleem was dus dat de chatbot zei dat je dat rouwtarief met terugwerkende kracht kon claimen op een al geboekt ticket. In die uitspraak zat een link naar de “Bereavement policy” van Air Canada, waar dan weer in staat dat je alleen recht hebt op dat tarief als je er vooraf om vraagt.

Zowel in Nederland als in Canada is het zo dat als een medewerker van een bedrijf een duidelijke toezegging doet, je daar als klant in principe op mag vertrouwen. Uitzonderingen kunnen altijd, met name als jij moet weten dat die medewerker zoiets niet mag toezeggen.

Air Canada gooide het over een iets andere boeg:

Air Canada argues it cannot be held liable for information provided by one of its agents, servants, or representatives – including a chatbot. It does not explain why it believes that is the case. In effect, Air Canada suggests the chatbot is a separate legal entity that is responsible for its own actions. This is a remarkable submission. While a chatbot has an interactive component, it is still just a part of Air Canada’s website. It should be obvious to Air Canada that it is responsible for all the information on its website. It makes no difference whether the information comes from a static page or a chatbot.
De uitspraak gaat hier wat snel van “cannot be held liable” naar “is a separate legal entity”, maar de kern is duidelijk: Air Canada vond dat zij niet gehouden kon worden aan de toezegging van de chatbot. Je had de ‘echte’ bron maar moeten controleren.

Het tribunaal gaat daar niet in mee. Hoe zou een consument moeten weten dat de ene informatiebron betrouwbaarder is dan de andere? Air Canada zet ze beiden op haar site, dus moet ze de gevolgen daarvan dragen. Je kunt niet verwachten dat mensen alles dubbelchecken. Ook een beroep op de algemene voorwaarden bij het ticket wordt afgewezen, hoewel met het argument dat Air Canada die voorwaarden niet had overlegd in de procedure.

Ik lees de uitspraak dus niet als een discussie over het “aparte juridische entiteit” zijn van de chatbot. Waar het om gaat, is waar de consument staat als bron A zegt dat iets wel mag en bron B dat dat niet mag. Dan geldt dus wat de bron zegt waar de consument op afgegaan is, omdat je bij een duidelijke toezegging deze niet hoeft te dubbelchecken. Het roept de filosofische vraag op of de klager recht zou hebben op een gedeeltelijke teruggaaf als hij achteraf de chatbot had geraadpleegd, na eerst een duur ticket te hebben gekocht omdat de Bereavement Policy dat zei.

De rechter benoemt nadrukkelijk dat hij geen verschil ziet tussen een statische webpagina en een chatbot. Ik zie dat zelf anders: de indruk die je wekt met een chatbot is ergens toch serieuzer, specifieker. Een webpagina zegt hoe het in het algemeen is. Een chatbot helpt jou met jouw probleem, je hebt jouw specifieke feiten genoemd en je vraagt een advies over jouw situatie. Dan komt daar iets uit dat voor jou opgaat, en dat zou best anders kunnen zijn dan de algemene regel.

Ik ben een beetje bezorgd dat uitspraken als deze ertoe gaan leiden dat chatbots ieder gesprek openen met een disclaimer dat je alles moet dubbelchecken dat ze zeggen, en dat ze geen bindende toezeggingen kunnen doen.

Arnoud


Mag mijn werkgever me dwingen mijn BYOD te voorzien van Microsoftsoftware?

“my workstations – windows laptop” by anotherjesse is licensed under CC BY-NC-SA 2.0

Een lezer vroeg me:

Mijn werkgever wil het BYOD beleid voor onze organisatie zodanig aanpassen, dat er alleen nog met laptops gewerkt kan worden, die volledig op Microsoft producten draaien. (Windows 11, Office365, enz). Ik heb gewetensbezwaren tegen het gebruik van software van Big Tech bedrijven en werk al 25 jaar zonder problemen met open source. Hoe sterk sta ik als ik bezwaar wil maken tegen deze beleidswijziging?
Ik moet nu even cru zijn: nee. De werkgever kiest de gereedschappen en bepaalt hoe het werk gebeurt. Gewetensbezwaren brengen vrijwel altijd met zich mee dat je ontslag moet nemen. Van je werkgever eisen dat die het werk anders inricht vanwege jouw gewetensbezwaren kan enkel heel soms bij een kernaspect van een religieuze overtuiging en alleen als er een reëel alternatief is.

Hier gaat het om bring-your-own-device beleid, waarbij werknemers de eigen laptop met eigen software mogen inzetten voor werkzaken. Dat kan, en in zo’n vrije setting is het dan helemaal prima dat jij dat met een laptop met FreeBSD en LibreOffice doet in plaats van Windows 11 en Office 365.

Maar ook als dit al enige jaren het beleid is, blijft de werkgever gerechtigd van gedachten te veranderen en over te willen stappen naar een meer gecontroleerde omgeving. Goed werkgeverschap vereist dat hij hier wel enige vooraankondiging en overgangstijd voor laat, dus niet op vrijdag 13:00 aankondigen dat iedereen maandag op Windows 11 moet zitten of dat om 9:00 de IT-afdeling langskomt met een installatie-CD.

Daar staat tegenover dat een werknemer niet verplicht kan worden de eigen laptop mee naar het werk te nemen. BYOD in deze vorm is een keuze, en die keuze impliceert niet dat je dat device voor altijd moet blijven gebruiken. Je kunt dus als werknemer met gewetensbezwaren de BYOD regeling opzeggen en een laptop van de werkgever verlangen. Wel zal daar dan natuurlijk Windows 11 en Office 365 op staan.

Arnoud Dit is een update van een vraag in de comments van een blog uit 2017. Ik ben sinds de discussie daar van gedachten veranderd.

Alweer controle bij de zelfscankassa? Mogelijk vindt AI je gedrag verdacht

“Cashierless supermarket self-checkout” by CoCreatr is licensed under CC BY-SA 2.0

“Er komt meer cameratoezicht in alle winkels en er komen meer en slimmere steekproeven bij zelfscankassa’s”, las ik bij PrivacyNieuws. Men citeert supermarktketen Jumbo, dat AI-technologie wil gaan inzetten voor gerichte steekproeven bij de zelfscankassa. Hoe zinnig is dat?

Vrijwel alle supermarkten hebben zelfscankassa’s. Dat scheelt immers een hoop geld aan salarissen voor cassières (m/v/x), maar je krijgt er wel meer winkeldiefstal voor terug. Daar moet technologie dan een oplossing voor bieden, en het breed gedragen gevoel is dan dat een steekproef gebaseerd op willekeur niet goed genoeg werkt. Daarom de greep naar AI.

Het lijkt erop dat men niet gaat controleren op kenmerken van de persoon, maar op gedrag:

Retaildeskundige Eelco Hos legde begin dit jaar in het Brabants Dagblad uit hoe dit soort AI-controlesystemen eruit kunnen zien. Camera’s zouden kunnen checken wat de klant koopt en scant. Als een product dan niet wordt gescand, vraagt het zelfscanapparaat de klant om dat alsnog te doen. Een andere mogelijkheid is dat een medewerker door de computer wordt gewaarschuwd als iemand niet alles afrekent. Een camera bij de kassa maakt dan een foto van de winkelmand aan de kassa.
Deze aanpak heeft in ieder geval niet het nadeel dat men gaat proberen een AI te leren hoe “een gemiddelde winkeldief” eruit ziet – een fundamenteel onjuiste aanpak. Het leidt natuurlijk wel tot een enorme berg aan extra camera’s, en het trainen van een model dat scant wat iemand uit het rek pakt is ook niet triviaal (denk aan terugleggen of 2 stuks pakken, of een donkere verpakking in de hand van een persoon van kleur).

De geciteerde zorg van Bits of Freedom is inderdaad niet onterecht:  “Je hoeft maar een verkeerde beweging te maken en je kunt onterecht als verdacht worden aangemerkt.” Als de camera niet helemaal goed ziet welk product je pakt, dan zal de kassa een discrepantie zien tussen jouw mandje en de werkelijkheid in het systeem, en dat pakt altijd in het nadeel van de klant uit. De Jumbo heeft hier nog geen nadere uitleg over gegeven.

Arnoud PS: Lezen hoe het wel moet? Mijn boek AI and Algorithms gaat in detail in op de juridische en ethische randvoorwaarden van inzet van AI.

Thuisadressen getuigen vindbaar via online vonnissen, hoe erg is dat?

De adressen van burgers die camerabeelden delen met de politie zijn in sommige gevallen te herleiden uit online gepubliceerde vonnissen, blijkt uit onderzoek van BNR. Wie vonnissen goed leest met Maps erbij, kan zo vaststellen waar de camera’s hangen waar beelden van zijn gebruikt door justitie in ernstige strafzaken. De Raad voor de Rechtspraak laat in een reactie weten dat ze het probleem herkent.

Het onderzoek is een vervolg op waar ik in januari over blogde: De politie vordert vaak beelden van deurbelcamera’s waardoor adressen van nietsvermoedende burgers in strafdossiers terecht kunnen komen. Dat vorderen moet juridisch gezien, want anders mag de politie de beelden niet meenemen (vrijwillig ongevraagd ze krijgen van een burger daargelaten).

Letterlijke adressen (“op de camerabeelden van de camera aangebracht op het pand te Jollemanhof 12 Amsterdam”) worden netjes geanonimiseerd. Maar dat is niet genoeg: vaak wordt de context geschetst om de beelden te duiden, en wie dan een beetje handig is met Maps, kan dan alsnog de originele plek terugvinden:

De positie van de camera, het merk van de deurbel, de namen van aangrenzende straten: allen komen uitgebreid aan bod. [Getuige] Clara’s naam en adres zijn digitaal ‘weggelakt’, maar er staan zoveel details in de uitspraak, dat aan de hand van een kaart te achterhalen is waar de deurbelcamera ongeveer gehangen moet hebben. Foto’s op Google Streetview laten zien dat alleen bij Clara een deurbel van het genoemde merk hing ten tijde van de moord.
Waar ik dan mee blijf zitten: hoe ernstig is dit nu werkelijk, qua inbreuk op de persoonlijke levenssfeer? Het gaat hier niet om beschrijvingen van interieurs of persoonlijke aangelegenheden, maar een beschrijving van de locatie en wat er op die camera te zien was op de openbare weg. Die beelden hebben dan verder niets met de camera-eigenaar te maken, die was toevallig de getuige en dat was het.

Arnoud