Persoonsgegevens zijn dat alleen als je zelf de personen kunt identificeren

Photo by Claudio Schwarz on Unsplash

Wanneer is een gegeven een persoonsgegeven? Maakt het daarbij uit dat je een ander nodig hebt om de identificatie rond te krijgen? Deze vragen leiden al jaren in de AVG-wereld tot felle discussies. Maar nu heeft het Hof van Justitie in het SRB-arrest de knoop doorgehakt; de ‘relativisten’ hebben gewonnen.

De achtergrond van het arrest is simpel genoeg. In 2017 werd de Spaanse Banco Popular Español overgenomen, wat goedkeuring van de Europese Commissie vergde. Na de afwikkeling werd audit- en advieskantoor Deloitte gevraagd om een onderzoek te doen, waarbij ze geanonimiseerde opmerkingen en zienswijzes van betrokkenen kreeg.

Of nou ja, geanonimiseerd: de namen en zo waren vervangen door alfanumerieke codes. Pseudonimiseren, noemt de AVG dat. Voor Deloitte onmogelijk te herleiden, tenzij de  verstrekkende partij (de Gemeenschappelijke Afwikkelingsraad, GAR) mee zou werken. En dat maakt uit, want een aantal mensen was geërgerd door deze verstrekking omdat de GAR niet had gezegd dat dit zou gebeuren.

Persoonsgegevens delen zonder informatie is niet toegestaan onder de AVG (hier dan verordening 2018/1725, de “AVG voor Europese instellingen”). Vandaar dat de vraag ontstond: zíjn het eigenlijk wel persoonsgegevens, die lijsten met codes die aan Deloitte waren verstrekt.

Enerzijds: ja, want je kunt ze terug herleiden als je de medewerking van de GAR krijgt. En sinds het Breyer-arrest weten we dat het daarvoor genoeg is dat je “wettige middelen” hebt die met een redelijke inspanning leiden tot de personen. Je kunt de NAW-gegevens achter een IP-adres bij de rechter opeisen, dus IP-adressen zijn persoonsgegevens.

Anderzijds: zijn ze dan altijd persoonsgegevens, of alleen voor de mensen die in staat zijn die herleiding te doen? Het is raar dat voor mij 192.168.3.41 een persoonsgegeven is, omdat stichting BREIN bij de rechter de NAW-gegevens kan opvragen zeg maar.

Het Hof brengt dan ook een belangrijke nuancering aan. Als jij zelf niet in staat bent de pseudonimisering ongedaan te maken, dan zijn de gegevens voor jou geen persoonsgegevens:

Dit veronderstelt echter ten eerste dat Deloitte bij iedere onder haar toezicht verrichte verwerking van [de zienswijzes en opmerkingen van de klanten] geen mogelijkheid heeft om deze maatregelen ongedaan te maken. Ten tweede moeten die maatregelen daadwerkelijk van dien aard zijn dat zij Deloitte ook beletten om diezelfde opmerkingen te koppelen aan de betrokken persoon door gebruik te maken van andere identificatiemiddelen, zoals een vergelijking met andere elementen, zodat de betrokkene voor deze vennootschap niet of niet meer identificeerbaar is.
Bij jou ligt dan dus wel de bal om aan te tonen dat je die herleiding niet kunt doen. Ja, dat is een omgekeerde bewijslast, maar omdat de hoofdregel toch al was dat het persoonsgegevens zijn is dat hier wel redelijk.

Het is dus een opsteker voor informatiebeveiliging en efficiënt werken: als je persoonsgegevens goed ontdoet van herleidbare informatie, dan kun je een ander er mee laten werken zonder dat die de hele AVG-rambam over zich heen krijgt. En omdat de bewijslast ligt bij de partij die meent dat de gegevens niet (meer) herleidbaar zijn, is het risico daarmee goed te managen.

Arnoud
Google hoeft Chrome niet te verkopen na megarechtszaak over online monopolie

Hoewel Google een verboden monopoliepositie in de zoekmarkt heeft, hoeft het bedrijf haar browser Chrome niet te verkopen. Wel moet men informatie delen met concurrenten en zijn exclusieve deals niet meer toegestaan. De uitspraak is het voorlopig hoogtepunt in een langlopend geschil tussen de Amerikaanse overheid en het bedrijf.

De Amerikaanse antimonopoliewetgeving (de Sherman Act) is streng, maar procedures duren lang. En dat is met name in de ict een enorm probleem. Zo duurde de zaak tegen Microsoft over integreren van Internet Explorer in Windows zó lang dat concurrent Netscape al lang uit de markt was toen de uitspraak kwam.

Deze zaak werd gestart in 2020. De kern: Google probeert andere zoekmachines buiten te sluiten door exclusieve deals rond Android te maken met telefoonmakers en met Apple in het bijzonder (Google als default in Safari). De aanklacht stelt dat Google hiermee 70% van de zoekmachineadvertentiemarkt in handen kreeg en adverteerders zo kunstmatig hoge prijzen kan rekenen.

Nadat de rechtbank in 2024 oordeelde dat Google inderdaad een monopolie had geprobeerd te verwerven, ging de procedure verder met de vraag hoe dit op te lossen. Ontbundelen van Chrome werd vaak genoemd als remedie, want zo zouden anderen de populaire browser kunnen leveren maar dan preconfigured met andere zoekmachines. Ook Android zou uitgesponnen moeten worden naar een apart bedrijf, met ontkoppeling van alle daarin opgenomen Google-diensten.

Die eisen werden afgewezen om twee redenen. Allereerst was niet duidelijk dat juist deze defaults een belangrijke rol hadden gespeeld in het verkrijgen van het monopolie. Maar ten tweede is onduidelijk hoe ontbundelen bijdraagt aan een oplossing, terwijl de kans groot is dat de producten dan ten onder gaan:

“It would be incredibly messy and highly risky.” [judge Mehta wrote.] That’s because it doesn’t run as a “standalone business” and relies greatly on Google’s own infrastructure, he wrote. Even if another owner tried to take it over, he wrote, “the court is highly skeptical that a Chrome divestiture would not come at the expense of substantial product degradation and a loss of consumer welfare.”
Het betalen van vergoedingen aan anderen voor het configureren van Google als default zoekmachine mag ook: veel organisaties (hoi Firefox) zijn sterk afhankelijk van die vergoedingen, en zouden mogelijk uit de markt verdwijnen als Google dit niet meer mocht doen.

Wél wordt Google verplicht om specifieke zoekdata en informatie over relevante webpagina’s te verstrekken, zodat concurrenten hun producten beter kunnen afstemmen. Inderdaad, verplicht de concurrent wijzer maken, maar dan had je die maar niet moeten wegpesten uit de markt.

Uiteraard wordt hoger beroep ingesteld. En de zoekmarkt is ten opzichte van 2020 alweer fors veranderd, met gigantische groei van chatbots-die-zoeken als vervanging van de “tien blauwe linkjes” waar je het van -inderdaad- Google mee moest doen.

Arnoud


Hebben we hier de eerste Nederlandse advocaat met ChatGPT-ECLI’s?

Bron: Emanuel Peire, Medium

“Tijdens de mondelinge behandeling is vastgesteld dat alle verwijzingen in de conclusie van antwoord naar uitspraken van de Hoge Raad onjuist zijn.” Voor het eerst dat ik dat lees in een Nederlands vonnis, en zoals de rechtbank dan zegt roept het vele vragen op.

Het vonnis betreft een handelsnaaminbreuk, en de verwijzingenkwestie komt pas als laatste terzijde aan de orde, want de zaak kon ook zonder gewoon worden opgelost. Maar toch, ik zou knap balen als dit over mijn conclusie van antwoord werd gezegd:

In de conclusie van antwoord heeft [de gedaagde partij] verwezen naar (vermeende) uitspraken van de Hoge Raad ten aanzien van het handelsnaamrecht, met vermelding van een (vermeend) ECLI-nummer. Geen enkele van de aangehaalde (vermeende) arresten heeft betrekking op het handelsnaamrecht. Sommige ECLI-nummers horen bij strafrechtelijke uitspraken, andere bestaan in het geheel niet.
Ik denk dan meteen “ah, ChatGPT gebruikt”. Want die tool – en zijn vriendjes Claude en Copilot – heeft er een handje van de mooiste uitspraken op te lepelen die precies het betoog ondersteunen.

Mét een ECLI, want dat hoort er bij. Maar of die ook feitelijk bestaan en ondersteunen wat er wordt gezegd, dat is een heel ander verhaal. Het is meer Keyzer en de Boer: het klínkt goed, maar voor de feiten moet je elders wezen.

De rechtbank trekt geen conclusie, want je kunt immers niet zeker weten of iemand zo’n tool gebruikt tenzij die dat erkent. De verklaring hier doet voor mij als ict-er wat ongemakkelijk aan:

Desgevraagd heeft (de advocaat van) [de gedaagde partij] verklaard dat dit alles is veroorzaakt door een probleem bij het converteren van een word-bestand naar pdf. Deze verklaring roept vragen op.
Nou weet ik dat pdf-bestanden rare ondingen zijn, maar dat ze ECLI-nummers verbouwen heb ik nog niet gezien. Links die wegvallen, tekst die niet meer selecteerbaar is, tekst die na het plakken Unicode-prut wordt – zeker. Maar dit? Ik geloof het gewoon niet.

Arnoud


Man filmde stiekem vrouwen bij toiletten op festival Rotterdam met bril, beveiliger waarschuwt

Beeld: RTL Nieuws

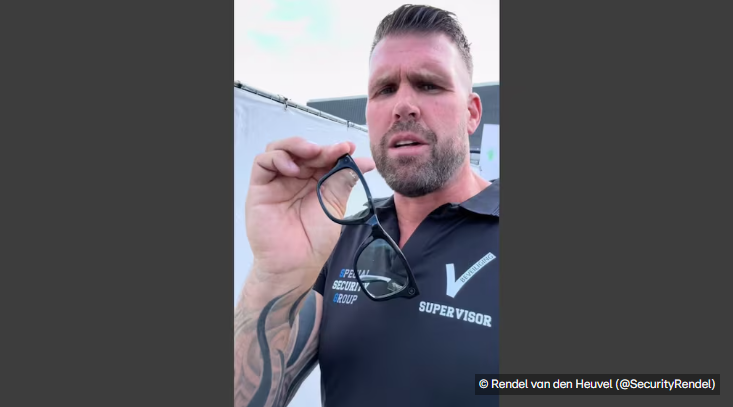
Bij een festival in Rotterdam is dit weekend een man betrapt op het stiekem filmen van vrouwen bij de toiletten met een camerabril. Dat meldde RTL Nieuws onlangs. Dit is ict-nieuws want hij deed dat met zo’n Ray-Ban Meta bril-met-camera. Maar ik snap de ophef wel.

Het artikel legt uit:

“Meerdere dames kwamen naar ons toe met de melding dat er een man rondliep bij de vrouwen-wc’s die verdacht rondkeek en zich ook richtte op schaars geklede dames”, vertelt Van den Heuvel aan RTL Nieuws. Daarop hebben ze de man apart genomen en gefouilleerd. “We vonden aanvankelijk alleen drugs in zijn zakken. Maar toen we eens goed keken naar zijn hoofd, dachten we opeens: wat heeft hij nou eigenlijk voor bril op?”
Dat was dus een Ray-Ban® Meta (“a new collection of AI glasses”), die officieel niet in Europa wordt verkocht. De dingen hebben dus camera’s die kunnen fotograferen en video’s maken (maximaal 3 minuten en het vreet batterij, dat wel). Ook zitten er microfoons in, onder meer zodat je met Meta’s AI kunt praten.

Waarom het ding niet in Europa op de markt is, weet ik niet. Een specifieke regel die een bril-met-microfoon-en-camera verbiedt, ken ik namelijk niet. En hoewel ik meteen zie hoe je hier AVG-schendend door het leven mee kunt, betekent dat niet dat verkoop van het apparaat ook een AVG schending zou zijn. Die wet regelt namelijk niets over apparatuur om persoonsgegevens mee te verwerken.

Wat is dan wél strafbaar?

  1. Een gesprek afluisteren waar je geen deelnemer aan bent (art. 139a en 139b Strafrecht), bijvoorbeeld door er naast te zitten en de microfoons het op te laten nemen.
  2. Afbeeldingen van personen (foto én video dus) maken in een besloten ruimte zoals een woning, zonder dat je dat duidelijk kenbaar maakt (art. 139f Strafrecht). (Niet verboden indien in de openbare ruimte want die bril is niet aangebracht op een specifieke plek, 441b Strafrecht).
  3. Zonder toestemming van de geportretteerde een “visuele weergave van seksuele aard” vervaardigen (art. 254ba lid 1(a) Strafrecht).
Afgaande op het nieuwsbericht is hier dus sprake van punt 4, want:
“Op zijn telefoon bleken meerdere video’s te staan waarop te zien was dat hij inderdaad rondkeek op de damestoiletten. Ook was er een beeld waarop hij op zijn knieën zat, en onder een rokje filmde. Obscure [obscene? AE] beelden, die we meteen verwijderd hebben.”
Voor Ray-Ban of Meta is dit niet direct relevant. Zij maken niet dergelijke opnames of beelden. Dat het kán, is niet van belang. Althans niet direct, want reclame maken voor de geschiktheid van dit soort producten voor heimelijk afluisteren of filmen is wél apart strafbaar (art. 441a Strafrecht).

Arnoud

EU-Hof gaat niet mee met privacyzorgen over datadoorgifteverdrag met VS

Photo by Andrey Masiero on Unsplash

Het Gerecht van het Europese Hof van Justitie houdt het EU-US Data Privacy Framework in stand, las ik bij Tweakers. De poging van Europarlementariër Philippe Latombe om het DPF ongeldig te laten verklaren lijkt daarmee gestrand, zij het dat een beroep naar het Hof van Justitie nog mogelijk is. Velen verwachtten een andere uitspraak.

Het zogeheten DPF is de opvolger van het Privacy Shield uit 2016, dat weer een poging was om het ontplofte Safe Harbor op te kalefateren. Alle drie hebben ze hetzelfde doel: te zorgen dat persoonsgegevens uit Europa naar de VS mogen onder de AVG.

De kern is dat de AVG alleen zulke ‘doorgifte’ toestaat als het andere land min of meer gelijkwaardige bescherming van persoonsgegevens kent. Zwitserland heeft bijvoorbeeld een databeschermingswet die sterk overeenkomt, en is daarom adequaat verklaard. De VS heeft géén (federale) gegevensbeschermingswet, maar omdat iedereen en z’n moeder afhankelijk is van Amerikaanse ict- en datadiensten, moest en zou er wat voor komen.

Zowel Privacy Shield als Safe Harbor sneuvelden in essentie omdat Amerikaanse veiligheidsdiensten zonder waarborgen mochten snuffelen in data van Europeanen als die in de VS stond. Het DPF heeft een aantal extra procedurele waarborgen, zoals een aparte toezichthouder, de Civil Liberties Protection Office (CLPO).

Een discussiepunt was dus meteen hoe onafhankelijk die is, iets waar het Gerecht nu van zegt dat dit ten tijde van de DPF adoptiedatum op papier goed geregeld was:

Zoals blijkt uit overweging 180 van het bestreden besluit, is het de inlichtingendiensten en de directeur van de nationale inlichtingendienst daarentegen verboden de werkzaamheden van de CLPO te belemmeren of op onrechtmatige wijze te beïnvloeden. De CLPO moet bij het onderzoek van de klacht met betrekking tot persoonsgegevens de wet onpartijdig toepassen en daarbij rekening houden met zowel de nationale veiligheidsbelangen als de bescherming van de persoonlijke levenssfeer.
De CLPO voldoet dus aan de gestelde eis dat er onafhankelijk toezicht is op hoe de inlichtingen- en veiligheidsdiensten werken met persoonsgegevens van Europeanen.

Een tweede punt was massasurveillance door diezelfde diensten. Ook dat was keurig geregeld in het DPF, onder meer omdat bulk surveillance in principe wettelijk verboden is. En daarmee zijn alle grieven van Latombe afgekaart.

U denkt nu misschien, wat een super formele opstelling. We weten toch allemaal hoe de praktijk tegenwoordig is? Maar het Gerecht kan en mag niet oordelen of het DPF op dit moment de situatie adequaat afdekt. Haar taak was toetsen of de Europese Commissie destijds het DPF had mogen aannemen gezien de wettelijke, formele situatie van toen in de VS.

Natuurlijk, die formele situatie had met de werkelijkheid weinig van doen. En zeker anno 2025 is er wel héél veel veranderd sinds Biden zijn handtekening zetten onder die executive order. Maar dat is een taak van de Commissie, niet de rechter: de Commissie moet toetsen of de VS zich nog steeds houdt aan de afgesproken regels. Dit is dus wezenlijk anders dan bij Privacy Shield, waar de afgesproken regels zelf te weinig bescherming boden voor de grondrechten van Europese burgers.

Arnoud


Moet een gehackte site wettelijk gezien alle wachtwoorden resetten?

Photo by Jose Antonio Gallego Vázquez on Pexels

Een lezer vroeg me:

Het valt me op dat organisaties bij accounthacks zeer verschillend handelen. Bij sommige websites werd mijn wachtwoord proactief door de betreffende website gereset, maar bij andere getroffen sites kreeg ik alleen het advies dit te doen. Het werd niet afgedwongen. Zijn hier wettelijke richtlijnen over?
Er zijn geen specifieke regels over hoe een organisatie de gevolgen van een securitybreach of datalek moet oplossen. Algemeen moeten de betrokkenen worden geïnformeerd en de gevolgen gecompenseerd. Daarnaast moet je maatregelen nemen om te zorgen dat het niet nog een keer gebeurt. Maar welke dat zijn, hangt vrijwel volledig af van je situatie.

Het resetten van wachtwoorden is een eenvoudige maatregel wanneer gebleken is dat een derde toegang tot accounts heeft gekregen. De eigenaar wordt zo gedwongen een nieuw wachtwoord in te stellen, zodat de derde er niet meer bij kan. Dit lijkt me algemeen dus een prima maatregel.

Moet het? Allereerst is het goed mogelijk (zeker bij kleine organisaties) dat dit niet eenvoudig kan. Niet alle webshopsoftware of beheertools hebben een knop “reset dit account”. En dan kun je weinig anders dan de klant vragen het te doen. Ten tweede, als de wachtwoorden zelf niet gelekt zijn (de hacker kwam binnen via een achterdeur of beheerdersaccount) dan is er geen dwingende reden om dan ook maar de wachtwoorden te resetten.

Arnoud


Mag je je gekochte auto hacken om abonnementsfeatures aan te zetten?

Photo by jdblack on Pixabay

Een leezr vroeg me:

Vorige week werd bekend dat Volkswagen het vermogen van haar auto’s kunstmatig gaat begrenzen, waarna je op abonnementsbasis het extra deel kunt activeren. Dit kennen we ook van BMW en er zijn er vast meer. Nu ben ik redelijk handig met auto’s, dus ik denk dan gelijk “ik duik de motorkap in en stel dat vermogen zelf wel omhoog”. Maar is dat legaal?
Als je een product in eigendom verwerft, dan mag je daarmee in principe doen wat je wil. Dus ja, je mag onder de motorkap gaan aanpassen als je denkt daar verstand van te hebben. Uiteraard moet het resultaat nog steeds voldoen aan de eisen van de wegenverkeerswet (dus geen schetenclaxon installeren).

Gezien de stand van de techniek in autoland vermoed ik echter dat het hier niet gaat om krachtiger brandstofinjectoren of een nieuwe restrictorplaat er in zetten. Waarschijnlijk is de boordcomputer geprogrammeerd om geen volledig vermogen te realiseren, tenzij het vlaggetje b_hasSubscription op true staat.

Het aanpassen van software is juridisch ingewikkeld, ook als het in een product zit dat jouw eigendom is. Eigendomsoverdracht staat namelijk los van het auteursrecht op die software; dat laatste gaat niet mee bij de koop. Je zit daarmee vast aan de licentie die je hebt gekregen, en daar staat simpelweg nooit in dat je de software mag aanpassen.

Het deed me denken aan waarom wanhopige tractoreigenaren illegale firmware downloaden: omdat ze daarmee wél hun tractoren kunnen tunen. De standaard firmware vereist dat je een geautoriseerd dealer belt, en dat levert kosten en tijdverlies op dat je bij het oogsten echt niet erbij kunt hebben.

In 2024 werd de Recht op Reparatie-richtlijn aangenomen. Dit regelt “de reparatie van door consumenten gekochte goederen in geval van een gebrek” buiten de garantie, zoals bij slijtage. Je kunt straks (2026) eisen dat de fabrikant het product herstelt, zij het tegen een passende vergoeding. Maar “reparatie” is beperkt gedefinieerd:

“reparatie”: een of meer handelingen waarbij een gebrekkig product of afval wordt teruggebracht in een staat waarin het geschikt is voor het beoogde gebruik ervan;
En als je een auto koopt met een beperkt vermogen, dan is dat geen gebrek maar gewoon het vermogen dat de auto kan leveren. Dat deze met tunen tot méér in staat is, maakt niet dat het vermogen nu gebrekkig is. Zolang maar duidelijk is geadverteerd wat het vermogen is.

Er zijn nog veel, veel meer Europese regels in aantocht (lees erover in mijn boek Wetwijs), maar geen van deze verbieden het verhuren van features. En het verbod op firmware aanpassen blijft gewoon bestaan.

Arnoud

Verplicht inloggen met DigiD bij het online indienen van een Woo-verzoek is verboden.

Bron: Logius

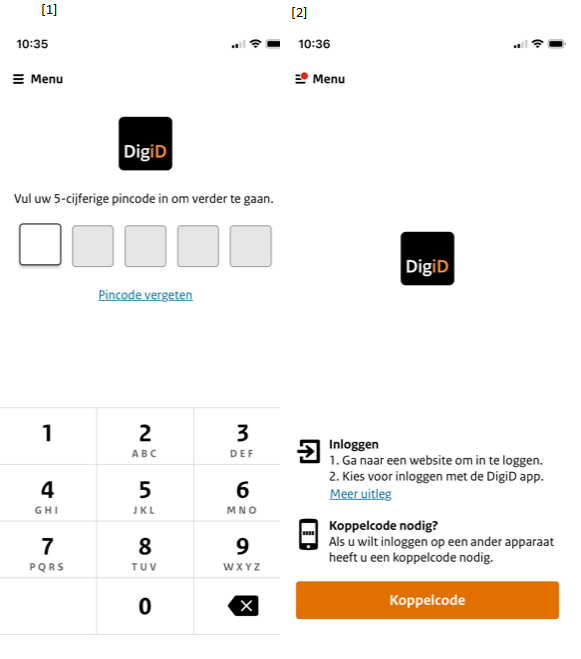
SPOON heeft gelijk gekregen van de rechtbank Gelderland, juichte het Wet open overheid-expertisecentrum onlangs: het verplicht inloggen met DigiD en verplichte ‘voorvragen’ bij het online indienen van een Woo-verzoek, is verboden. De rechtbank Gelderland oordeelde met zo veel woorden dat dergelijke verzoeken ‘vormvrij’ zijn.

Op grond van de Wet open overheid (Woo, voorheen Wet openbaarheid van bestuur) mogen burgers informatie opvragen bij gemeentes en andere overheidsorganen. Dit gebeurt veelvuldig, en bij niet tijdig antwoorden kun je als orgaan dwangsommen verbeuren jegens de burger.

Het is dan ook vrij logisch dat bestuursorganen vaste kanalen en procedures instellen om verzoeken snel en overzichtelijk in behandeling te nemen. Zo ook Apeldoorn, waar het verzoek uit deze uitspraak binnenkwam. Die gemeente heeft daar een keurig online formulier voor, dat met enkele voorvragen checkt of je wel goed zit en je dan alles laat invullen.

Wie de voorvragen doorloopt, kan dan kiezen: DigiD, EID (Europa) of “zelf contactgegevens invullen”. En die laatste ontbrak dus. De betrokken burger had het verzoek dan ook via e-mail ingediend, omdat hij niet via DigiD wilde inloggen bij het verzoek. Ook had hij bezwaar tegen de verplichte voorvragen.

Kennelijk had de gemeente ook wel door dat hier iets niet klopt, want op de zitting gaf men al aan dat DigiD niet meer verplicht is. Uit het vonnis:

Dat is terecht: uit de artikelsgewijze toelichting bij artikel 4.1, tweede lid, van de Woo blijkt uitdrukkelijk dat het niet proportioneel is om bij het opstellen van elektronische informatieverzoeken DigiD voor te schrijven. … Het college heeft laten weten dat het inmiddels niet meer verplicht is om gebruik te maken van DigiD bij het elektronisch indienen van een Woo-verzoek.
Ook het stellen van voorvragen wordt verboden, omdat dat een drempel opwerpt en de wet nu eenmaal stelt dat je “vormvrij” een verzoek moet kunnen indienen.

Voorvragen zijn vragen als “Heeft u de volledige beschrijving op de pagina over het indienen van een woo verzoek gelezen?” en “Wilt u informatie die alleen betrekking heeft op omgevingsvergunningen of een bestemmingsplan?”.

De gemeente stelt dat deze vragen slechts in het belang van de burger zijn. Dit helpt immers filteren: wie niet goed oplet bij een verzoek, kan verkeerde antwoorden krijgen. En informatie over omgevingsvergunningen staat al proactief online, dus hoef je niet naar te vragen. Zeker handig dus om dit te checken, maar je mag mensen niet dwingen door de voorvragen heen te gaan.

Op dit moment zie ik de voorvragen nog steeds, dus dat voelt niet geheel conform het vonnis. Tegelijkertijd zijn deze vragen zó basaal dat ik dit nauwelijks nog een drempel kan noemen.

Bij welke gemeente of andere overheidsinstantie kennen jullie de meeste of moeilijkste hoepels rond documenten opvragen?

Arnoud

Waarom is het niet verboden persoonsgegevens te verzamelen, tenzij?

Photo by Leon Dewiwje on Unsplash

Een lezer vroeg me:

Het valt me op dat zeer veel websites allerlei persoonlijke gegevens van je vragen, ook als daar evident geen noodzaak voor is (zoals geboortedatum of mobiel nummer). Dit is volgens mij een belangrijke oorzaak van schade bij datalekken. Waarom is er geen wet die organisaties verbiedt dit te verzamelen tenzij met aantoonbare en onderbouwde noodzaak?
Zo’n wet is er al: de Algemene verordening gegevensbescherming (AVG) kent een wettelijke eis tot “dataminimalisatie” (artikel 5(1) onder c). Alle persoonsgegevens die je gebruikt, moeten “toereikend zijn, ter zake dienend en beperkt tot wat noodzakelijk is voor de doeleinden waarvoor zij worden verwerkt”. In gewoon Nederlands: je mag het niet verzamelen of hebben tenzij het écht nodig is. En je moet kunnen aantonen (artikel 5(2)) dat je het nodig hebt.

De praktijk is echter weerbarstig. Organisaties en bedrijven vragen van alles, iedereen vult het braaf in en we gaan er maar van uit dat het allemaal goed gaat. Handhaving op dataminimalisatie lijkt vrijwel geheel afwezig. En áls er dan een keer iemand een punt van maakt, dan moet je tot aan het Hof van Justitie om je gelijk bevestigd te krijgen.

(In die zaak ging het over de meneer/mevrouw aanduiding bij het boeken van een treinkaartje. Dus de NS had juridisch volkomen gelijk met haar switch naar “Beste Reizigers!” – het moest van de AVG.)

Tegelijk denk ik ook niet dat alle organisaties bewust kiezen voor massaal datagraaien. Veel webwinkels bijvoorbeeld zouden best af willen van de verplichte meneer/mevrouw op het bestelformulier (of een “wil ik niet zeggen” er bij), maar krijgen dan te horen dat “dat technisch niet mogelijk is” of ontvangen een offerte van duizend euro voor maatwerk. En dat is het natuurlijk ook weer niet waard, vanuit hun perspectief.

Striktere handhaving lijkt me de enige optie. Als ik de baas van de AP was, zou ik een mailtje uitsturen naar alle webwinkels dat er 2000 euro boete volgt als de meneer/mevrouw-keuze op 1 november nog verplicht is. En dat kun je vrij geautomatiseerd checken ook.

Arnoud

Fraude met ChatGPT: aspirant-advocaat belandt bij de hoogste rechter

Bron: Emanuel Peire, Medium

Een UvA-student liet zich met zijn huiswerk helpen door ChatGPT. Dat meldde vakblad Quote onlangs. Het betrof uiteraard een opdracht jurisprudentie- en literatuuronderzoek, waarbij de stochastische papegaai met redeneeraspiraties vier nepliteratuurverwijzingen oplepelde. En dat ging tot aan de Raad van State.

De opdracht hoorde bij het vak Amsterdam Law Firm 2.1 (“In dit het unieke onderwijsprogramma oefen je in kleine groepen je vaardigheden met voorbeelden uit echte zaken”). Zo te lezen in de uitspraak ging dat niet geheel conform de instructie:

De werkgroepdocent heeft geconstateerd dat de in de opdracht gebruikte bronnen 2 tot en met 5 niet bestaan. [appellant] heeft op navraag van de docent te kennen gegeven deze bronnen te hebben toegevoegd aan de lijst van de geannoteerde bibliografie. Nadat de docent [appellant] te kennen heeft gegeven dat zij de bronnen niet kon vinden, heeft hij later op de dag links naar alternatieve bronnen aangeleverd. Bij de examinator is daardoor het vermoeden gerezen dat de bronnen zijn gegenereerd door kunstmatige intelligentie (hierna: AI) of zijn verzonnen.
De examencommissie oordeelde dat dit fraude is, waardoor hij zijn portfolio volledig opnieuw kon maken. Ook werd hij uitgesloten voor de vakken Goederenrecht en Europees recht. Het College van Beroep bevestigde de uitspraak, ondanks alle door de student (rechtsgeleerdheid, immers) uit de kast gehaalde argumenten waaronder dat hem niet de cautie was verleend of gewezen werd op het recht tot bijstand.

Daarop stapte de student naar de Raad van State, wat voor de rechtsvorming fijn is want zo hebben we nu de eerste uitspraak over de vraag of gebruik van AI kan tellen als fraude. (En de student kan het als “realistische zaken uit de rechtspraktijk” opvoeren bij sollicitaties.)

Het onderliggende juridische probleem: moet de examencommissie of docent aantonen dat een AI-dienst is gebruikt, of moet de student aantonen van niet?

Hoofdregel is dat de student eigen werk moet inleveren, dus als er een vermoeden rijst dat dat niet het geval is, heeft de student de bewijslast dat zhij het wél zelf gemaakt heeft. Of het nu gaat om AI, copypasteplagiaat of een medestudent laten schrijven.

In dit geval stelde de student ChatGPT alleen te hebben gebruikt om de bronnen netjes conform de Leidraad laten herschrijven. Plausibel, daar is die tool goed in en ik doe dat zelf ook. Alleen: er is een niet-verwaarloosbare kans dat de uitvoer meer of andere bronnen bevat dan je er in stopte.

Volgens de student was dat hier ook gebeurd. Na de eerste signalering had hij de bronnen zelf opgezocht, en daarbij alternatieve links gegeven. Maar de examencommissie vond dat niet overtuigend, dit waren geen “slordigheden” zoals een typefout of verkeerd paginanummer.

Een moeilijke dus. Enerzijds wil ik best geloven dat de lijst die er in ging, wél keurig uit juridische bronnen was samengesteld en dat het taalmodel er statistisch mooier klinkende tekst van maakte. Het heeft immers geen taalbegrip en maakt dus iets dat lijkt op een Leidraad-conforme versie van een bron.

Anderzijds zou iedereen die deze diensten gebruikt moeten weten dat dit gebeurt, en dus alle bronnen in detail nog eens na moeten lopen. Het voelt wat heftig om dat nalaten “fraude” te noemen, maar het is wel het soort detail waar juristen slecht op gaan.

Derderzijds: dat dit gebeurt, is weinig intuïtief voor velen. De dienst is er zelf ook niet bepaald expliciet hierover (vage generieke disclaimers tellen niet). Dit is waarom de AI Act geletterdheid verplicht stelt. Ik zou wel durven stellen dat een vak over bronnen onderzoeken toch minstens een slide moet besteden aan dit probleem.

Arnoud