Amerikaanse advocaten gestraft na citeren door ChatGPT verzonnen zaken

AlexandraKoch / Pixabay

Advocaten van het Amerikaanse advocatenkantoor Levidow, Levidow & Oberman zijn beboet voor het indienen van informatie die verzonnen werd door ChatGPT. Dat meldde Tweakers onlangs. In mei gaf de zaak veel ophef: de volgendewoordvoorspeldienst genereerde een imposant stukje proza inclusief relevante zaken en verwijzingen naar wetsartikelen, die allemaal niet bleken te bestaan. De advocaat wordt beboet voor het zonder controle indienen van de tekst, aangezien dat tegen de professionele verantwoordelijkheid is. En er was nóg een zaak waarin juristen op ChatGPT voeren.

Zoals ze het bij The Guardian uitleggen, het is met name het niet controleren waar de rechter over valt:

The judge said the lawyers and their firm “abandoned their responsibilities when they submitted nonexistent judicial opinions with fake quotes and citations created by the artificial intelligence tool ChatGPT, then continued to stand by the fake opinions after judicial orders called their existence into question.”
Een vergelijkbare maar iets complexere zaak deed zich onlangs voor in Colorado, waar een advocaat voor het eerst een contractenzaak deed en ChatGPT het verweerschrift liet schrijven. Zachariah Crabill deed dat volgens de regels: niet gelijk “schrijf me een verweerschrift” maar eerst een algemene opzet, dan toevoegen van wetgeving en dan even controleren. En daarna de details uitwerken zoals jurisprudentie, alleen miste hij daar het stapje “nóg een keer controleren”:
“Based on the accuracy of prior validated responses, and the apparent accuracy of the case law citations, it never even dawned on me that this technology could be deceptive,” Crabill said in court documents. Crabill claims he filed the motion without knowing he cited fake cases. On the day of the hearing, he realized his mistake. In a message to one of the Baker Law Firm’s legal aides, he said he thinks all the case cites from ChatGPT are “garbage” and he can’t find them in LexisNexis.
De rechter was niet onder de indruk en weigerde het verweerschrift aan te nemen, wat de cliënt dus de zaak kostte.

Legal tech expert Alex Su ziet een werklastprobleem als onderliggende oorzaak:

Why do lawyers cut corners? Part of it is immense workload and stress, combined with the fact that the odds of getting caught are low. Part of it is also that some of the rules seem silly, and breaking them feels harmless. … At the end of the day, cutting corners is just part of the reality of law firm practice. There’s just too much work to be done. So as a business owner, you find ways to be efficient, which sometimes involves breaking certain rules. And yet lawyers cannot admit to this publicly.
Hij voegt er twee argumenten aan toe: allereerst dat in het Amerikaanse rechtsstelsel het vinden van jurisprudentie écht nog ingewikkeld is terwijl er veel van afhangt, en ten tweede dat Amerikaanse jurisprudentie (op district court niveau bij de staten, de hatseklatskantonrechteruitspraken zeg maar) echt lastig te lezen is:
According to Judge Kastel, the [made-up case Varghese vs. China Airlines] was flawed and its legal analysis was filled with “gibberish.” I mean, he’s not wrong. I read the Varghese case several times, and it felt impossible to understand what was happening. But imagine you’re a lawyer who only litigates in state court where you’re used to reading incoherent and confusing opinions. You might not realize that incoherent writing is extremely unusual when you’re reading something from the U.S. Court of Appeals.
Het zal vele juristen met mij herkenbaar voorkomen dat je een enorme uitspraak met lastig leesbare zinnen van een alinea of twee voor je hebt, waar je dan onder tijdsdruk je argument uit moet halen. Eerlijk: dan ga ik ook met ctrl-f zoeken naar trefwoorden, en ik gooi dan ook lappen in ChatGPT met de vraag “vat dit samen”. Alleen hebben we in Nederland – zeker bij rechtszaken – zelden de noodzaak om een zeer recente en nog nergens besproken zaak te citeren als gezaghebbend argument. Een mooi arrest van de Hoge Raad of een Gerechtshof, zeker, maar daar is genoeg commentaar over te vinden van mensen die met aandacht er doorheen zijn gegaan. En als professor X zegt dat in deze zaak rechtsoverweging 4.18 relevant is, dan copypaste je 4.18 en zal het wel goedkomen.

Mijn zorg – net als die van Su – is dat deze zaken opgevat worden als “legal tech AI is onverstandig” of “advocaat blijf van ChatGPT af”. We zien hier uitglijders van mensen die te weinig weten van deze technologie; ze dachten dat GPT een expertsysteem was met chatinterface. Daar is meer voor nodig, en dan kom je bij systemen als Bluetick die met taalinterfaces werken maar wel échte contentbanken er achter hebben zitten. Voor mij voelt het dus meer als een spellchecker gebruiken en vertrouwen op grammaticale juistheid van het resultaat.

Arnoud
40 miljoen euro boete voor cookie-profilering door Criteo

De Franse toezichthouder op de privacy legt Criteo een geldboete op van veertig miljoen euro, las ik bij Emerce. Criteo biedt ‘behavioral retargeting’-diensten aan en gebruikt daarbij cross-site trackingcookies, maar kon niet aantonen dat het toestemming had om profieldata te verwerken van een groep online gebruikers. Ook intrekken van toestemming en andere AVG-rechten waren niet goed geregeld. De boete is stevig gezien het bedrijf, maar het precedent is interessanter: dit raakt vele, vele online advertentiedienstverleners.

De boete is het gevolg van een handhavingsverzoek van het Britse Privacy International, waar de bekende Oostenrijkse ngo none of your business (noyb) zich bij aansloot. Het leidde tot een uitgebreid onderzoek door de Franse privacywaakhond CNIL, die tal van schendingen van de AVG aan het licht bracht.

Allereerst begint men met vaststellen dat al die tracking profielen wel degelijk persoonsgegevens zijn, ondanks dat je geen namen of contactgegevens hebt. Ik signaleer dit even omdat het argument nog steeds gemaakt wordt, onder meer in discussies over wanneer mensen “identificeerbaar” zijn als je niet weet hoe ze heten. Maar je identiteit is dus meer dan enkel de naam in je paspoort, het nummer van je trackingcookie is gewoon ook een identifier.

Toestemming vragen was het grote probleem. Criteo vraagt niet zelf om toestemming, maar laat haar partners dat doen. De meesten gebruiken daar standaard popups voor, maar sommigen bleken dat niet te doen. De CNIL rekent dat Criteo aan (en terecht), want zij gebruiken die gegevens als zelfstandig verwerkingsverantwoordelijke en moeten dus nagaan of alles klopt. Natuurlijk hebben ze dan vrijwaringen en garanties in de contracten geëist met de partners, maar dat betekent hooguit dat ze een deel van die 40 miljoen als schadeclaim bij hun partners kunnen verhalen.

De privacyverklaring van Criteo was inhoudelijk ontoereikend, onder meer door gebruik van vage en generieke termen. Dat is ondertussen aangepast lees ik. Maar het ging ook mis bij de rechten van betrokkenen: niet alle data werd verstrekt bij een inzageverzoek, en je toestemming intrekken of je gegevens laten wissen bleek ook niet goed te gaan:

When a person exercised their right to withdraw consent or deletion of their data, the process implemented by the company only stopped the display of personalised advertisements to the user. However, the company did not delete the identifier assigned to the person or erase navigational events related to that identifier.
Dat klopt natuurlijk niet. Dit is ondertussen dan ook aangepast:
As regards the erasure of data, the company invites the users to send their requests by email to the Data Protection Officer (DPO). For each request, it is up to the company to determine and justify whether data concerning the user may continue to be processed for other purposes and on what legal basis such processing may be based.
Hier heb ik dan een tikje moeite mee, omdat het nogal wat gedoe is om aan te tonen dat het jouw data is. Plus, die arme DPO zal ondergesneeuwd worden. Waarom is niet geëist dat hier een knopje voor gebouwd wordt?

Wie nu denkt, dit klinkt niet alsof Criteo het nu heel bizar had aangepakt, dit lijkt op hoe iedereen het doet: die heeft een punt. Maar zoals dat zo vaak gaat bij de AVG, iedereen kijkt het aan, past wellicht drie zinnen aan in de privacyverklaring en gaat verder tot de volgende incidentele boete. Of ben ik nu te cynisch?

Arnoud

Met welke juridische argumenten overtuig ik de Salesafdeling dat we aan security moeten gaan doen?

jarmoluk / Pixabay

Een lezer vroeg me:

Ons bedrijf (een middelgrote managed service provider) wil meer focus op security introduceren, ik ben aangewezen als de kwartiermaker van het nieuwe team. Het probleem is dat mijn team weinig voor elkaar krijgt, omdat alles te duur gevonden wordt en security geen selling point is voor de klant. Zijn er juridische argumenten waarmee ik het belang van mijn team meer naar voren kan brengen?
Deze vraagsteller is niet de eerste of enige die worstelt met security als deel van commerciële dienstverlening. Het lastige is immers dat security primair een kostenpost is, en als deze dienst goed geleverd wordt dan merk je niets van de security. Pas als het niet goed gaat, dan komen er klachten, maar dan is het natuurlijk al te laat.

De insteek om wetgeving – oftewel dreiging met boetes – te gebruiken als argument is een goede. We hebben bijvoorbeeld sinds 2018 de AVG, die een adequate beveiliging van persoonsgegevens eist. Die regels gelden ook voor MSPs die voor hun klanten data met persoonsgegevens opslaan of verwerken.

Meer algemeen is de Network and Information Security (NIS2) Richtlijn, die afgelopen januari van kracht werd en voor oktober 2024 in de Nederlandse en andere Europese wetten moet komen te staan. Ook deze regels eisen passende en proportionele security bij zo ongeveer iedereen in de IT-sector, op straffe van forse boetes. Voor IoT-apparaatmakers (en hun leveranciers) komt er de Cyber Resilience Act, wie met AI werkt krijgt ook een berg regels over zich heen, en ga zo maar door.

Genoeg argumenten dus om van security een selling point te maken: Koop bij ons want dan voldoet u aan de wet.

Ik zie dat alleen niet zo goed werken als het bedrijf security als een aparte kostenpost neerzet, op afstand van de ‘echte’ dienstverlening. Want die belofte moet je wel waar kunnen maken, en dat kan alleen als je samenwerkt in de productontwikkeling en -verbetering.

Verder is er het probleem dat al deze wetgeving vrij nieuw is, en dus weinig praktische impact heeft laten zien. Daardoor kan een organisatie nog vrij makkelijk kiezen voor “we merken het wel als andere, grotere bedrijven beboet worden en dan passen we ons aan” en daar is weinig tegenin te brengen.

Wat wel kan werken is wanneer het bedrijf zich wil gaan richten op grote klanten. Die zijn hier namelijk wél serieus mee bezig, en zullen van leveranciers garanties vragen dat ook zij aan de nieuwe regels voldoen. Inclusief documentatie en mogelijk audits om het te onderbouwen. Dat vertaalt zich naar een commercieel argument: je krijgt de offerte of aanbesteding niet als we de security niet aantoonbaar op orde hebben, dus daarom heb ik budget nodig om dit te regelen.

Arnoud

Chinese app die gratis spullen weggeeft meest gedownloade gratis app in België

Misschien hebt u er al over gelezen, uw kinderen erover horen praten of het zelf al geïnstalleerd: Temu. Zo opende de VRT onlangs. Het blijkt alweer kopzorgen te geven, met name omdat de app persoonsgegevens verzamelt en daar we-weten-niet-wat mee doet, en omdat het een Chinese app is voelt dat zorgelijk dan wanneer onze eigen datagraaibedrijven dat doen. Maar Temu blijkt ook erg goedkoop te zijn, wat dan weer ouderwetse ecommerceregels doet opleven.

De korte samenvatting:

Temu is een Chinese winkel-app. Wie hem opent, wordt overspoeld met aanbiedingen: elk item lijkt wel in korting te zijn. En de reputatie van de app gaat nog verder: je zou er gratis spullen mee kunnen krijgen. Voor de goede orde, dat is in ons land [Gallia Belgica, AE] niet van toepassing. Maar door Temu te promoten bij je vrienden, spelletjes te spelen of de app simpelweg al meerdere keren op een dag te openen, kan je beloningen (kortingen of gratis spullen) verdienen.
Het bedrijfsmodel erachter lijkt vrij simpel: neem een zak met geld, financier daarmee aanlokkelijke aanbiedingen voor consumenten waar de concurrent niet tegenop kan, en verzamel alle persoonsgegevens (zoals kijk- en koopgedrag) van je enthousiaste gebruikers, ???, profit. Oké, iets serieuzer: die verzameling persoonsgegevens is op zichzelf natuurlijk erg interessant om met andere databanken te koppelen, en dat is iets dat in China goed zou kunnen gezien de daar geldende wetgeving. Van de AVG mag zoiets natuurlijk niet.

Een andere, meer kapitalistische strategie is dat je met deze aanpak de concurrent wegkrijgt, waarna jij als (semi-)monopolist overblijft en dan de prijzen omhoog kunt doen, om zo je verlies goed te maken en winst binnen te harken tot iemand anders hetzelfde probeert. Maar gezien de omvang van de concurrenten specifiek hier (zoals Amazon of Alibaba) zie ik dat niet direct gebeuren. Maar het zou mogen, er is geen algemene wet die je verbiedt onder de inkoopsprijs te verkopen om zo snel te groeien. Bij ons dan; in België is dat in principe wél verboden als oneerlijke handelspraktijk.

Arnoud

Nederlander veroordeeld tot 2,5 jaar celstraf voor betrokkenheid bij Megaupload

Een rechtbank in Nieuw-Zeeland heeft een Nederlandse IT’er veroordeeld tot een celstraf van 2,5 jaar, zo las ik bij Tweakers. De veroordeelde man werkte als programmeur mee aan het draaiend houden van Megaupload, een dienst waarmee gebruikers bestanden met elkaar konden delen. Megaupload werd in 2005 opgericht en werd in 2012 gesloten op verzoek van de FBI. Megaupload zou zelf 175 miljoen dollar verdiend hebben, waarvan een groot deel volgens de rechtbank afkomstig was uit illegale downloads. Het riep de vraag op bij diverse ontwikkelaars: kan ik de cel in gaan als ik blijk mee te werken aan strafbare diensten?

De celstraf valt naar lokale begrippen laag uit, maar zoals Tweakers uitlegt:

Vorig jaar sloten de twee mannen al een deal met de autoriteiten in Nieuw-Zeeland. Daarmee bekenden de mannen dat ze betrokken waren bij een criminele organisatie. In ruil daarvoor mochten de twee oud-medewerkers van Megaupload in Nieuw-Zeeland terechtstaan voor auteursrechtenschending en zouden de Verenigde Staten hun uitleververzoek laten vallen.
Desondanks behoorlijk heftig, als je gewoon ergens werkt als programmeur en je flagship product blijkt illegaal. Alleen is dat niet helemaal wat er aan de hand was hier, zoals diverse commenters signaleerden:
“Hij lanceerde Mp3Top40.net waar Top 40 nummers gratis konden worden gedownload. Een groot succes, tot Stichting Brein met een megaclaim dreigde. De site ging weliswaar op zwart, maar [de man] ging door. Hij kwam in contact met Kim Dotcom.”
Ook is zo te lezen zijn functie niet die van een willekeurige codeklopper in een groot enterprise IT-bedrijf, maar stond hij als cofounder en hoofd engineering bij Mega op de site. In die functie kun je moeilijk wegkomen met “ik was alleen maar aan het programmeren”.

De situatie doet denken aan die uit 2017 met de sjoemelsoftware, waar een softwareontwikkelaar van Volkswagen in de VS tot 40 maanden cel veroordeeld werd voor zijn aandeel. De rechter noemde hem een “pivotal figure” in de ontwikkeling van deze software, wederom dus meer dan gewoon een codeklopper ergens achter een bureau. Inderdaad, hij was ook geen manager of directeur maar dat is nooit het criterium. Het gaat erom of je bewust eraan meewerkte en ruimte had om invloed uit te oefenen op wat er gebeurde.

“Court documents say Kim Dotcom’s empire could not have functioned without the expertise of [de man] and [een ander]”, zo concludeert een lokale krant uit het vonnis. In die situatie heb je dus als medewerker niet echt veel verhaal. Voor wie wél meer onderaan zit, mijn advies van de Volkswagen-blog:

Wat moet je nu doen als ontwikkelaar, stel dat je zo’n opdracht krijgt. Allereerst zeg ik er wel bij dat het moet gaan om écht duidelijk strafbare zaken en dat dit ook voor jou kenbaar had moeten zijn. Verstuur je facturen die een ander vervalste, dan ben je natuurlijk niet strafrechtelijk aansprakelijk. Die kenbaarheid zal de doorslag geven verwacht ik. Daarbij speelt jouw professionele kennis een grote rol. Had je dit kunnen weten, had iedereen in jouw gebied dit kunnen weten of had dit alleen maar na diepgaande juridische analyses duidelijk kunnen worden?

Bij twijfel is mijn advies altijd, escaleren naar boven en/of naar Juridische Zaken. Je mag verwachten dat daar mensen zitten die dan ook zeggen, oei dit kan strafbaar zijn, laten we het niet doen. Dus dan komt er vanzelf een rem op. En de bedrijfsjurist is normaal ook iemand met als taak het bedrijf beschermen tegen claims, waardoor je ook daarvan mag verwachten dat deze er een stokje voor steekt als het duidelijk strafbaar is. Het is nooit verkeerd om iets aan de bedrijfsjurist te vragen bij zulke twijfels, en naar je manager toe lijkt me dat ook goed verkoopbaar: je wilt weten waar de grenzen liggen zodat je het netjes kunt bouwen binnen de wet.

Arnoud

Je site onrechtmatig offline door een pestende ex, wat moet je vorderen?

Nadat de relatie is opgehouden en de verstandhouding tussen beide partijen verslechterd, haalt gedaagde de website van zijn ex uit de lucht en verandert hij alle inlogcodes die eiseres nodig heeft om haar bedrijfsvoering te kunnen faciliteren. Dat las ik bij ITenRecht.nl. Gezellige boel daar. Er was alleen wel een praktisch probleem: hoe geef je juridisch correct aan wat “de website herstellen” precies inhoudt, met name omdat je wel kunt aan zien komen dat er vervolgzaken komen over missende plaatjes of scheve titels. Het vonnis laat zien hoe de rechter daarmee omgaat.
Partijen hebben een affectieve relatie met elkaar gehad, zo begint het vonnis. En wie die zin aantreft, die weet: daar komt heibel van. De vrouw had een ecommercewebsite, en de man was ict-dienstverlener. Nadat de relatie werd verbroken, en de moeder van de vrouw via WhatsApp had gevraagd om teruggave van bepaalde spullen, ging er iets goed mis en besloot de man die website offline te halen en alle logins te wijzigen. Nadat de rechtsbijstand van de vrouw een boze brief stuurde, stelde de man ineens rechthebbende te zijn op het ontwerp en nog een factuur open had staan, zodat hij mocht opschorten.

Weliswaar stuurde hij vervolgens enkele wachtwoorden, maar de site werd niet teruggezet. Een backup kreeg zij wel aangeleverd, maar die was niet genoeg: zo ontbreekt het ‘thema’ van de website, bestaande uit banners, logo’s, foto’s, filmpjes en linkjes naar producten en de vormgeving, positionering en opmaak van deze elementen en onderdelen van en op de website. De dagvaarding was daarop de volgende stap. Eis:

I. [gedaagde] te veroordelen ervoor zorg te dragen dat binnen 24 uur na betekening van dit vonnis aan [eiseres] wordt verstrekt een correcte back-up van de website, inclusief thema en koppelingen, zonder dat gegevens of elementen uit deze back-up zijn verwijderd of toegevoegd;
De rechter gelooft geen bal van het verhaal over auteursrechten en dergelijke:
Vaststaat dat [gedaagde] de website op 20 januari 2023 offline heeft gehaald terwijl voornoemde factuur gedateerd is op 25 januari 2023 met een betaaltermijn tot 8 februari 2023. Het offline halen van de website kan dan ook niet, zoals [gedaagde] stelt, gelegen zijn in de omstandigheid dat [eiseres] die factuur niet heeft voldaan, wat daar inhoudelijk verder ook van zij. Bovendien blijkt uit de door [eiseres] in het geding gebrachte (WhatsApp)correspondentie, zoals weergegeven onder 2.6, nu juist dat [gedaagde] de website van [eiseres] offline heeft gehaald vanwege onenigheid over de afwikkeling van de samenwoning tussen partijen.
Onrechtmatig gehandeld dus, en ga dat maar ongedaan maken. Alleen: wat is een ‘correcte’ backup? Zo ontbrak onder meer het thema dus in de backupset. Als dit WordPress is dan snap ik waarom, via de standaard backupfunctie wordt je thema (de look/feel etcetera) niet meegenomen als je een backup uitvoert of een database-dump doet.

Bijkomend probleem was dat niet bekend was hoe de website er nu precies uit zag op die 20 januari. Daarmee is het eigenlijk niet meer vast te stellen of de gedaagde ex het herstel goed uitgevoerd zou hebben. En dat is een probleem want je kunt niet iemand veroordelen iets te doen dat oncontroleerbaar is:

Bij gebreke van beeldmateriaal waaruit blijkt hoe het thema van de website er uitzag, kan niet worden gecontroleerd of sprake is van een ‘correcte back-up’, nog afgezien van de executieproblemen die toewijzing van die vordering, versterkt met een dwangsom, naar alle waarschijnlijkheid met zich zou brengen. Dat betekent dat de vordering zoals geformuleerd onder I. onvoldoende gespecificeerd en daarom niet toewijsbaar is.
De tweede eis blijft wel overeind: doe niets meer dat de bedrijfsvoering van de vrouw nog hindert, zoals het blokkeren van accounts of API’s. Dat met een dwangsom van 500 euro voor iedere keer dat je het toch doet.

Het is juridisch begrijpelijk maar ook wel frustrerend: iemand maakt je site kapot, maar omdat jij geen screenshots had hoeft hij deze niet meer te herstellen? Maar vergeet niet dat de man al de overige data wél had teruggegeven, zodat de rest van de site door kan. En specifiek bij de afwezigheid van een thema en niet weten hoe dat eruit zag, snap ik de zorgen over de uitvoerbaarheid wel.

Achteraf gezien was een betere optie geweest te eisen dat hij de kosten van het herstel vergoedt, bijvoorbeeld het opnieuw laten ontwerpen en installeren van het thema. Maar de rechter mag zoiets niet zelf erbij verzinnen, als jij afgifte van data vordert en de data is onbekend/onbepaalbaar dan houdt het op en dat is dat.

Arnoud

Oh jee, geen enkel LLM foundation model voldoet aan de AI Act, wat nu?

“Do Foundation Model Providers Comply with the Draft EU AI Act?”, zo kopte een onderzoek van Stanford universiteit recent. Iedereen weet dan dat het antwoord ‘nee’ is, dus dat gaf veel herrie in de AI-tent: gaat dat gekke Europa nou wetten maken waarmee de bekende populaire startblokken voor grote taalmodellen per direct van de markt moeten? Dat kan toch niet waar wezen. Wat is hier aan de hand?

Zeer recent nam het Europees Parlement de AI Act aan. Of nou ja: formeel keurde men de voorgestelde aanpassingen uit haar eigen AI-commissie goed voor de onderhandelingen met de Raad van Ministers. Maar die onderhandelingen zijn de laatste jaren zo voorgekookt dat de kans klein is dat er héle andere dingen uit gaan komen. Op hoofdlijnen weten we dus wel wat er in de AI Act komt te staan, en de schatting dat deze begin 2024 ingevoerd wordt (met een overgangsperiode van 2 jaar, net als de AVG) is dus zeer reëel.

Foundation models oftewel basismodellen zijn taalmodellen die niet voor een specifieke toepassing ontwikkeld zijn. Ze hebben enorme hoeveelheden data en complexiteit, maar zijn vrij eenvoudig te fine-tunen oftewel bij te stellen naar iedere gewenste toepassing, van een klantenservicebot tot een contractenreviewer of een improvisatieverhaaltjesverteller, om eens wat te noemen.

De AI Act gaat uit van risicobeheersing, en dat kan eigenlijk alleen als je weet wat iemand gaat doen. Sollicitanten screenen geeft heel andere risico’s dan een auto ongecontroleerd, pardon autonoom laten rijden, en dat pakt weer anders uit dan live souffleren bij een pleidooi voor de Hoge Raad. Toch heeft het Parlement ervoor gekozen om ook basismodellen mee te nemen, omdat deze zo’n belangrijke rol spelen in de ontwikkeling van specifieke AI-systemen. Bovendien hebben die ontwikkelaars allerlei documentatie en feitelijke informatie nodig bij hún compliance die alleen de beheerder van het basismodel heeft. Zoals het Parlement het formuleert in concept-overweging 60g:

[F]oundation models should assess and mitigate possible risks and harms through appropriate design, testing and analysis, should implement data governance measures, including assessment of biases, and should comply with technical design requirements to ensure appropriate levels of performance, predictability, interpretability, corrigibility, safety and cybersecurity and should comply with environmental standards. These obligations should be accompanied by standards. Also, foundation models should have information obligations and prepare all necessary technical documentation for potential downstream providers to be able to comply with their obligations under this Regulation.
Dat is inderdaad nogal een trits aan eisen. Ze komen neer op een samenvatting van de eisen van downstream afnemers, maar dan beperkt tot het algemene stuk wat ook een basismodel kan realiseren. Dat betekent in de praktijk met name duidelijk en transparant zijn over waar je data vandaan komt, je proces voor bestrijden van risico’s illustreren en documentatie verzorgen.

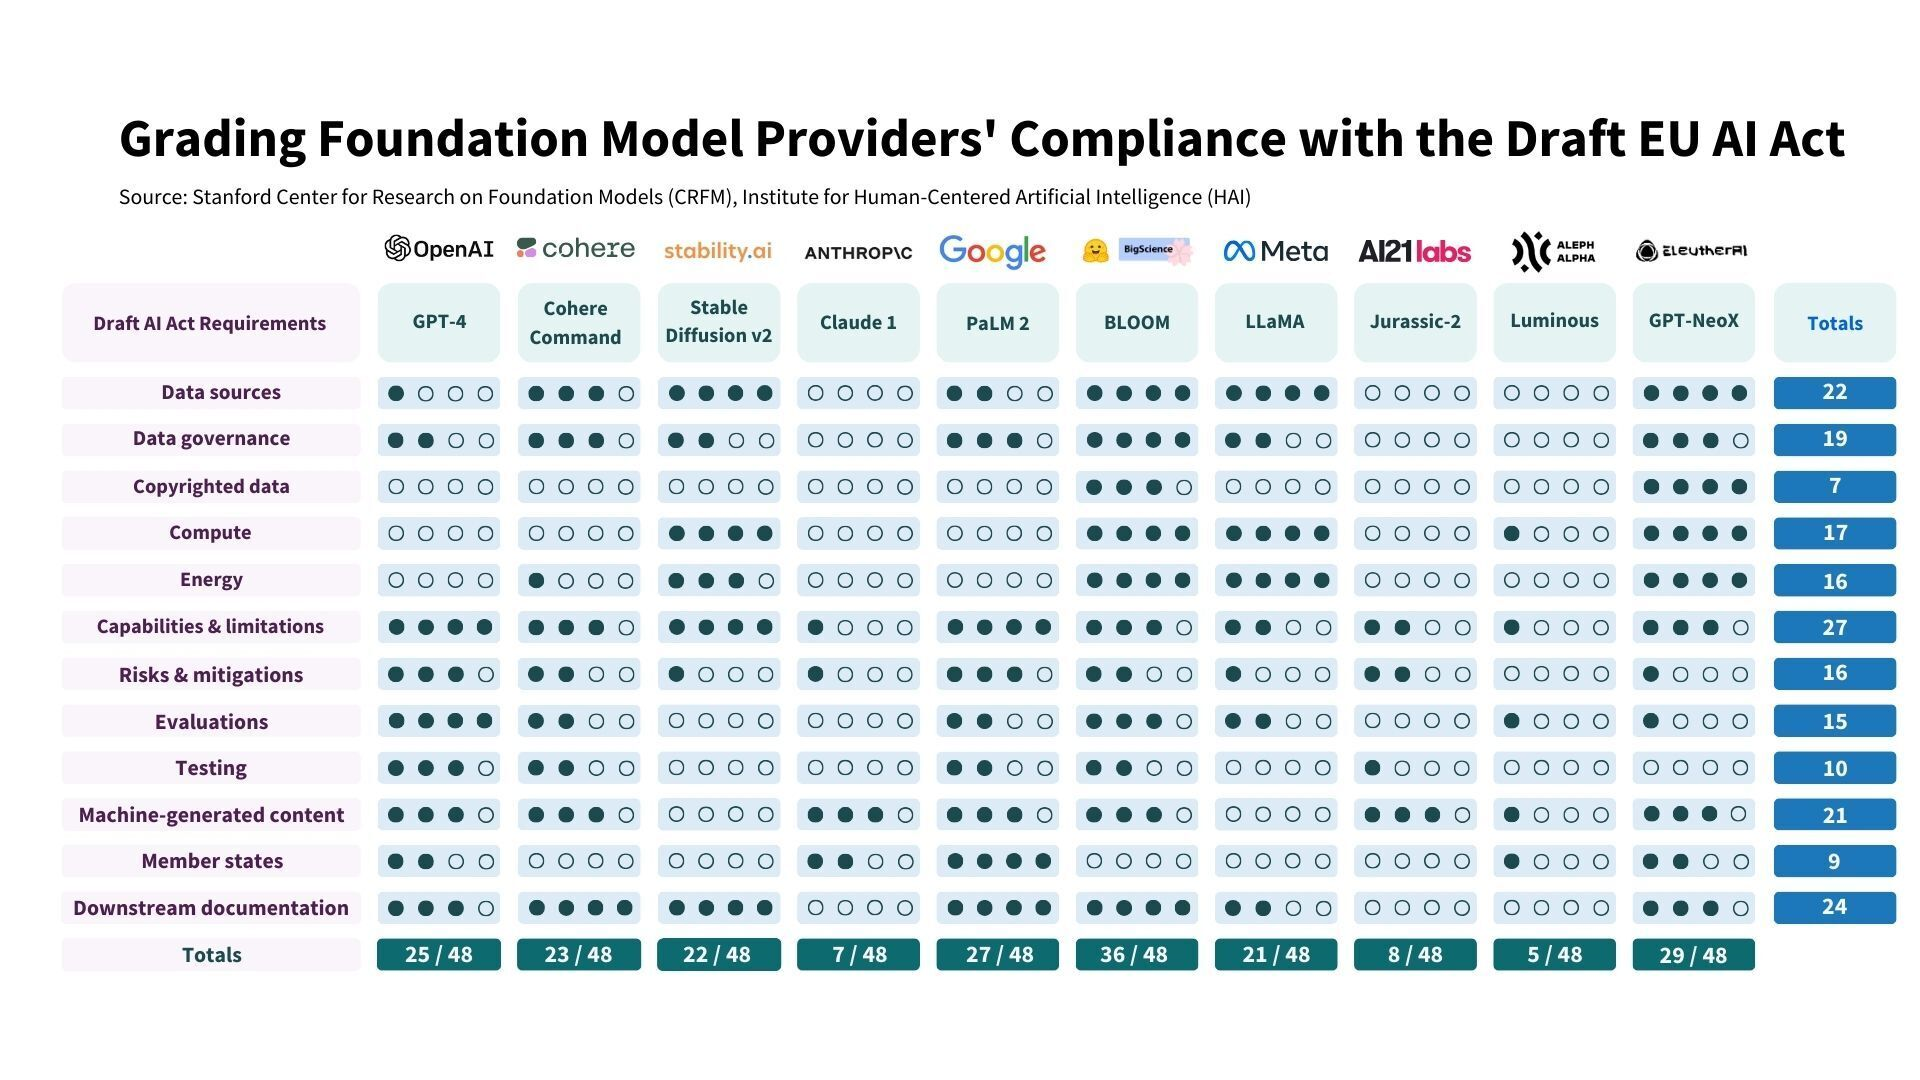
De mensen van Stanford vertaalden dit naar 12 eisen, waarbij ze elk foundation model beoordeelden op basis van publieke informatie op een schaal van 0 tot 4. Dat levert dan deze grafiek op (klik voor groot):

Het best scorende model is BLOOM, een open en vrij taalmodel dat vergelijkbaar presteert met GPT-3. Dat is niet zo gek als je hun uitgangspunten leest over transparantie, omgang en beheer met data en rigide testen op kwaliteit. Toch scoort ook BLOOM niet bepaald goed op zaken als gebruik van auteursrechtelijk beschermde bronnen of efficiënt energiegebruik. Is dat erg? Ik zou zeggen van niet, want er is nu geen enkele eis om daar formele procedures en rapportages over te hebben. Natuurlijk, straks met de AI Act wel, dus er is werk aan de winkel voor deze organisaties.

Betekent dit nu dat de EU eigenlijk modellen zoals BLOOM illegaal wil verklaren? Natuurlijk niet. Een nieuwe wet kan en mag regels bevatten die nu nog niet gevolgd worden. Daarom is er dat overgangsrecht, die periode van 2 jaar waarin bedrijven en organisaties kunnen zien wat de nieuwe regels zijn en hoe je je daarin aan moet passen.

Arnoud

Google wilde chatbot Bard deze week uitbrengen in EU, maar moet dat uitstellen

Clker-Free-Vector-Images / Pixabay

Google had zijn chatbot Bard deze week willen uitbrengen in de Europese Unie, maar heeft dat uitgesteld na zorgen over de verwerking van persoonsgegevens. Dat meldde Tweakers vorige week. De Ierse privacytoezichthouder kwam verrassend genoeg vóóraf met de vraag “hoe gaat u om met persoonsgegevens”, en omdat Google daar nog niet schriftelijk over nagedacht had, moet men nu de invoering uitstellen. Tot mijn verbazing ging het in de comments al snel over een gebrek aan innovatie in Europa en het doodslaan van open source. Ik mis even iets?

Dat Google zijn chatbot nog niet online heeft gezet in Europa, komt volgens Google-ceo Sundar Pichai door twee factoren.

“We werken bij Bard meer met Reinforcement Learning from Human Feedback om de lokale sentimenten goed op te kunnen nemen.” … Behalve dat Europa veel talen heeft met nuances in de culturen, speelt er meer. “Regels variëren tussen landen. We willen ervoor zorgen dat het allemaal klopt.” Die zorgen zitten vermoedelijk in het gebruik van de trainingsdata en privacy.
Die laatste opmerking blijkt dus juist: Google had geen antwoord paraat en vreest dan een handhavingsactie (zoals in Italië) met alle PR-negativiteit van dien.

De reacties zijn uitgesproken negatief, en mooi samengevat als “Jammer dus, en helaas typisch, dat in Amerika alle innovatie plaatsvindt terwijl Europa weer eens uit reflex de handrem aantrekt.” Want volgens mij gaat het hier om regelgeving vanuit een terecht standpunt: dat we de risico’s van nieuwe technologie gecontroleerd willen hebben, omdat ongecontroleerd gebruik leidt tot enorme schade. Dat ze in de VS het prima vinden dat je van alles en nog wat breekt zal best, maar dat maakt je niet innovatief volgens mij.

Afgelopen dinsdag verscheen een essay in Le Monde dat overtuigend betoogt dat juist Europa fors aan het innoveren is.

The flow of emerging high-tech companies is almost equal to that in the United States. Both regions now create the same amount of new start-ups each year. Thirty per cent of all global funding for early-stage companies went to European start-ups, compared with 36% for the US. This gap has halved in five years. What’s more, Europe is showing greater dynamism, with a compound annual growth rate of 24% over the last 10 years, compared with 4% in the US. At this rate, Europe will overtake the US in five years’ time.
Verder zie je ook in de AI-space steeds meer opensourceinitiatieven. En het mooie is: de strekking van de AI Act wordt volgens mij juist makkelijker gehaald door open source dan door dit soort bedrijfjes. Toon aan waar je data vandaan komt en dat die kwalitatief goed is. Als ik iets goed zie gaan bij open data initiatieven dan is het wel de focus daarop, zie hoe ze bij Wikipedia omgaan met copyvio en hoe openstreetmap ieder verkeersbord laat controleren om maar te voorkomen dat ze ergens databankrechten schenden. Ook bij datasets (zoals LAION) zie je duidelijke focus op rechtenbeheer.

Verder gaat veel over toepassingen, geen AI ongecontroleerd inzetten om mensenrechten te schenden of mensen automatisch af te serveren. Dat kan met OSS of closed even goed, dus daar zie ik het verschil niet. En ik zie juist bij de toepassingen enorm veel Haarlemmerolie (snake oil) van het soort “onze AI detecteert micro-expressies om te zien of een sollicitant liegt” met dan een gesloten model en geheime data zodat je niets kunt vaststellen. Als dát is waar de markt naartoe gaat, dan mogen de teugels best even wat worden aangetrokken.

Arnoud

Kamerleden vinden dat Twitter moet optreden tegen intimidatie van journalisten

Twitter gaat volgens Kamerleden te laconiek om met meldingen over dreigementen aan het adres van journalisten, las ik bij Nu.nl. De parlementariërs ergeren zich eraan dat het socialemediabedrijf uitnodigingen van het kabinet om hierover te praten heeft afgeslagen. De meeste van die dreigementen zijn gewoon strafbaar, en er komt ook veel regelgevend geweld uit de Digital Services Act aan, dus dat riep bij lezers de vraag op: wat is precies het probleem hier, waarom worden die wetten niet gewoon gehandhaafd?

Kamervoorzitter Vera Bergkamp verzocht Twitter onlangs “serieuze stappen” te nemen tegen dreigementen aan het adres van Kamerleden. Ik vermoed dat ze een poep-emoji terugkreeg van de persafdeling van het sociale medium. Daarop werd dus verzocht om een gesprek met de directie, die daar geen zin in had, en er lijkt ook weinig meer te gebeuren met klachten over dreigementen.

“[De DSA] geeft ons instrumenten om te handhaven”, zei minister Dilan Yesilgöz (Justitie en Veiligheid) in het artikel. En dat klopt: Twitter is een hostingprovider in de zin van die wet, en die moeten na melding prompt optreden om de inhoud weg te halen als die onrechtmatig lijkt “zonder een uitvoerig juridisch onderzoek”. Afgaande op wat ik zelf aan dergelijke dreigementen heb gezien, zou dat weinig moeite moeten kosten.

De DSA gaat alleen nog een stapje verder: als er een bevel komt van een “bevoegde nationale gerechtelijke of administratieve autoriteit”, dan moet daar onverwijld op worden gereageerd. Dat betekent in principe het bevel opvegen, maar er is ruimte voor een provider om zo’n bevel aan te vechten. Dat biedt dus binnen het Nederlands recht de mogelijkheid dat het OM tot verwijdering beveelt, artikel 54a Strafrecht:

Een tussenpersoon die een telecommunicatiedienst verleent bestaande in de doorgifte of opslag van gegevens die van een ander afkomstig zijn, wordt als zodanig niet vervolgd indien hij voldoet aan een bevel van de officier van justitie, na schriftelijke machtiging op vordering van de officier van justitie te verlenen door de rechter-commissaris, om alle maatregelen te nemen die redelijkerwijs van hem kunnen worden gevergd om de gegevens ontoegankelijk te maken.
Juridisch gezien geen speld tussen te krijgen: Nederland mag zo’n bevel geven als er reële dreigementen worden gedaan tegen Nederlandse politici, en Twitter moet daar gehoor aan geven van de Europese regels die daar boven staan (want inderdaad, de DSA adstrueert het supranationale karakter van de Europese Unie, ik ben nog steeds geërgerd door die zin).

Maar de praktische kant blijft natuurlijk dat dit soort dingen alleen werken als iedereen bereid is om uiteindelijk mee te doen. En, wanneer iemand dat niet doet, de overheid de macht heeft om het recht te handhaven. En daar zit hem het probleem hier, zeker als Twitter zich fysiek uit Europa terugtrekt. Er blijven dan weinig mogelijkheden over om nog te gaan handhaven.

Arnoud

Juridisch taalgebruik is écht nergens goed voor, suggereert een experiment

Klagen over het wollig taalgebruik van juristen is meestal iets voor buitenstaanders, las ik in Trouw. Maar ze hebben er zelf ook een hekel aan. Maar waarom doen ze het dan? Nou ja, omdat iedereen het doet en je zo het snelste klaar bent. Ja, echt. MIT-onderzoeker Eric Martinez en collega’s trokken deze conclusies op basis van tekstevaluatie bij 100 advocaten en 100 juridisch leken. Kunnen we nu dan misschien met z’n allen afspreken naar klare taal te gaan?

De voornaamste reden waarom teksten zo moeilijk te lezen zijn, is het woordgebruik. Vaak archaïsch, in ieder geval met infrequent gebruikte woorden – dat hindert het snel scannen van teksten, want je brein struikelt over ‘heretofore’ of ‘dienaangaande’. Ook een probleem is de indirecte manier van verwijzen. Als men ambiguïteit wil wegnemen, wordt vaak een frase gecopypaste zodat duidelijk is dat je het steeds over hetzelfde hebt. Dat geeft dan lange zinnen. De oplossing is dan een definitie invoeren (hierna: “de Definitie”) en vanaf daar verwijzen naar de Definitie in plaats van die lange frase. Uit onderzoek blijkt dat juist die inline definities enorm vertragend werkt.

Er zijn vele hypotheses geopperd waarom juristen zo wollig of ingewikkeld schrijven. De bekendste verklaring voor gebruik van jargon is communicatie met peers: het is sneller om vaktermen te gebruiken dan ze in lekentermen uit te leggen, daarom zie je dat vaak terug in beroepsgroepen. Maar specifiek bij zeg contractsclausules of wollig taalgebruik gaat dat niet op, geen jurist zegt “met behoud van rechten en weren” om effectiever te communiceren. Het onderzoek van Martinez (publicatie) laat ook zien dat juristen zelf sneller door een document heen komen als zulke teksten er niet in staan.

Een andere verklaring is exclusiviteit: het buitensluiten van leken die niet door het jargon heenkomen. Dit weerlegt men met de bevinding dat de onderzochte juristen aangeven liever een klaretaalschrijvende collega te hebben dan eentje die “Een verordening adstrueert het supranationale karakter van de Europese Unie” meent te moeten zeggen (jémig, Wikipedia). Een variant daarop is dat juristen moeilijke taal gebruiken zodat de cliënt meer het gevoel heeft voor iets goeds te betalen, klare taal is geen 800 euro per uur waard zeg maar. Maar als advocaten zélf zeggen dat de klaretaalversie beter is, dan blijft ook dat moeilijk overeind.

Blijft over de copypastehypothese:

[L]awyers may simply draw from old, pre-existing templates laden with arcane and convoluted language due to that being easier and cheaper to produce than drafting a simpler contract from scratch. This finding is consistent with recent empirical work indicating that lawyers rely heavily on templates in drafting contracts, with future agreements only rarely deviating from previous ones even when deviations would apparently benefit the involved parties(42). In addition to cost, said stickiness may also be borne out of lawyers’ training in the importance of precedent, which overall might lead to an adherence to templates laden with old, archaic language by virtue of the fact (or assumption) that they worked before, and that the specific language may have been “defended in court” previously.
Tijd dus, je werkt onder tijdsdruk en deze clausule regelt opzegging in de bekende bijzondere omstandigheden dus hupsakee in het contract ermee, klaar. Dit verklaart ook waarom zo veel contracten van die riedels met wat ik Amerikaans strooigoed noem, iedereen doet het, het zal wel ergens goed voor zijn, ik ga écht niet uitzoeken of een “Headings” clausule zinnig is want dat kost meer dan het oplevert, handtekeningenblok en klaar.

Daarnaast dus het argument dat die clausules al eerder getest zullen zijn bij de rechter, waardoor het vanuit aansprakelijkheid slimmer is die te gebruiken. Als jij afwijkt van het gebruikelijke én dat blijkt niet te kloppen, dan was het jouw fout. Gebruik jij hetzelfde als iedereen en blijkt dat niet te kloppen, dan is dat vervelend maar niemand die dat kon weten, toch?

Kunnen we nu naar klare taal? Dat zou iedereen graag willen, maar als dit de redenen zijn dan is dat toch bijster ingewikkeld. Want waarom zouden juristen nu ineens meer tijd krijgen om aan die standaardclausules te mogen werken, en waarom zou het vooroordeel dat “oude clausules getest zijn bij de rechter” nu niet meer opgaan? Nee, daar ben ik behoorlijk cynisch over. Heel misschien is er wat te halen als kantoren meer templating software (#legaltech) in gaan zetten, omdat je bij de transitie naar zo’n systeem wél tijd hebt om oude clausules eens te herzien en wat er nodig is om de nieuwe teksten juridisch waterdicht te krijgen.

Arnoud