Moet ik zeshonderd kilo verkeerd geleverde tegels steeds naar buiten sjouwen?

Photo by Clément Proust on Pexels

Via Reddit:

Onze bestelling [wandtegels] is verkeerd gegaan. Er is een compleet andere type, formaat, merk en hoeveelheid geleverd. … We hebben in eerste instantie de tegels binnen opgeslagen, maar 600kg aan tegels verplaatsen is niet makkelijk. Nu zou het bedrijf de bestelling vandaag komen ophalen. Dus wij de 600kg tegels weer aan de weg gezet. Eenzijdig is de afspraak ineens verzet naar donderdag. Moeten wij ze nu weer naar binnen slepen, en hoe vaak moeten we dat dan doen?
Volgens de wet moet de handelaar bij nonconformiteit naleveren, herstellen of vervangen (art. 7:21 BW) en dat moet natuurlijk kosteloos. Zo te lezen is deze tegelboer dat ook van plan, alleen lukt het even niet om het te komen halen.

Nou is een doos in de gang laten staan voor de meeste mensen nog tot daar aan toe. Maar hier gaat het om zeshonderd kilo tegels, die dus na ontvangst in de schuur gezet zijn, toen buiten gezet en nu dan weer naar binnen en op donderdag weer naar buiten. Ik krijg al rugpijn als ik er aan denk.

Hierover zegt de wet in datzelfde artikel (lid 1 onder c) dat je recht op vervanging vervalt wanneer

de zaak na het tijdstip dat de koper redelijkerwijze met ongedaanmaking rekening moet houden, teniet of achteruit is gegaan doordat hij niet als een zorgvuldig schuldenaar voor het behoud ervan heeft gezorgd.
Wat een “zorgvuldig schuldenaar” precies doet, is niet vastgelegd, want dat hangt af natuurlijk van de omstandigheden van het geval. In de schaarse jurisprudentie gaat het dan eigenlijk altijd over blijven gebruiken van de zaak, waardoor waardevermindering kan ontstaan die schadeplichtig maakt.

Bij een geval met een auto die een schade-auto bleek, mocht de consumentkoper de koop ontbinden. Hij reed er echter nog af en toe mee, en parkeerde deze gewoon aan de openbare weg. Dat leverde een kras op. Echter:

In het op de openbare weg parkeren van de auto ziet de kantonrechter geen schending van de op [verzoeker] rustende zorgplicht; het is heel gebruikelijk dat een auto tijdens werktijd op een nabijgelegen parkeerplaats wordt geparkeerd. [verweerder] heeft weliswaar aangevoerd dat je met het rijden op de weg altijd risico op schade loopt, maar van [verzoeker] kon niet worden verwacht dat hij de auto gedurende de tijd dat [verweerder] deze weigerde terug te nemen in zijn geheel niet zou gebruiken, terwijl door [verzoeker] onbetwist is gesteld dat hij de auto nodig had om van en naar zijn werk te komen.
Dit lijkt me vergelijkbaar genoeg met een stapel tegels op de stoep zetten. Laden en lossen op de stoep is gebruikelijk, en het is altijd mogelijk dat er wat mee gebeurt. Dat maakt niet iedere schade automatisch “onzorgvuldig”.

Ik neem aan dat men ze netjes opgestapeld heeft, dus omvallen zou niet zomaar moeten gebeuren. Een zeiltje er overheen beschermt tegen de meeste weersomstandigheden. Het risico op diefstal is lastig in te schatten.

Volgens art. art. 6:275 BW jo. 3:120 BW heeft de consument in zo’n situatie recht op vergoeding van (noodzakelijkerwijs) gemaakte kosten voor het bewaren van de tegels. Je mag dan zelfs weigeren de tegels terug te geven tot die kosten betaald zijn.

Hiermee kun je rechtvaardigen dat je een paar buren of een klusser tegen betaling inschakelt om te helpen sjouwen. Mijn advies zou zijn om het bedrijf te vragen: ik zet het aan de weg en dan moet je maar zien, of ik krijg 100 euro korting en dan sla ik het binnen op.

Arnoud

Mag mijn softwarelibrary stiekem AI instrueren om haar commerciële diensten te promoten?

Photo by Andrae Ricketts on Unsplash

Een lezer vroeg me:

Laravel Boost is een MIT-gelicenseerde library die helpt om AI-coding agents (zoals Claude Code, Copilot, etc.) effectief met het Laravel-framework te laten werken. De beheerder heeft onlangs een instructieregel toegevoegd die alle agents die deze library gebruiken aanraadt om voor Laravel Cloud te kiezen als deploymentplatform. Dat is een commerciële dienst van hetzelfde bedrijf. De gebruiker weet dit niet, en de instructie is verpakt als neutrale technische aanbeveling. Is dat juridisch toegestaan?
Met software als deze Boost-library kun je AI-agents laten meeschrijven aan het ontwikkelen van je eigen webapplicatie, in dit geval gebaseerd op het populaire Laravel-framework. Boost is dan een soort doorgeefluik, zodat de juiste code bij de door jou gekozen AI-agent komt.

En wacht even, dan zou de maker van Boost ineens een instructie toevoegen waardoor de agent het commerciële hostingplatform Laravel Cloud afneemt? Dat voelt niet echt zuiver, inderdaad.

Er zit echter meer achter. Ik citeer even Laravel Magazine:

The short version is that Boost’s guidelines used to direct new developers toward configuring Nginx or FrankenPHP manually, and the data Laravel has on who is picking up the framework now includes a large and growing number of people who have never deployed a web application in their lives. For those people, “go configure Nginx” is not guidance, it is a cliff. Cloud is an on-ramp.
De oude situatie was dus: je moet het installeren, dat kan met A, B of onze Cloud. Dat is nu “dat kan met onze Cloud” geworden. Het is volgens mij niet controversieel om in je handleiding alleen naar je eigen diensten te verwijzen.

Het voelt raar omdat de instructie niet aan een mens wordt gegeven maar bij een agent terecht komt. Die zal daar anders op reageren, zoals blijkt uit screenshots bij Tech Stackups:

@pushpak1300 @taylorotwell Can this be put in another file (not CORE) so it can be overridden easily? My Claude is now poisoned and requires me to explain each time that I don’t use Laravel Cloud. … Yeah @pushpak1300 this needs to move to somewhere else – I now have to override the core guideline entirely to avoid justifying why there’s suddenly an ad in our team’s agents.
Ik zie wel hoe het vervelend is dat je AI agent je elke dag vertelt dat Laravel Cloud het beste hostingplatform is.

Wettelijke regels over dit soort ‘reclame’ bestaan niet. Ik zet het tussen aanhalingstekens omdat ik er zelf nog niet eens over uit ben of dit überhaupt reclame is. De dienst is commercieel, maar de melding is zakelijk en relevant. Als dit in de mensenhandleiding had gestaan, had niemand er wat van gevonden.

De gevolgen zijn irritant, zeker. Als Claude elke dag tegen mij zou zeggen “ik zie dat je de software nog niet bij Laravel Cloud hebt geplaatst”, zou ik daar ook een tikje boos over worden. Maar daarmee wordt het bericht nog geen reclame, althans niet in de zin van “online reclame die toestemming vereist”.

Arnoud

X moet Danny Mekic inzicht geven in de verwerking van zijn persoonsgegevens, oordeelt Gerechtshof Amsterdam

Photo by Google DeepMind on Pexels

Het Gerechtshof Amsterdam geeft de Nederlander Danny Mekic gelijk in zijn zaak tegen Twitter/X. Dat meldde NRC vorige week. Het is de vijfde juridische overwinning van Mekic op rij over dezelfde kwestie, maar inzage in de verwerking van zijn gegevens heeft hij nog altijd niet.

De zaak speelt al geruime tijd. Over de eerste instantie blogde ik destijds:

Technoloog en Ph.D-kandidaat Danny Meki? ontdekte in oktober dat hij op X was onderworpen aan een shadowban: weliswaar kun je zelf alles nog gebruiken, maar niemand krijgt je berichten meer te zien. Dat bleek (volgens de helpdesk van Twitter, waar verbazingwekkend genoeg nog mensen werkten destijds) te herleiden tot een artikel van de NOS dat Mekic daar gedeeld had:

“De chats van honderden miljoenen mensen worden straks gescand om een relatief klein aantal misdadigers op te sporen, hoe erg ook. ”[ [account 2] ] Veel kritiek op Europese plannen tegen kinderporno: “Niet proportioneel”

De algoritmes van Twitter vonden dit problematisch, maar Mekic kreeg geen uitleg waarom. En dat vindt de wet dan weer  problematisch, want de Digital Services Act (DSA) eist simpelweg dat je motiveert waarom -en met bewijs- je een bepaalde moderatiehandeling hebt gedaan.

De rechter gaf Mekic gelijk, maar X maakte vervolgens 90% van de documentatie die ze gaf onleesbaar “vanwege bedrijfsgeheimen”. Daarom ging Mekic in hoger beroep, wat tussentijds nog leidde tot een geschil over een spreekverbod voor Mekic, omdat men bang was dat hij de ruwe documenten zou lekken. (Niet toegewezen, uiteraard.)

Nu is er dan het inhoudelijke arrest van het Hof Amsterdam. Men loopt categoriegewijs door de ruwe informatie en licht toe waarom deze al dan niet vertrouwelijk zou moeten zijn.

Plaatsing van het NSFW label op content van [geïntimeerde] (de post van 11 oktober 2023) is de aanleiding geweest voor onderhavig geschil. … X heeft niet inzichtelijk gemaakt waarom bedrijfsgeheimen worden geopenbaard als [geïntimeerde] inzage krijgt in welke NSFW labels op zijn content zijn geplaatst.
Het argument daarbij was natuurlijk dat iedereen dan trucs gaat verzinnen om de criteria voor zo’n label te omzeilen. In het algemeen is dat een risico. Als alle criteria algemeen bekend zijn, dan is detectie een stuk minder krachtig. Maar het Hof wil graag weten waarom specifiek bij deze inzage door deze persoon voor deze posts dat risico zich conreet voordoet. En die uitleg kan X niet geven.

Iets vergelijkbaars gebeurt bij posts van Mekic die als “ongeschikt voor advertenties” zijn gemarkeerd:

Het aanmerken van een post van [geïntimeerde] als gevoelig of ongeschikt voor advertenties treft hem in die zin dat het besluit om een dergelijk label toe te kennen tot gevolg heeft dat er naast die post geen advertenties komen te staan of alleen advertenties worden getoond van adverteerders die geen instructie hebben gegeven om een bepaalde gevoeligheid, ongeschiktheid of trefwoord te mijden. Dat kan tot gevolg hebben dat de reputatie van [geïntimeerde] wordt aangetast.
Ook hier geldt dat je als bedrijf natuurlijk een commercieel belang hebt om de werking van je advertentiesysteem te beschermen. Omdat het mogelijk om “enkele tientallen” posts gaat, is er dan een “zeker risico” dat patronen in het advertentiesysteem kunnen worden herkend. Maar omdat de reden voor de markering ontbreekt, is dat nog vrij speculatief en daarmee onvoldoende.

Frustrerend voor mij is dat we uiteindelijk weinig tot geen inzicht krijgen in waarom die specifieke tweet tot dat label leidde. Meer dan de zin “Dat de post van 11 oktober 2023 is gemarkeerd omdat daarin het woord ‘kinderporno’ voorkwam, is al bekend” krijgen we niet. Maar was het dan werkelijk zó simpel, een keyword scanner maakt dat je bericht NSFW is?

Arnoud

Mag je op basis van gestolen data onthullen wat de omzet van Rockstar Games is?

Photo by trenchophotography on Unsplash

Hackersgroep Shinyhunters heeft bedrijfsgegevens van Rockstar Games gepubliceerd, meldde Tweakers vorige week. De data bestaat voornamelijk uit financiële cijfers, zoals dat Rockstar gemiddeld 9,6 miljoen dollar per week omzet draait. Dat riep discussie op: is dat nou een feit dat je mag brengen als journalistiek medium? Het komt uit gestolen bron.

Het is strafbaar (art. 139g Sr) om gegevens te verwerven of voorhanden te hebben waarvan je redelijkerwijs kunt vermoeden dat ze uit misdrijf zijn verkregen. Net als bij de Odido-datadump is dat hier evident. En deze datadump was wat mij betreft “niet-openbaar” toen Tweakers haar artikel online zette.

Er is een uitzondering voor een openbaarmaking die het algemeen belang dient. Nieuwswaarde valt daaronder. Alleen: is “Rockstar draait gemiddeld 9,6 miljoen dollar per week omzet” wel nieuws?

De meeste jurisprudentie over “is dit nieuws” komt uit de privacy-hoek, met als bekendste mijlpaal het Caroline von Hannover II-arrest. Privacy en informatievrijheid staan op gelijke voet, waarbij de discussie neerkomt op de vraag of de publicatie “bijdraagt aan een debat dat in de publieke belangstelling staat”.

Wat voor debat zou dat hier kunnen zijn? Het is nieuws dat zo’n grote organisatie als Rockstar is gehackt en zulke gevoelige informatie is gestolen, zeker. Maar daarvoor hoef je niet te citeren uit die documenten.

“Dit is de omzet van Rockstar” is als feitje wat mij betreft te mager. Rockstar als bedrijf staat niet in een groot debat over woekerwinsten, afpersen of geld aftroggelen van klanten. Iets breder geldt dat misschien wel voor de gaming-industrie, denk aan zaken als lootboxen en verslavende dark patterns waarmee mensen overgehaald worden geld in games te stoppen. Maar ik zie Rockstar niet prominent in dat debat naar voren komen.

Het zijn natuurlijk opmerkelijke cijfers waar je boeiende inzichten uit kunt halen. Maar “only around 4 percent of GTA Online players were spending money on the game” is een leuk gegeven, maar is dat een debat, iets waar we het over moeten hebben met z’n allen?

Arnoud

RDW geeft groen licht: Tesla mag FSD uitbrengen in Nederland

Photo by David von Diemar on Unsplash

Tesla mag Full Self-Driving (Supervised) uitbrengen in Nederland. Dat meldde Tweakers onlangs. Zij waren ook de enige die het niet “zelfrijdende Tesla’s” noemen, want zelfrijdend is simpelweg niet mogelijk in Nederland. En ik erger me over nóg een ding hierbij.

Tweakers legt uit wat de FSD feature inhoudt:

Full Self-Driving (Supervised) is een systeem waarmee de auto zelfstandig van A naar B kan rijden, zonder dat de bestuurder de handen aan het stuur hoeft te houden. Het systeem werkt op snelwegen, waar FSD zelfstandig kan inhalen en afslagen kan nemen. FSD werkt ook op provinciale wegen, binnen de bebouwde kom en kan overweg met rotondes en verkeerslichten.
Recent werden ook alle voorkomens van de term ‘autopilot’ veranderd naar ‘autosteer’ en men spreekt nu consequent van “(supervised)” waar het over de rijondersteuning gaat.

Braaf herhaalt de media de Tesla talking points dat de mens verantwoordelijk is:

Helemaal zelfstandig rijden doet de auto nog niet. Er moet nog altijd een mens achter het stuur zitten om zo nodig in te grijpen. Die bestuurder kan niet ondertussen een film kijken of de krant lezen, maar moet op de weg letten. De auto houdt dat met een camera in de gaten. … De bestuurder van de auto blijft verantwoordelijk als er een ongeluk gebeurt, en moet dus ook alert blijven.
Dit vind ik dus buitengewoon ergerlijk, ik zou het haast victim blaming noemen. Want het probleem is simpel: mensen zijn niet gemaakt om langdurig te observeren en alert te blijven in saaie, weinig veranderende situaties.

Er zijn vele onderzoeken, zoals dit artikel of dit artikel, die dit onderstrepen. Een mooie samenvatting is deze preprint:

The paradox is structural: the more reliable the system appears, the more likely drivers are to disengage, generating precisely the conditions that make automation failure most dangerous. The Article further argues that sustained reliance on semi-automation may erode manual driving skills over time, weakening the very human competence these systems depend upon in emergencies.
Het is een speciaal geval van mijn ergernis over human-in-the-loop als oplossing voor beperkingen in AI en andere geautomatiseerde systemen. Ik ga het vanaf nu gewoon processuele luiheid noemen: je hebt niet nagedacht over hoe je proces moet werken als je een mens op het einde zet die “gewoon alles controleert”.

Natuurlijk, in het huidige systeem is de bestuurder altijd verantwoordelijk voor besturen van de auto. Of je FSD aan hebt of niet, verandert daar niets aan. Ik denk ook niet dat we naar een systeem moeten waarin aanzetten van FSD je zou ontslaan van aansprakelijkheid. En het is nog te vroeg om de bestuurder geheel uit de loop te halen.

Arnoud


Dure blunder voor Coolblue: webshop verkoopt gloednieuwe laptops voor ruim 250 euro minder dan bedoeld

Photo by Alexas_Fotos on Pixabay

Een dure fout van Coolblue, zo noemt het AD het. De webwinkel verkocht in maart een nét nieuw uitgekomen MacBook voor slechts 868 euro. Niet de bedoeling, maar velen bestelden er gelijk eentje. Wat natuurlijk de vraag oproept: was dat bindend?

Al sinds 2008 geldt de norm dat prijsfouten bindend zijn, tenzij het evident een vergissing was. In die zaak ging het om een televisie die normaal 999 euro kostte en nu voor 99 aangeprezen werd. Bij zo’n enorm prijsverschil moet je nader onderzoek doen, anders ben je niet te goeder trouw en is er geen koop tot stand gekomen.

Sindsdien zijn er vele gevallen geweest van prijsfouten in alle soorten en maten, maar eigenlijk is daar vrijwel nooit meer een rechtszaak over gevoerd. Een zeldzame was tegen Leen Bakker, dat een hoogslaper voor 24 euro aanbood die normaal rond de 300 was. Alle 47.000(!) bestellingen werden geannuleerd, en bij de rechter kreeg de meubelwinkel gelijk.

Eigenlijk al die zaken hadden gemeen dat het prijsverschil wel héél erg laag was. Dat lijkt hier anders te liggen: Coolblue heeft vermoedelijk de ex-btw prijs als in-btw opgevoerd. En bij een nieuwe MacBook is zo’n 20% korting misschien niet zo heel gek.

Hoewel? Apple staat niet bekend om frequentie aanbiedingen, en ook voor de volle mep gaan de designlaptops vlot de deur uit. Bovendien, en dat vind ik belangrijker, stond er op die productpagina helemaal niets dat de indruk kon wekken dat hier een speciale aanbieding op zat. Gezien die situatie denk ik dat je moet navragen, al geef ik toe dat dat ’s nachts bij Coolblue niet eenvoudig is.

(Dat de webshop de bestelling aanneemt en mogelijk zelfs uitlevert, is volstrekt irrelevant. Dit zijn volledig geautomatiseerde processen en dat weet iedereen.)

Wat mij dan nog bezighoudt: vaak zie je dat een link naar zo’n prijsfout wordt gedeeld op forums of socials, en dat iedereen dan snel gaat bestellen zelfs als in de comments wordt gewezen op de waarschijnlijke fout. Ik vraag me af of dat gegeven mee moet wegen in de vraag of je te goeder trouw bent?

Arnoud

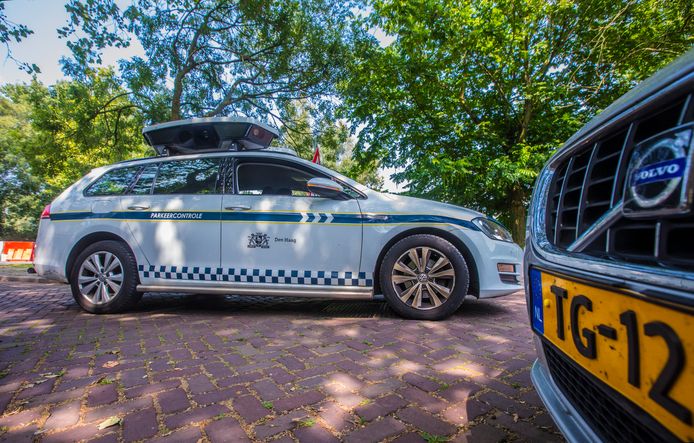
AP: inzet scanauto’s levert jaarlijks 500.000 onterechte parkeerboetes op

Foto: scancar Computer Vision Dataset

De inzet van scanauto’s om foutparkeerders op te sporen, levert jaarlijks 500.000 onterechte parkeerboetes op, las ik bij Tweakers. Een themastudie van de Autoriteit Persoonsgegevens laat zien dat zeker 10% van de vaak automatisch gegeven naheffingen parkeerbelasting niet juridisch correct wordt opgelegd.

De kern van het probleem is vrij simpel:

Een scanauto maakt alleen een momentopname en ziet de omstandigheden niet. Daardoor kan een scanauto bijvoorbeeld niet vaststellen dat iemand aan het laden en lossen is. In zo’n situatie kan een uitzondering gelden en mag iemand geen boete krijgen. Ook de gehandicaptenkaart, die niet standaard op kenteken is geregistreerd en achter de voorruit wordt geplaatst, ‘ziet’ de scanauto niet. Is er niet betaald, dan zijn de systemen onverbiddelijk en volgt automatisch een boete.
En natuurlijk, je kunt altijd in bezwaar. Maar dat kost tijd en moeite die niet iedereen kan opbrengen. Bovendien krijg je de naheffing pas weken nadien, zodat bewijs verzamelen een lastige klus kan worden. Het helpt ook niet mee dat veel communicatie digitaal gaat naar een kanaal waar niet iedereen kijkt.

Los daarvan: het hóórt niet, een systeem dat 10% van de tijd onterecht burgers geld laat betalen.

Menselijk toezicht lijkt er wel te zijn bij de onderzochte gemeentes. Dat kan op drie manieren:

  1. Op afstand, waarbij een mens de foto bekijkt en besluit of een naheffing op zijn plaats is.
  2. Hybride, waarbij de mens uit 1 bij twijfel een handhaver langsstuurt.
  3. Fysiek, waarbij de handhaver ter plaatse de enige route is om tot een naheffing te komen.
De AP wijst op het probleem van automation bias, het te makkelijk vertrouwen op wat de computer zegt. Die auto staat daar, het NPR zegt dat er geen belasting is betaald, de klep staat niet open – die is niet aan het laden en lossen. Dat bijvoorbeeld het kenteken fout gescand kan zijn, komt dan niet bij de mens op.

Soms is het nog ingewikkelder. In 2024 verscheen het bericht dat een man uit Rotterdam al twee jaar lang ten onrechte parkeerboetes krijgt van de gemeente Breda. Dat komt door een schroefje op een kentekenplaat van een auto in de Brabantse stad, waardoor dat kenteken gelezen wordt als dat van de Rotterdammer. Dit blijkt technisch niet op te lossen.

Arnoud


Mag mijn werkgever verlangen dat ik in mijn uitwerkperiode een AI train mijn werk te doen?

Photo by Google DeepMind on Pexels

Via Reddit:

Mijn werkgever wil mijn contract niet verlengen, maar verwacht wel dat ik nu in mijn laatste maand een AI ga trainen om mijn werk over te nemen. Als het een persoon was geweest had ik er minder moeite mee gehad, maar omdat het een AI model is ben ik hier zwaar op tegen. [Het] gaat hier enkel om data invoer en output corrigeren. Hierbij moet ik ook video’s opnemen over het gehele werkproces.
Het woord ’trainen’ is hier meer bedoeld in de zin van fine-tuning, oftewel het bijschaven van de capaciteiten op basis van gerichte correcties en data. Het gaat dus niet om het africhten van een taalmodel als zodanig maar om te zorgen dat het model beter om kan gaan met wat het bedrijf wil doen.

Algemeen is het inwerken van een collega iets dat je als goed werknemer doet in je uitwerkperiode tussen ontslag en laatste werkdag. Ook het maken van overdrachtdocumentatie – uiteraard binnen het redelijke – is gewoon iets dat je zult moeten doen.

Het lastige is, echt harde normen zijn er hier niet. En al helemaal niet natuurlijk over het moeten produceren van AI-trainingsdata.

We moeten dus terug naar de gewone regels. Is het deel van je werk om een AI te voeden of te corrigeren? Weinig mensen zullen dat in hun taakomschrijving hebben staan. Maar naast wat er letterlijk is opgegeven, moet je ook doen wat daar normaal gesproken bij hoort.

De vraag wordt dan dus, kun je van een werknemer verlangen dat deze een AI gaat trainen/afstellen om het werk van die werknemer (gedeeltelijk) te automatiseren. Ik denk van wel: het in gebruik nemen van nieuwe tools is iets dat van iedere werknemers verlangd kan worden. Of dat nou een elektrische zaag is voor de timmerman, een rfid-scanner voor de orderpicker of een AI-tool voor de bureauwerker. Die tool hoort bij het werk, dus afstellen daarvan ook.

Het komt natuurlijk wel heel cru over; niet alleen wordt je contract niet verlengd, maar je werk is kennelijk ook nog eens door een taalmodel uit te voeren. En dat gevoel bij iedere uitvoerregel die je moet corrigeren.

Arnoud

Rechter trekt streep door Italiaanse Netflix-prijsverhogingen sinds 2017

Photo by Souvik Banerjee on Unsplash

Een Italiaanse rechtbank heeft prijsverhogingen van de Italiaanse Netflix-tak als onrechtmatig verklaard. Dat meldde Tweakers onlangs. Alle verhogingen moeten worden terugbetaald, wat kan oplopen tot 500 euro voor premiumabonnees. De grondslag is de aloude Europese richtlijn consumentenbescherming.

Netflix heeft – zoals vrijwel iedere softwaredienst – een vrij algemene bepaling in de voorwaarden dat zij periodiek de prijzen mag herzien. Dat is dan verbonden aan een opzegmogelijkheid en daar lijken veel mensen vrede mee te hebben. Het voelt ook redelijk: uiteraard worden dingen periodiek duurder, maar als je het te duur vindt dan kun je er vanaf.

Al sinds 1993 hebben we de Richtlijn oneerlijke bedingen in het Europees recht. Deze is in Nederland terug te vinden in Boek 6 bij de regels over algemene voorwaarden. Maar haar zogeheten blauwe lijst voor algemene voorwaarden bevat net wat andere leuke dingen, zoals afkoopsommen en boetes bij consumentencontracten.

Voor wijzigingsbedingen staat er in de bijlage van die richtlijn dat specifiek als oneerlijk te zien is, een beding dat

j) de verkoper [machtigt] zonder geldige, in de overeenkomst vermelde reden eenzijdig de voorwaarden van de overeenkomst te wijzigen;
Een prijswijziging geldt hierbij als voorwaardewijziging. Onderaan staat dan weer wel dat dit niet zomaar geldt als het gaat om een overeenkomst voor onbepaalde tijd en je de consument een redelijke tijd van te voren waarschuwt en een opzegrecht geeft.

Het Italiaanse vonnis legt uit dat in de Italiaanse wet die laatste toevoeging niet is overgenomen. Naar de letter van het Italiaanse consumentenrecht moet dus bij zo’n algemeen wijziginsbeding altijd gewezen worden naar een reden in het contract. Dat kan inflatiecorrectie zijn of een verhoging vanwege gestegen kosten, maar hij moet er staan – en opgaan natuurlijk. (De huidige Netflix-voorwaarden noemen “het aanbod is fors gestegen” als een ander voorbeeld.)

Omdat de Netflix-voorwaarden überhaupt geen redenen noemen, is het prijsverhogingsbeding in strijd met het consumentenrecht. De rechter vernietigt het dan ook, zodat er nooit een grondslag was om de prijsverhogingen te incasseren. Dat is waarom die bedragen nu teruggegeven moeten worden.

Netflix gaat in beroep, en ik zie wel kansen voor het bedrijf. De rechter moet namelijk zo’n Italiaanse wet richtlijnconform uitleggen, en mag dus niet volstaan met “die opmerking onderaan is niet overgenomen dus geldt niet”. Bij het interpreteren van het Italiaanse artikel moet die tekst zeg maar worden meegelezen.

Verder is er ECJ-jurisprudentie dat de bijlage indicatief is. Iets is niet automatisch verboden omdat het in de bijlage staat, zoals bij onze zwarte lijst van algemene voorwaarden. Het is een aanwijzing, maar de rechter moet vanaf daar nog steeds onderzoeken of het écht oneerlijk is, wat er staat. En specifiek bij videostreamingdiensten zie ik dan wel argumenten dat dit niet zo is.

Arnoud


Mag mijn collega sollicitanten door AI screenen omdat we daar nog geen beleid over hebben?

Yutong Liu & Kingston School of Art / Better Images of AI (CC-BY 4.0)

Een lezer vroeg me:

In ons bedrijf is er geen duidelijk beleid over het gebruik van AI. Initiatieven om de efficiëntie te vergroten worden echter wel aangemoedigd, en in het kader daarvan gebruikt een van mijn collega’s nu bij voorkeur AI om sollicitanten te screenen. Ik ben daar persoonlijk geen voorstander van omdat ik niet weet wat er van die informatie uit de sollicitaties dan bij de AI blijft hangen. Hij claimt dat dit een standaardprocedure is en dat sollicitanten weten dat ze dit tegenwoordig kunnen verwachten en dat we niet in een ‘gevoelige’ sector werken (retail). Hoe zit dit juridisch gezien?
Deze vraag is een schoolvoorbeeld van het al langer bestaande concept van ‘shadow IT’, persoonlijke initiatieven om IT-diensten of apps in te zetten voor het werk buiten de officiële kanalen om. Een leuke manier om nieuwe dingen te ontdekken (die best positief voor efficiëntie of omzet kunnen uitpakken) maar ook een manier om keihard tegen deuren aan te lopen.

In dit geval is dat de AI Act, omdat het met AI screenen of beoordelen van sollicitanten hoogrisico is onder die wet. Dat mensen dat zouden moeten weten of dat iedereen dat doet, is daarbij niet relevant. Je krijgt een berg complianceverplichtingen op je dak als organisatie, en je kunt beboet worden als je die niet naleeft. Waar is je bias evaluatie? Welk kwaliteitsbeheersysteem heb je ingericht om te borgen dat prestaties op niveau blijven? Welke vorm van uitleg geef je sollicitanten over de AI-beoordeling?

Uiteraard is er ook nog de AVG, die evenzo wat te zeggen heeft over persoonsgegevens van sollicitanten in third-party tools stoppen zonder op zijn minst een verwerkersovereenkomst met geheimhoudingsbeding. Daarnaast zegt de NVP Sollicitatiecode sinds 2025 dat je duidelijk moet zijn naar de sollicitant toe over AI-gebruik, en dat je tool voldoet aan de AI Act.

Het belangrijkste voor mij is echter dat je als organisatie de consequenties krijgt als een medewerker op die manier eigenzinnig opereert. Daar helpt dan geen “het is maar een individuele keuze” of “de impact op mensen valt mee”. Ik snap de keuze voor zo’n initiatieven-beleid, maar dat moet wel verbonden worden aan begeleiding en controle.

Arnoud