Ho stop, datakluizen gaan niets doen aan Facebook en consorten

Geef gebruikers controle over hun persoonlijke data, om daarmee de te grote macht van grote technologiebedrijven terug te dringen, las ik in NRC voor mijn vakantie. Het huidige model van omgaan met data is niet geschikt om de techbedrijven te bedwingen, zo betoogt daar professor Ruben Verborgh. Zijn betoog lijkt vooral te gaan over het gebrek aan dataportabiliteit: je kunt data niet meenemen, alles zit opgesloten bij Facebook en dáárdoor zijn ze zo machtig. Want daardoor ga je niet weg, en concurrenten kunnen niets opzetten want er komt niemand. Leuk en ik zie het punt, maar dat is niet het probleem.

En wat al helemaal niet het punt is, is de oplossing om data in een decentrale persoonlijke kluis te zetten. Die metafoor heb ik vaker voorbij zien komen. Het idee is altijd dat als je de data maar ergens anders opslaat, er dan meer grip op komt. Ongeacht het probleem is de oplossing een database, zoals dat in IT-land heet. Maar daar gáát het niet om.

Het punt van die macht van Facebook is natuurlijk dat iedereen daar zit omdat iedereen daar zit. En dat ze je privacy eenvoudig kunnen schenden omdat je daar niet mee bezig bent. Dat los je niet op met een extra database waar dan je privacygevoelige gegevens in zitten. Praktisch gezien vraagt Facebook dan gewoon “mag ik even in je kluis” en dan klik je op ja, waarna dezelfde situatie ontstaat. Ik zie dat echt niet.

Helemaal jeuk krijg ik dan (ik weet het, ik krijg overal jeuk van maar het is dit of hoofdpijn) van het idee dat je dan als consument geld zou kunnen vragen voor toegang tot je kluis. Persoonsgegevens zijn geen eigendom, dat is een heel slecht idee. Het gaat om je fundamentele rechten, niet om stukjes arbeid of producten die anderen best mogen hebben tegen betaling.

Dit nog los van het punt dat het in de meeste gevallen niet eens gáát om het soort data dat je in een kluis stopt. Dan moet je immers denken aan dingen als je NAW gegevens, kopie identiteitsbewijs, schoolresultaten; algemeen gezegd, dossierstukken. Maar wat Facebook wil weten is of jij die video leuk vindt. Dat artikel leest. Wel eens vaker op sites voor onzekere mannen komt. Iets vindt van Black Lives Matter. Dát geeft ze inzicht in jouw interesses en daarmee inzicht in waar op te adverteren. En dat is haast per definitie informatie die een Facebook zelf verzamelt, niet iets dat in jouw digitale kluis gaat.

Arnoud

Techgiganten beloven banden met leveranciers te verbreken bij dwangarbeid, een wassen neus?

Techbedrijven Apple, Facebook, Amazon en Google hebben tegen het Amerikaanse Congres beloofd om de banden met bedrijven te verbreken als die gebruik maken van dwangarbeid. Dat las ik voor mijn vakantie bij Tweakers. Klinkt leuk, maar omdat er niet echt definities zijn van “dwangarbeid” (is een Foxconn-werknemer gedwongen, gezien je aldaar vrijwel zeker dood gaat van de honger als je ontslag neemt) zie ik dan diverse reacties dat het een wassen neus zou zijn. Net zoals het een wassen neus is (reactie 1) om geen conflictedelmetaal meer te gebruiken. Nou nee, niet helemaal.

Natuurlijk staat het wat goedkoop, om die reactie te geven bij een hoorzitting. Welk redelijk mens is er immers vóór dwangarbeid? Maar zolang je het laat bij mooie opmerkingen, gebeurt er natuurlijk weinig.

De normale vervolgroute is dan ook dat er wetgeving komt, of dat je die mooie opmerkingen vertaalt in een plan van aanpak en dat ook werkelijk gaat uitvoeren, met prikkels voor jezelf dat het ook echt gebeurt. Een mooi (Nederlands) voorbeeld is Fairphone, dat een eerlijke en duurzame smartphone wil maken en dus ook de supply chain begon te zekeren. Of Tony’s chocoloney. Je ziet bij beiden dat het initiële idee afgezwakt moest worden, dat is logisch gezien de enórme klus, maar het is een begin.

Wetgeving geloof ik niet echt meer in voor dit soort dingen, je hebt te veel overheden nodig met te veel tegenstrijdige belangen. Waar ik wel steeds meer in zie, is “everything is securities fraud“. Oftewel, als het bedrijf niet doet wat het belooft, dan hebben ze de aandeelhouders niet goed geïnformeerd en die kunnen dan gigaclaims indienen. Niet perse toezeggingen over geld, ook als je bijvoorbeeld zegt dat een documentaire over je bedrijf geen probleem is, dan is er een claim te maken. Of als je diversiteit belooft in de directiekamer en die komt er niet. Of als je zegt tegen racisme te zijn en adverteert op rechtsextremistische sites (ook al gaat dat via dertig brokers).

De grap is natuurlijk dat een claim wegens een dergelijke fraude veel makkelijker is dan een overheidsonderzoek of zelfs een civiele rechtszaak voor het schenden van die belofte. Want als ik een mooi statement publiceer dat ik heel divers wens te zijn, en heel mijn raad van bestuur is wit, wie kan er dan een claim wegens onrechtmatige daad bij me starten? Eigenlijk niemand. Maar aandeelhouders kunnen zeggen, ik investeerde mede vanwege dat statement en dat blijkt nu een leugen, kan ik even vangen.

Dus ja, claims van aandeelhouders, dat is iets waar dit soort bedrijven wél gevoelig voor is. Ook short sellers vinden dit heel leuk, want met zo’n gigaclaim trek je de koers omlaag en dat is dus winst voor hen. Vraag eens aan Musk hoe lief short sellers zijn.

Arnoud

De lawyerbot van de toekomst wijzigt gewoon zelf je documenten even #ndalynnweek

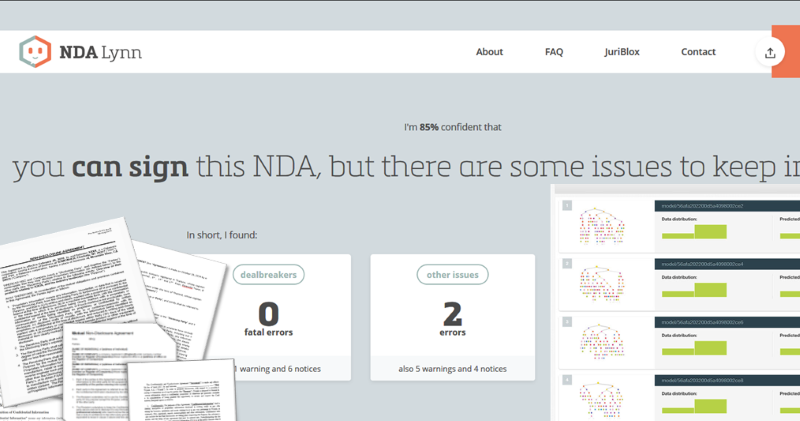
Artificial Intelligence is wat een computer bijna kan, las ik ooit als definitie van die term. Want op het moment dat de computer het kan, is het gewoon een ding dat een computer kan. Er is maar een korte periode waarin een computer iets kan laten zien dat we nog echt nieuw vinden. Ik heb het gevoel dat we daar nu zitten met documentanalysetools zoals NDA Lynn: de tools bestaan, en ze kunnen dingen, maar we vinden het nog wel een beetje eng. Ik ben benieuwd of Edit Mode mensen over de streep trekt. Helemaal omdat het stiekem eigenlijk niet zo ingewikkeld is.

Ik heb gemerkt dat mensen enthousiast worden over nieuwe features of werkwijzen als je ze een catchy naam geeft, vandaar dat ik dit aspect Edit Mode heb genoemd (enige associatie met vim(1) is geheel toeval). Maar het is wel een forse andere manier van werken. In plaats van een rapport met bevindingen krijg je nu in je document bevindingen terug. In de vorm van commentaar in de marge, en in de vorm van een aangepaste clausule.

Dit heeft nogal wat voeten in de aarde, maar vooral in wat er allemaal omheen moet gebeuren. Ik rijd voor mijn werk dagelijks langs een grote bouwplaats. Daar gebeurt altijd weken niets, en dan zit er ineens een verdieping bovenop het gebouw. En laatst was ik er een week niet en toen bleken die betonnen platen te zijn bekleed, gestoffeerd en behangen. Morgen eerste bewoners. Nou, al dat werk aan die betonplaten en fundering dat is nu dus ongeveer gedaan.

In de oude versie werd alle tekst gewoon geëxtraheerd uit het brondocument. Daar zijn libraries te over voor. Die tekst werd dan geclassificeerd (“dit is security, dit gaat over overmacht, dit is een partijdefinitie”, etcetera etcetera) en daarna van een smaakje (streng, eenzijdig, breed, etc) voorzien. Dan nog even opzoeken wat dat betekent (“oké, eenzijdige partijdefinitie willen we niet”) en de uitvoer op je scherm. Duidelijk. Maar nu willen we dus terug het document in, en bij de zin over security een commentaartje hangen “Deze is te streng, dit willen we niet”). En dat was er dus niet, informatie om mee terug het document in te gaan.

Nu dus wel. We nemen dus het commentaar op de clausule en stoppen dat in een comment die in de marge verschijnt:

Ziet er gaaf uit, nietwaar? En ergens ook wel, eh, AI achtig, dat een robot gewoon doet wat een mens voorheen deed met zo’n tekst. De huidige teksten zijn nog geschreven als beschouwende analyse, maar je kunt ze ook net wat pittiger schrijven als pushback naar de opsteller van het document. En dan kun je daar nog een beetje GPT-3-achtige tekstvariaties bij laten maken en dan krijg je duidelijk een robot aan het woord.

Er zit nog een lastig aspect aan. We extraheerden dus die individuele zinnen, om daarmee vervolgens clausules te maken en die van commentaar te voorzien. Maar dan moet je dus terug in het document en dan kun je alleen de commentaren aan de individuele zinnen hangen. Dat gaat dan mis als twee zinnen uit dezelfde categorie na elkaar volgen. Dan krijg je twee keer hetzelfde commentaar achter elkaar. En “op elkaar volgen” is niet zo eenvoudig te herkennen. Word stopt er soms een héle trits codes tussen, waardoor het voor software lijkt of de twee zinnen drie kilometer uit elkaar staan.

De volgende stap: het document wijzigen. Oftewel, je hebt gezien dat een clausule onacceptabel is en je wilt er wat acceptabels van maken. Hoe pak je dat aan?

Als mens ga je dan op basis van ervaring zelf wat aanpassen. Hier een stukje redelijkheid, daar een “voor zover haalbaar zonder kosten” en zo nog wat braaftaal om al te strenge clausules rustig te krijgen. Of juist omgekeerd, je schrapt “inspanning” en je maakt er “garandeert” van, je voegt wat specifieke eisen toe en maakt het zo het gewenste niveau van strengheid. Automatiseer dat maar eens.

Die bedrijfsjuristen van gisteren hadden een nog iets ander idee: laat ons zelf clausules erin zetten, en schrap dan de onacceptabele clausule zodat ‘onze’ clausule erin geplakt gaat worden. Dát gaat hem niet worden. Dan moet je gewoon je eigen NDA opsturen als tegenvoorstel. Maar onderhandelingstechnisch staat het héél raar als je zegt “deze tekst kan niet, ik heb alles geschrapt en mijn tekst erin geplakt”. Daar kom je gewoon niet mee weg.

Nee, het moet met hier een stukje erbij en daar een stukje eraf. Gelukkig zijn er tools die dergelijke aanpassingen gewoon kunnen uitrekenen: gegeven brontekst A en doeltekst B, wat moet er in A bij of af om tot B te komen? Mijn probleem is dus alleen hoe je aan de juiste doelteksten B komt.

Dat is makkelijker dan je denkt, want ik had dus een hele bak met clausules die ook nog eens in verschillende smaakjes ingedeeld is. Dat is immers de dataset waarmee ik Lynn heb gevoed. Als ik nu uit elk smaakje een selectie maak, tien clausules van de brede soort, tien van de beperkte soort en tien van de standaard/gemiddelde soort, dan zijn we er. Kijk welke soort acceptabel is voor deze klant (bijvoorbeeld de brede smaak), pak een van die tien clausules van die smaak en pas de NDA aan zodat de onacceptabele clausule (bijvoorbeeld een beperkte) verandert in die ene van brede smaak.

Dan krijg je dus dit. En ja, dit is een redline gemaakt door NDA Lynn:

De originele tekst was een hele brede: alle informatie was geheim, ongeacht hoe deze was vastgelegd. Maar dat was niet acceptabel: het moest beperkt worden: alleen informatie waar “geheim” op staat valt onder de NDA. De aanpassing zorgt daarvoor, door een clausule uit de beperkte categorie te pakken en als een redline door te voeren.

Blijft nog over de business logic die erbij hoort. Want je kunt wel alles aanpassen, maar juist bij een NDA wil je niet op elke zin commentaar geven. Zowel jij als je wederpartij willen snel tekenen zodat je door kunt met je zakelijk gesprek. Vaak zie je dus dat je alleen van de échte problemen een punt maakt, zoals de hierboven getoonde definitie van vertrouwelijkheid. Maar dat jij een net wat mooiere manier hebt om te zeggen dat de rechtbank Amsterdam bevoegd is, dat laat je gewoon zitten. Dat kost alleen maar tijd.

Tegelijkertijd is dit wel een zakelijke feature en moet je een jurist overtuigen dat zhij dit wil. Dus dan kies je voor de tijdgeteste traditie van de afdeling Sales en maak je er een configuratie-optie van. Wat wil je voor dealbreakers; een edit of alleen een comment? En voor essentials? Het meest logisch – en dus de default – wordt dat dealbreakers een edit geven en essentials een comment.

En dan zijn we er eindelijk: jij uploadt je NDA met de vraag, ik ga informatie krijgen en kan ik deze tekenen? NDA Lynn zegt ja of nee, en zo nee dan krijg je de aanpassingen die naar je wederpartij kunnen. Ondertussen kan ik lekker écht werk doen. Dat is waar legal tech over gaat.

(Dit was deel vijf van vijf vakantieberichten.)

Arnoud

Met een lawyerbot de markt op, of hoe je juristen overtuigt je dienst af te nemen #ndalynnweek

Mijn grootste fout bij de lancering van NDA Lynn was dat ik mezelf erbij verkocht. Iets preciezer: als je de bevindingen van Lynn te lezen kreeg, stond er bij dat je voor 99 euro een human review kon kopen. Hartstikke stom natuurlijk – Lynn klopt gewoon, waarom zou je nog een mens nodig hebben. (En het hele punt was nou net dat ik geen NDA’s meer hoefde te lezen. Maar dat terzijde.) Maar belangrijker, ik had vanaf het begin een custom omgeving moeten bieden. Mensen zelf laten aanpassen wat de uitvoer moet zijn. Want dan had je pas écht de kracht van AI voor juridische diensten kunnen bepalen.

Helaas duurde het even voordat we de Business Edition, zoals het is gaan heten, echt op de markt konden brengen. Je krijgt je eigen omgeving, waar je achtergrond, kleuren en teksten kunt aanpassen (en eigen URL, zij het als jouwnaamhier.ndalynn.com want dat was even het snelste). Je kunt oude gescreende NDA’s opvragen – wat nog een hele mooie bleek, want als er iets is dat in organisaties ontbreekt dan is het wel een index van de NDA’s die in je organisatie zijn getekend. Hartstikke leuk die contractmanagementsystemen maar NDA’s stopt niemand daarin.

Verder hadden we nog een mailinterface ingebouwd (forward je mail naar een speciaal adres en krijg de bevindingen teruggemaild) en een API koppeling gebouwd voor integratie van Lynn in andere diensten. Ik had mooie dromen om Lynn bijvoorbeeld aan Slack te koppelen: stuur haar een privébericht en ze reageert binnen een paar minuten in de chat met of je kunt tekenen of niet. Of nog leuker, een Outlook plugin of een koppeling met Salesforce. Stel je voor, je krijgt een mail met een NDA en in de sidebar staat meteen een bericht “deze kun je tekenen, no problem”. Maar ik had geen idéé hoe duur dat allemaal wel niet was.

De kern van de dienst is natuurlijk dat je zelf bepaalt welke NDA’s je accepteert. Je kunt dan ook alle dealbreakers, essentials en boilerplate zelf verschuiven, en bepalen wat er moet gebeuren bij welke uitkomst. Dus als jij vindt dat een NDA gerust 10 jaar van kracht mag zijn, dan zet je dat zo in je systeem en dan zal Lynn er nooit meer over vallen. Wil jij perse Zwitsers recht, dan zal Lynn er een punt van maken als er Duits staat. En je mag dan kiezen of dat punt een dealbreaker is of gewoon iets vervelends.

Daaraan gekoppeld zit een simpele workflow: als het resultaat iets anders is dan “je kunt tekenen” dan wordt de NDA met bevindingen doorgestuurd naar de bedrijfsjurist of advocaat die je zelf invult. Zo komen alle NDA verzoeken centraal binnen, is het idee, tenzij er helemaal niets mis is met het document. En je krijgt meteen de briefing met de problemen erbij, zodat je kunt bepalen of het alsnog goed is of je er echt inhoudelijk naar wilt kijken.

Tevens is er beperkt gebruikersbeheer: je moet inloggen via de webinterface om een NDA te kunnen uploaden. In de praktijk gebruiken mensen liever de mailinterface, want dat kun je vanuit je mailprogramma doen en je krijgt een reply die met één klik leidt naar de volledige resultaatpagina. De API gebruikt eigenlijk niemand.

Ik begin met de Business Edition bij bevriende advocaten aan te bieden. Die reageren geïnteresseerd maar ook sceptisch: wat als die bot een foutje maakt, wie is er dan aansprakelijk? Geen rare gedachte, zeker voor een advocaat die uiteindelijk ook tuchtrechtelijk voor slordigheden kan worden aangesproken. Maar het levert weinig business op.

Meer succes heb ik dan ook bij bedrijven met één overwerkte bedrijfsjurist. Die kan veel tijd vermijden met deze oplossing. Opvallend genoeg krijg ik vooral aanvragen uit Zuid-Amerika en Azië. De reden? Allereerst dat Lynn een stuk goedkoper is dan de alternatieven, en daarnaast dat ik ook Spaanstalige datasets heb toegevoegd. (Die maakte ik met Bing Translate, net als de Nederlandse en de Duitse. Dat werkt prima, iedereen gebruikt dezelfde terminologie en clausules.)

En nou ja, het werkt. Het wordt afgenomen, ook door bedrijfsadviseurs en anderen die het “erbij” verkopen aan hun klanten weer. Maar heel hard gaat het niet. Ik doe een snelle enquête en het antwoord is duidelijk: je moet documenten aanpassen, niet alleen maar adviseren. Nu moet je nog alles doorlezen om te zien wáár dan die te strenge regels staan of die vijf jaar die twee moet zijn.

Dat werd Edit Mode en daar zitten we nu hard aan te werken.

(Dit is de vierde van vijf vakantieberichten.)

Arnoud

Van idee naar ontwerp, of hoe moet een lawyerbot nu werken? #ndalynnweek

Goed, ik had dus een dataset en daarmee kon ik redelijke voorspellingen doen ook. Tijd dus om het héle ontwerp van Lynn eens te maken. Dan is gelijk de eerste vraag: wat moet Lynn dan precies doen? Nou ja, mij werk uit handen nemen. Ik wil niet meer lastig gevallen worden met “kan ik deze NDA tekenen”. Het doel van Lynn was dus: wees een site die zegt of je die NDA kunt tekenen. Document uploaden, geen gezeur, ja je kunt tekenen.

Ik had zo’n systeem nog niet eerder gezien. Bestaande systemen ondersteunen advocaten in hun praktijk. Het grote voordeel is dan dat ze sneller lezen en altijd even accuraat. Je krijgt dan een document met geel gemarkeerde secties waar iets raar mee is, en je weet dat de rest dan dus standaard is. (Het is ergens heel raar dat bedrijven elkaar doodgooien met teksten waarvan een robot al zegt, dit is standaard lekker laten gaan, maar dat is een andere discussie.) Maar je moet het zelf nog steeds lezen en uiteindelijk je conclusie trekken.

Zo’n advies, gewoon ja of nee zeggen. Hoe moet dat eruit zien. Uit mijn praktijk weet ik dat mensen vaak alleen vragen of er dealbreakers in staan. Grote dingen die heel pijnlijk zijn. Een hele lange termijn. Een boetebeding. Exclusiviteit of een concurrentieverbod. Dat werk. Als je die ziet, dan mag er niet getekend worden.

Dan zijn er nog andere dingen die best vervelend kunnen zijn maar niet perse een dealbreaker. Ja, jij zit in Nederland en men wil Taiwanees recht, dat is niet handig maar even serieus, gaat er echt een rechtszaak komen hiervan? Dat wil je dus wel wéten maar om de NDA daar nu meteen op af te keuren is ook zo wat. Ik noem dit de essentials.

En dan heb je nog de boilerplate, de volkomen standaard tekst die iedereen van elkaar overneemt maar werkelijk niets relevants bevat. Dat de kopjes informatief zijn. Dat de partijen verklaren te mogen tekenen. Dat dit de gehele overeenkomst is. Dat herkent Lynn echt vrijwel perfect (wat niet raar is, in veel gevallen zou een pure string vergelijking minstens zo goed werken) maar niemand wil het weten. Dat moet dus zéér terughoudend terugkomen in de uitvoer.

Met deze opzet komt het erop neer dat Lynn dus allereerst kijkt of er dealbreakers in het document staan. Zo ja, dan is het advies om niet te tekenen. Zijn er essentials met problemen, dan mag je tekenen mits je daar even naar kijkt. (Maar zijn het er te veel, wat ik maar even arbitrair definieer als 30% van de essentials) dan mag je alsnog niet tekenen. En de boilerplate die is er maar dat betekent verder niets. Niemand gaat een NDA weigeren omdat er niets staat over hoe informatief de kopjes zijn.

Bij bovenstaande zit wel nog een impliciete aanname, namelijk aan welke kant van de tafel je zit. In het jargon van de NDA-jurist (ja, die bestaat) heb je zogeheten give, get en mutual NDA’s. Een give NDA is geschreven voor de partij die informatie geeft, en is dus heel streng in zijn voordeel. Een get NDA is er juist voor de ontvangende partij, en de mutual NDA probeert beiden even hard te beschermen. (Protip: vraag altijd de mutual NDA, dat scheelt héél veel onderhandelen.)

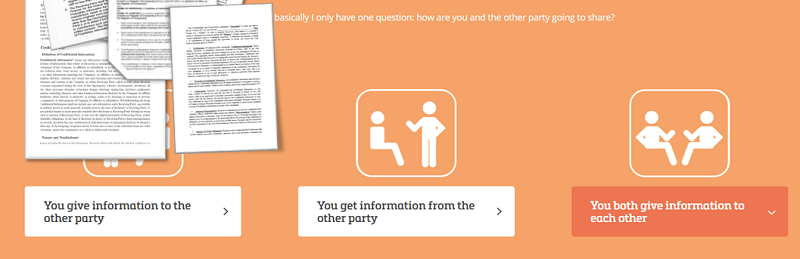
Je moet dus weten welke van de drie situaties je te maken hebt. Dat is dan ook de vraag (en de enige vraag) die NDA Lynn je stelt. Ga je geven, ontvangen of samen delen? Ik vraag nog meer, maar dat is optioneel en vooral voor de statistieken. Eigenlijk alleen de vraag “in welk land zit u” komt terug in het antwoord: als dat niet hetzelfde is als de rechts- en forumkeuze dan krijg je daar een waarschuwing over.

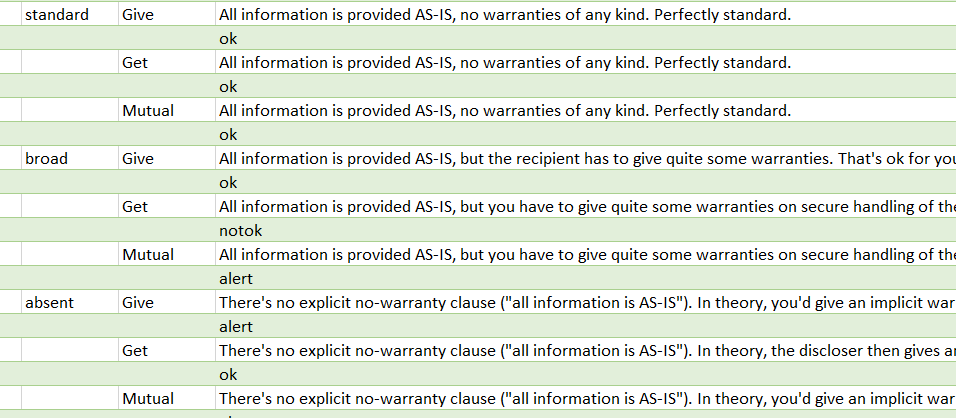
Blijft over: wat ga je zeggen. Daarvoor schrijf ik een uitvoertabel, die per clausule per smaak per situatie aangeeft wat het antwoord moet zijn. Hierboven zie je een klein stukje daarvan: dit is de uitvoer voor de categorie “warranties” oftewel garanties. Wat moet je zeggen als deze standaard of juist breed gevraagd worden, of als er geen garanties in staan. Je ziet dat het antwoord net anders is als je in de give dan wel in de get of mutual situatie zit.

En dan zijn we er. Document tekst extraheren, met een ML model de zinnen classificeren, de zinnen bij elkaar rapen, van de clausules het juiste smaakje bepalen, in de uitvoertabel opzoeken welke uitvoer je moet geven en klaar is Kees. Of Lynn dan.

We testen, en komen de nodige probleempjes tegen. Zo voegen we taaldetectie toe (“Sorry, Portugese NDA’s worden niet ondersteund”), is het extraheren van tekst uit PDF net wat ingewikkelder en staat er soms gewoon rommel in een document. Maar dat is allemaal op te lossen. Tijd om de markt op te gaan.

(Dit is de derde van vijf vakantieberichten.)

Arnoud

Van bak met data naar een werkende lawyerbot #ndalynnweek

Weet je wat het idiootste is aan AI? Dat iedereen het maar over algoritmes heeft en hoe spannend of bedrijfsgeheim die zijn. Het labelen van je data, dát is waar de kwaliteit van je systeem mee staat of valt. Ik vind het dan ook erg raar dat je overal leest dat men een blik studenten opentrekt of via diensten als Mechanical Turk willekeurige mensen labels laat zetten. Of dat wij via reCaptcha en dergelijke diensten zeggen waar zebrapaden lopen of verkeerslichten te zien zijn. Data is de kern van je dienst, dus hoezo besteed je dat uit en pronk je vervolgens met je unieke algoritmes die uiteindelijk niet ter zake doen?

Natuurlijk, studenten inzetten is goedkoop maar waar vind je de rechtenstudent die in honderd NDA’s zinnen kan herkennen als zijnde overmacht, verlenging, aansprakelijkheid met boete enzovoorts? In een rechtenopleiding krijg je welgeteld nul contracten te lezen (ja, serieus) laat staan een specifiek document als een NDA.

Dus nee, er zit niets anders op dan het zelf te doen. Gelukkig vind ik het perfecte moment om dit te doen: mijn dochter van een paar maanden oud slaapt ’s nachts beter als ik in de kamer zit, dus ik leg mijn laptop klaar en ga labelen tot ze slaapt. Zo kom ik in een paar maanden tot een volgens mij keurig gelabelde dataset. Een paar steekproeven op de resultaten laat zien dat ik redelijk consistent label, ook al heb ik geen formele criteria opgesteld om clausules te categoriseren.

Dat is ergens ook wel een beetje de makke van zo’n systeem. Er zijn geen echte categorieën waar je op terug kunt vallen, je moet zelf maar iets bedenken. Zowel het soort clausule (is een vrijwaring een vorm van aansprakelijkheid of iets heel anders) als de smaakjes daarbinnen (is een ton aansprakelijkheid erger dan een boete van 10k per gelekt geheim). Dus ik doe maar wat. Bij elke zin bedenk ik een categorie, en na driehonderd zinnen ga ik categorieën samenvoegen en splitsen.

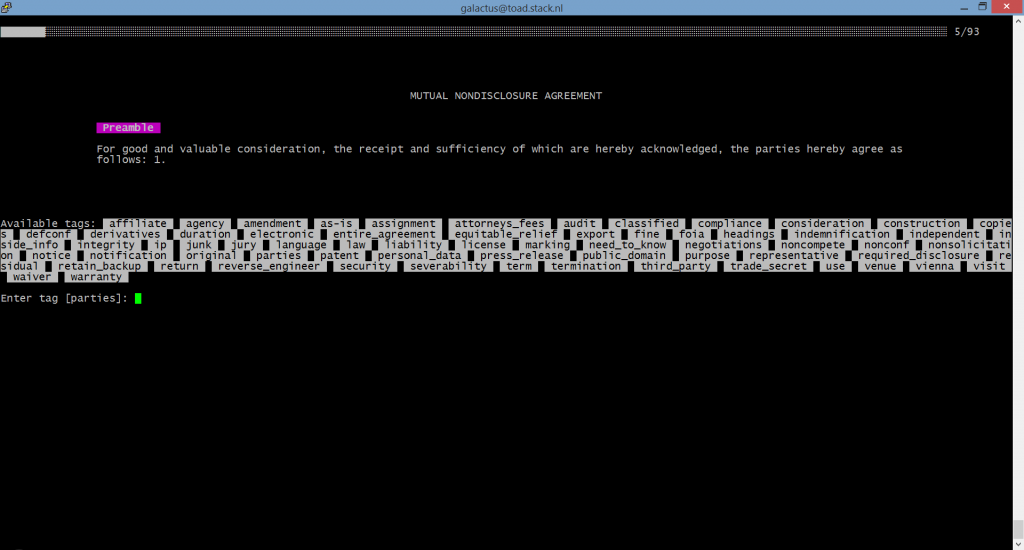
Hier, de tagger waarmee ik al die tijd heb gewerkt om zinnen van labeltjes te voorzien. Je ziet hoe het aantal categorieën is geëxplodeerd:

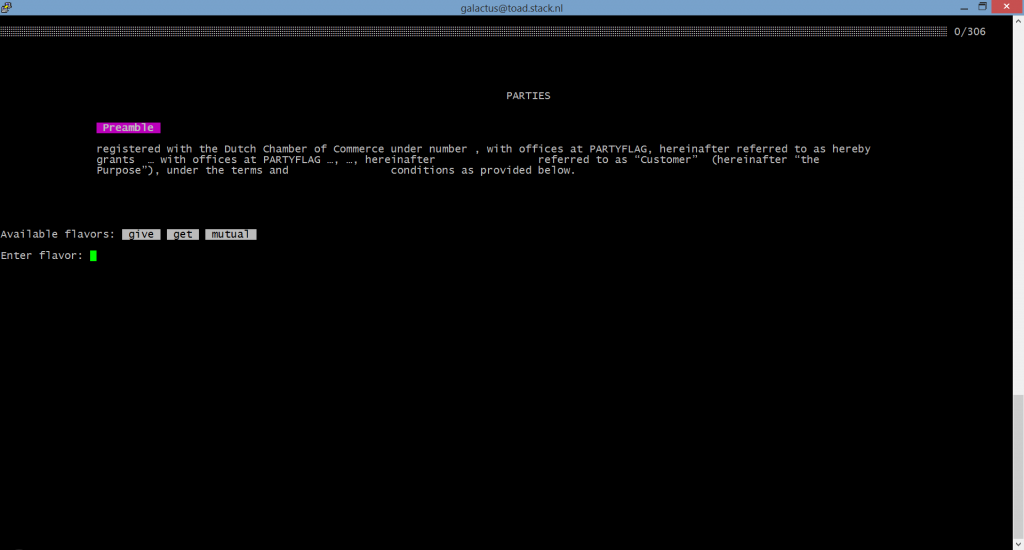
En de clauser, waarmee ik groepen zinnen (clausules dus) van een smaakje kon voorzien:

Dan heb je dus een berg zinnen en bijbehorende clausules, en daarmee kun je BigML gaan trainen. Dat had nog heel wat voeten in de aarde. Het eerste datasetje deed het goed, het voelt echt héél gaaf als je dan een test doet:

galactus@toad:~> php tagtest.php
input text: "Recipient shall use the same level of security as it uses for its own sensitive information to protect the Confidential Information against unauthorized use or disclosure, but at least a reaasonable level of security."
..... bigml says: security / standard
galactus@toad:~> 
En dat klopte helemaal. Maar er zaten genoeg fouten in. In het jargon: de F1-score was maar 0,64 en dat is niet genoeg om een commerciële dienst op te drijven. Terug naar de tekentafel dus, of beter gezegd de datatafel.

Allereerst viel me op dat ik toch wel wat foutjes had gemaakt. Dit haal je uit de confusion matrix, waarbij je kunt zien welke uitvoer op welke foute manier gelabeld wordt. Dan zie je bijvoorbeeld dat ‘parties’ clausules vaak als security clausules worden aangemerkt, zodat je specifiek daar extra voorbeelden van toe kunt voegen en foutcorrectie kunt doorvoeren.

Ook ontdekte ik dat ik de nodige categorieën had die ik zelf eigenlijk niet snapte. Overlap tussen categorieën maakt dat ML systemen slecht performen. Snoeien dus, en zorgen dat je per categorie duidelijk kunt aangeven wat erin hoort. Toch het nadeel van in halfslaap taggen wellicht?

De ingewikkeldste ingreep had te maken met dit soort clausules:

Recipient shall (a) treat all Confidential Information with the highest care; (b) only permit persons having a clear need to know access; (c) evaluate the Confidential Information at its own risk; (d) comply with relevant export regulations; (e) indemnify and hold harmless Discloser from any damages in connection with usage of the Confidential Information; and (f) waive its right to a jury trial.

Welke categorie plak je hier nu weer op? Het artikel regelt van alles, van security eisen tot wie het mag zien tot aansprakelijkheid en iets met juryrechtspraak. Daar kun je dus helemaal niets mee. Dat moest worden opgesplitst. Een hele vieze reguliere expressie (dit gaat een thema worden in het verhaal) splitste zo’n clausule in meerdere tegelijk, waarbij elke één van die zes bullet items bevatte.

En wat ook nog eens leuk bleek te werken, was bij elke zin mee te geven op welke plek hij in het document stond. Een zin over Florida aan het begin van een NDA gaat meestal over waar een partij gevestigd is. Staat hij aan het einde, dan is het waarschijnlijk de rechtskeuze. Dus kreeg elke zin als extra veld mee waar hij in het document stond. En hoe lang hij was (in woorden) want dat blijkt ook uit te maken. Grof gezegd, hoe langer een zin hoe strenger de bepaling. Soms is juridisch werk heel makkelijk.

Stiekem ook nog wat reguliere expressies bij de kwalificatie van clausules. Want sommige dingen zijn inschattingen (is dit streng of juist niet), anderen zijn gewoon simpel lezen. Een rechtskeuze voor Florida is geen inschatting, dat zie je gewoon letterlijk staan. Dus als je weet dat een clausule over rechtskeuze gaat (dat zegt de 1st stage classifier) dan kijk je gewoon welk land je ziet staan in die clausule en dat zal de rechtskeuze dan wel zijn.

Idem voor duur van het contract. Een AI heeft héél veel moeite met lezen of er staat dat een contract drie jaar duurt. Maar een reguliere expressie vindt hem zo. Deze oplossing is wat lomp, maar computers zijn snel en krachtig genoeg en het scheelt ontzéttend veel in de uitvoer. Mag ik zeggen, de regexp is de ducttape van de artificial intelligence?

Als laatste truc voegde ik vlaggetjes toe. Een machine learning systeem kijkt in principe naar losse woorden, maar juist in juridische teksten gebruikt men vaak vaste uitdrukkingen (“reasonable security measures”, “confidential information”, “receiving party”) en die moet je dus niet opsplitsen. De vlaggetjes werden toegevoegd met wéér een setje reguliere expressies, en dat gaf alles bij elkaar een hele mooie verbetering: een F1 van 0,86. Genoeg om de markt mee op te durven.

(Dit is de tweede van vijf vakantieberichten.)

Arnoud

De geboorte van NDA Lynn, of hoe bouw je een lawyerbot #ndalynnweek

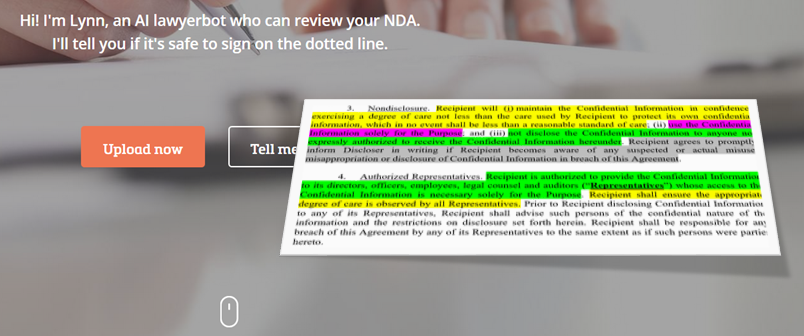
Heb jij ook wel eens gedroomd van een robot die je werk overneemt? Nou ik wel, want ik was het reviewen van geheimhoudingscontracten (NDA’s) ondertussen méér dan zat. Steeds maar ongeveer dezelfde teksten van ongeveer hetzelfde commentaar voorzien en opletten dat dezelfde stomme valkuilen er niet weer in zitten. Dat moet toch automatisch kunnen, leek me. Dit soort documenten is immers zó standaard opgesteld. En omdat ik ook nog ooit iets met informatica had gedaan, besloot ik zelf met haar aan de slag te gaan. In oktober 2017, na ruim een jaar bouwen, lanceerde ik deze lawyerbot, en ik noemde haar NDA Lynn. En nu, bijna drie jaar later, werken we aan de gaafste feature die ik ken: Edit Mode. Lees mee in deze X-delige serie hoe we van daar naar hier kwamen.

Ik weet niet meer precies wanneer ik kwam op het idee van Lynn. Maar het lezen en becommentariëren van al die NDA’s was ik al jaren zat. Ik doe het ook al een kleine twintig jaar. Eerst bijna tien jaar bij Philips, daarna (sinds 2008) als partner bij ICTRecht. Ik schat dat ik meer dan drieduizend NDA’s heb gereviewd in die tijd. En altijd was het verhaal ongeveer hetzelfde, want op hoe veel manieren kún je nu eenmaal zeggen dat je informatie gaat delen die je dan geheim moet houden, met geschillen te behandelen in Amsterdam en geen garantie op de juistheid van de informatie.

Ik weet nog wel dat ik op zeker moment drie NDA’s van drie klanten op één dag deed. Volledig ongerelateerd alle drie, maar de teksten kwamen grotendeels overeen. Toen ging het dus knagen: zou dat te automatiseren zijn? Het is in feite alleen maar tekstvergelijking, iets waar computers veel beter in zijn dan ik. Maar het gaat wel een stapje verder dan alléén maar het bekijken of twee alinea’s grofweg dezelfde tekens bevatten.

De hype rond AI en machine learning was toen al aardig op gang. Zou het met bijvoorbeeld Google of Microsoft’s cloudbased machine learning systemen kunnen? Het zag er allemaal veelbelovend uit, maar er was één groot nadeel. There is no cloud, it’s just someone else’s computer. Ik zag het niet zitten om voor deze dienst afhankelijk te zijn van een online service van een ander, ook niet als die gratis was.

Toen kwam ik het Spaanse BigML tegen. Een sympathieke dienst, een API die je meteen een goed gevoel geeft én de mogelijkheid om ML modellen offline in te zetten. Dus gewoon zeg maar een executable op je eigen server, zodat het niet uitmaakt of hun dienst beschikbaar is of niet. Dat was precies wat ik nodig had.

Hier, het resultaat van een avondje prutsen (ja, in PHP, dat was het makkelijkste) om eens te zien hoe dat nu werkt, zo’n machine learning systeem:

do {
  $res = bigML("poll", $bpid);
  if (isset($res["status"]["code"])) {
    if ($res["status"]["code"] != $oldstatus) {
      echo "\n => ".$res["status"]["message"];
      $oldstatus = $res["status"]["code"];
    } else
      echo ".";
  } else
    print_r($res);
  if ($i > 0) sleep(1); $i++;
} while (($res["status"]["code"] != "5") && ($i <= 10));

Het werkte prachtig. Alleen: een machine learning systeem is niets zonder data. In mijn geval dus NDA’s. Hoe kom je daar nou aan?

Een geluk aan de NDA is dat hij zo wijdverspreid is dat je er met gemak een paar honderd op internet vindt. Dat is dus het eerste dat ik deed. Daarnaast had ik er zelf natuurlijk een heleboel, alleen die had ik voor klanten geschreven of gelezen en dan kun je dus niet zomaar die in je eigen systeem stoppen. Later, met Lynn al draaiende, zou dat geen probleem meer zijn: Lynn is gratis maar je moet me toestemming geven je NDA te gebruiken voor verbetering van de dienst. Ik heb er nu een dikke 5000. Maar in het begin was het een serieuze uitdaging om de juiste NDA’s te vinden. Daarover een volgende keer meer.

Het basisidee van Lynn is vrij rechttoe rechtaan. Je krijgt een NDA, je extraheert de tekst, je kijkt welke clausules er zijn en zegt voor iedere clausule of deze acceptabel is of niet. Er zijn tools genoeg die een geupload document kunnen converteren naar tekst, en genoeg libraries ook voor tekstmanipulatie op zich. En als je weet wat voor clausule je hebt, kun je gewoon in een tabel kijken of hij acceptabel is of niet. Maar hoe weet je nu wat voor clausule je hebt?

Machine Learning (ML) is een vorm van AI waarbij een grote hoeveelheid data wordt geanalyseerd op gemeenschappelijke onderscheidende kenmerken. Hiermee maakt het systeem een functie die grofweg zegt of iets categorie A, B of C is. Als je dan een nieuwe input hebt (in mijn geval dus een nieuwe clausule) dan kijkt het systeem met die functie in welke categorie het hoort.

Dat betekent dus dat ik een dataset moet maken die een paar honderd NDA clausules bevat. En van elke clausule heb ik diverse smaakjes nodig, zeg maar wat is een strenge beveiligingsclausule en welke is juist lekker relaxed. Dan kan een ML systeem gegeven een inputclausule zeggen of deze het meest lijkt op een strenge beveiligingsclausule of juist eerder een rechtskeuze voor Florida. En als ik dat heb, kan ik een advies uit mijn tabel halen.

Dan het volgende probleem: hoe vind je nu precies een clausule? Na een stuk of dertig NDA’s te hebben bekeken, kom ik tot de conclusie dat daar geen standaardmanier voor is. Iedereen groepeert teksten op zijn eigen manier. Soms zijn het keurig genummerde alinea’s, anderen doen een opsommingslijstje en weer anderen maken gewoon een lap tekst met willekeurig een enter hier en daar.

En dan heb je ook nog grapjassen die verderop nog even terugkomen op een onderwerp. Zo zie ik die beveiligingseisen op drie of vier plekken in het document staan, zodat je niet eens kunt spreken van een beveiligingsclausule. Of er wordt op allerlei plekken geroepen dat er aansprakelijkheid is voor X of Y.

Nee, er zit niets anders op. Niet kijken naar clausules, je hebt alleen zinnen. Dat betekent dus, extraheer de zinnen uit het document, label die met hun onderwerp en voeg alles samen dat hetzelfde onderwerp is. Dat is dan je “clausule”, en daar kun je dan een kwalificatie op doen hoe streng of relaxed die is.

Zoals je hieronder ziet, krijg je dan een systeem waarbij je twéé machine learning componenten inzet. Het eerste zegt van een zin welke categorie het is (het 1st stage model) en het tweede systeem zegt van alle zinnen uit één categorie welk smaakje daaraan te geven is (het 2nd stage model). Gelukkig zijn ML systemen razendsnel, zeker de offline modellen die BigML kan aanbieden. Want je wil echt niet per zin een aanvraag doen bij de systemen van Google of Microsoft en dan een seconde wachten op het antwoord.
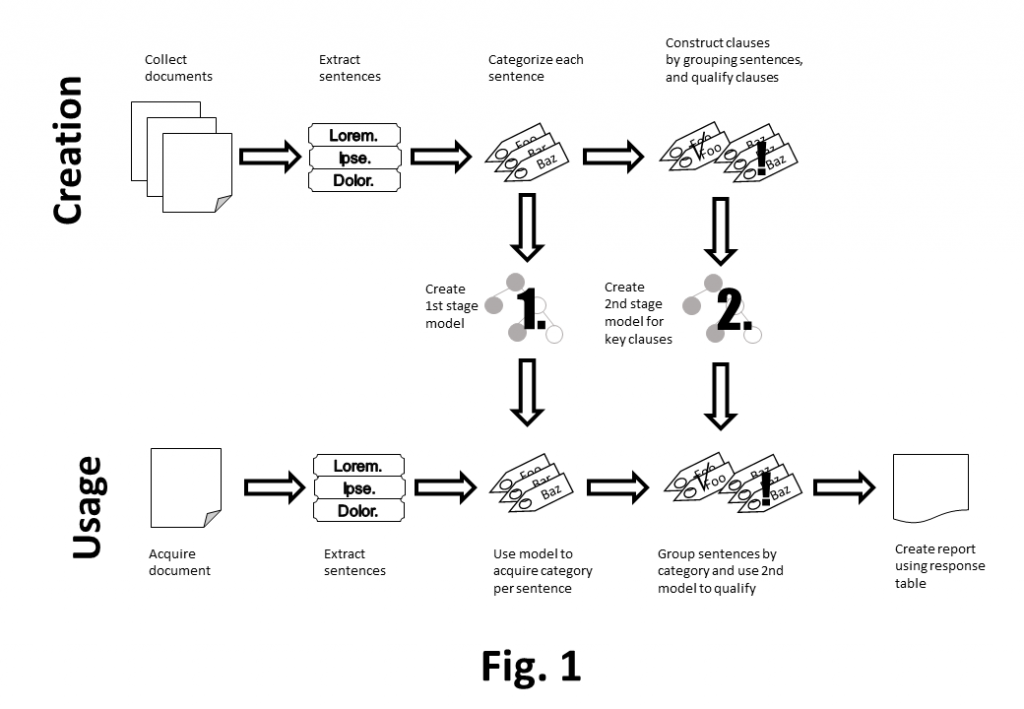
Deze architectuur ziet er goed uit. Hij heeft alleen één groot nadeel: ik moet nu niet langer een paar honderd clausules van een labeltje voorzien, maar een dikke duizend zinnen. Want elke clausule telt een zin of vijf, zo ontdek ik al snel. En als ik dat heb gedaan, dan moet ik daarna ook nog eens de zinnen van dezelfde clausule bij elkaar vegen en daar weer een labeltje op plakken dat me vertelt welke smaak de clausule is.

En hoe ik daarmee aan de slag ging, dat vertel ik morgen.

(Dit is het eerste van vijf vakantieberichten.)

Arnoud
Mag je openbaar toegankelijke databases wissen omdat het datalekken zijn?

Een lezer vroeg me:

Recent kwam in het nieuws dat duizenden onbeveiligde databases worden gewist door een aanvaller die alleen het woord “Meow” achterlaat. Het gaat om per abuis onbeveiligd toegankelijke databases, soms met en soms zonder persoonsgegevens. Het motief is onduidelijk, dus nu vroeg ik me af of je dit zou kunnen rechtvaardigen vanuit zaakwaarneming? Die bedrijven veroorzaken datalekken, dat moet zo snel mogelijk gestopt dus dan zelf maar ingrijpen?
Als ik de berichtgeving goed begrijp, dan gaat het om een robot die het internet afzoekt naar bekende plekken waar databases wel eens per abuis worden neergezet. Het is natuurlijk niet de bedoeling, maar helaas worden zulke databases nog wel eens ergens in productie genomen waar ze direct benaderbaar zijn via internet.

De motieven van de dader lijken onduidelijk – de speculatie is “omdat het kan”, er wordt immers geen nadere informatie gegeven en alleen de term “meow” achtergelaten in de database. Dat past niet echt bij een white hat hacker die datalekken wil stoppen. Maar een bijeffect is wel dat een hoop datalekken zo opgeruimd worden.

Het gaat me te ver om te zeggen dat dit legitiem kan zijn als een vorm van zaakwaarneming. Bij zaakwaarneming bemoei je je met andermans zaken omdat daar een onmiddellijke noodzaak voor is. Je ziet een vlam in de pan bij de buurman die even naar buiten was, je slaat een ruitje in en draait het gas uit. Zoiets.

Het is bij die vlam niet nodig eerst de buurman te vragen (als je weet dat die er niet is) of dat wel mag, de noodzaak is evident dus grijp je in. Maar bij zo’n open database ligt dat anders voor mij, dan is contact opnemen wel echt nodig. Alleen: er staat zelden bij van wie de database is, laat staan hoe je de FG van dat bedrijf benadert om het datalek te melden. Dat maakt het dus even lastig.

Het is strafbaar om andermans data te wissen of ontoegankelijk te maken, ook als je meent dat die data toegankelijk is vanwege een datalek. Het moet wel een heel acute en grote situatie zijn wil wissen door een derde ook maar enigszins gerechtvaardigd zijn. Ik kan dat niet bedenken, in ieder geval niet zonder discussie met de eigenaar.

Alleen weet ik niet wat dan wél te doen met zo’n openbare database waar geen contactgegevens bij staan. Jullie wel?

Arnoud PS: volgende week ben ik met vakantie, u krijgt dan een reeks over de geschiedenis van NDA Lynn. 

Mogen admins in je direct message-box kijken als ze dat noodzakelijk achten?

Bij Tweakers las ik een draadje waarin iemand claimde gesteund te worden door mensen die zich per privébericht, pardon direct message (die term is belangrijk) hadden gemeld. Waarop zijn bericht werd weggehaald omdat een admin even had gekeken en – ik citeer – alleen “een paar andere users die ook al [] verbannen waren” had aangetroffen. En tsja, discussies “belanden in de prullenbak omdat fatsoenlijke onderbouwing ontbreekt of er op een andere manier niet fatsoenlijk gediscussieerd wordt.” Eh, oké. Daar gaan mijn wenkbrauwen wel van omhoog, dat een admin dan even in je inbox kijkt als deel van een discussie. Maar mág het?

De reden dat  ‘direct message’ hier belangrijk is, is omdat Tweakers die term is gaan gebruiken juist om te voorkomen dat mensen met termen als “privébericht” gaan schermen als een admin die gaat lezen. Want hoezo kijk jij in mijn privé? Maar nu klinkt het alsof het alleen gaat om het 1-op-1 karakter van het bericht (ik bereik jou direct) en dat zegt niets over je privacyverwachting. Dus mag men kijken, maar maak je geen zorgen: alleen als dat noodzakelijk wordt geacht. Zoals men het zelf zegt:

Alle berichten die je verstuurt en ontvangt blijven bewaard op de servers van Tweakers en kunnen worden ingezien door de crew van Tweakers indien dit noodzakelijk geacht wordt. Spam of anderszins ongewenste berichten kan je hier melden.
Iets preciezer is de privacy notice, die vermeldt:

Berichten worden, net als de gewone forumdiscussies, ongecodeerd op onze servers opgeslagen. Bij misbruik van het DM-systeem of vermoeden van ongewenste activiteiten (bijvoorbeeld: spam, bedreiging, oplichting, enz). kan een selecte groep beheerders van Tweakers.net de betreffende DM boxen inzien.

Voor mij als jurist is “misbruik of vermoeden van ongewenste activiteiten” niet hetzelfde als “indien dit noodzakelijk wordt geacht”. Ik snap dat beide brede criteria zijn, dus we zullen maar zeggen dat men met die term noodzaak verwijst naar de frase uit de privacy notice.

De onderbouwing voor deze specifieke inzage wordt gegeven als

Als jij in dat feedback topic op hoge poten commentaar levert over de moderatie en daarbij claimt veel steun te hebben gekregen via DM, dan was dat in dit geval voor mij aanleiding om te controleren van wie, om dat argument op waarde te schatten (en in dit geval dus te bevestigen dat dat een erg zwak argument is gezien die DMs afkomstig zijn van andere gebruikers die zich meermalen misdragen hebben).

Nou vind ik de Tweakerscrew heel liev maar ik kan met de beste wil van de wereld “controleren om je argument op waarde te schatten” niet scharen onder “misbruik of vermoeden van ongewenste activiteiten”. Tenzij je zegt, het is ongewenst dat mensen feitelijk onjuiste informatie verstrekken over hun direct message box in discussies over moderatie. Dat vind ik nou niet het sterkste soort ongewenste activiteit om me druk over te maken, zelfs niet als je je als moderator aangevallen voelt door de stelling “iedereen steunt me in dm”.

Arnoud

Slack dient Europese antitrustklacht in tegen Microsoft wegens machtsmisbruik

Slack heeft een klacht ingediend bij de Europese Commissie tegen Microsoft wegens misbruik van haar dominante marktpositie. Dat las ik bij Tweakers. Microsoft heeft namelijk haar chat- en videovergaderdienst Teams toegevoegd aan het immens populaire Office, waardoor Slack oneerlijke concurrentie voelt. Zij kan immers met haar betaalde en losstaande aanbod niet op tegen “ach er zit ook al iets dergelijks in Office”. Opvallend genoeg zei Slack enkele maanden geleden nog dat het Teams helemaal niet als concurrent zag, het is mij niet helemaal duidelijk wat de gedachteverandering gaf. Maar in de kern hebben ze wel een punt.

Het toevoegen van een extra dienst aan je pakket is op zich niet raar. Er is veel vraag naar videobellen en chatten, dus dan speel je gewoon in op de marktvraag door dat toe te voegen. Zeker als je toch al Lync en Skype op de plank had liggen. Tijd om dat eens goed af te stoffen en een integratie toe te voegen.

Alleen, als je zo groot bent als Microsoft, dan gelden de gewone spelregels van de vrije markt niet meer. Het is dan té oneerlijk voor anderen als je zomaar alle trucs kunt toepassen om de concurrent dwars te zitten. En Microsoft is nou eenmaal de marktleider op productiviteitsgebied met haar Office-pakket. (Plus, ze hebben natuurlijk een geschiedenis met hoe ze Internet Explorer in de markt hebben geduwd om zo Netscape kapot te concurreren.)

De vraag is dan, hoe oneerlijk is het om een dienst als Teams toe te voegen aan je bestaande bundel. Het is een recente toevoeging – hoewel men al sinds 2018 bezig met het uitfaseren van Skype for Business is en het mensen pushen naar Teams – maar je kunt het ook zien als meegroeien met wat de markt wil. (In de jaren tachtig werkte Zoom heel anders.) Zeggen dat het enkele toevoegen al machtsmisbruik is, gaat mij dus wat ver.

Ik zie in de klacht van Slack wel dingen als dat je Teams niet zomaar kunt deïnstalleren, en dat er geen aparte prijs voor wordt gerekend. Dát gaat inderdaad net wat verder, want zo maak je het nodeloos net wat moeilijker om over te stappen. Slack zal dan altijd voelen als iets waarvoor je extra betaalt terwijl er al een prima gratis product bij Office zit. En dát is dan het wegpesten van de concurrent.

Arnoud