Rechter VS gaat onderzoek doen naar Google wegens verwijderde chatberichten

Amerikaanse rechter James Donato zegt Google te gaan onderzoeken. Dat meldde Tweakers maandag. De aanleiding zijn chatberichten die Google moedwillig heeft vernietigd, terwijl dat potentieel bewijsmateriaal was in een lopende rechtszaak tussen het bedrijf en Epic Games. Dat vond Donato niet leuk: “Ik ga tot op de bodem uitzoeken wie er verantwoordelijk is”, zo wordt hij in The Verge geciteerd.

De zaak an sich is best interessant, omdat het duidelijkheid kan geven in wat grote bedrijven met appwinkels mogen. Epic is de aanbieder van het populaire Fortnite, en wilde onder meer een eigen betaalsysteem toepassen:

Ruim drie jaar geleden sleepte Epic Games de mobiele techgiganten Apple en Google voor de rechter. Beide bedrijven werden ervan beschuldigd illegale monopolies te hebben met hun appwinkels, concurrentie in de weg te zitten en hoge commissies te vragen op in-appaankopen, waarvoor geen alternatieven beschikbaar zijn.
Tijdens de zaak werd duidelijk dat Google, net als heel veel bedrijven, een auto-delete heeft op alle interne communicatie. Dat is mede vanwege zorgen over rechtszaken. In de VS moet je namelijk bij een civiele zaak alle mogelijk relevante stukken overleggen aan de wederpartij (“discovery”) zodat beide partijen met open vizier strijden. Dan is een onhandig geformuleerde e-mail uit 2012 erg vervelend.

Het voelt als vernietigen van (potentieel) bewijs, maar het is een staande regel dat als jij beleid hebt met objectieve criteria wat er weg gaat en wanneer, je niets verkeerd doet als je dat beleid uitvoert. Bijvoorbeeld: “alle mail van een ex-werknemer gaat weg 30 dagen na uitdiensttreding”.

Wanneer een rechtszaak eenmaal loopt, ligt dat natuurlijk anders. Dan mag potentieel bewijs absoluut niet worden weggegooid of vernietigd. In het jargon zit er dan een “litigation hold” of “legal hold” op zo’n stuk. (Het is open voor debat wanneer een zaak ‘loopt’, is dat vanaf de eerste blafbrief, pas na ontvangst dagvaarding of misschien zelfs vanaf wanneer je had kunnen dan wel moeten weten dát er een blafbrief of dagvaarding aan gaat komen. Dit verschilt per staat en ga hier alsjeblieft niet zelf mee knutselen.)

Gebruikelijk is dat de advocaten (of bedrijfsjuristen) aangeven wat er bewaard moet worden, omdat zij weten waar de zaak over gaat en de wet het beste kennen. Bij Google is het opmerkelijk genoeg de werknemer die het schuifje legal hold aanzet bij de chat en e-mail, wat er dus toe kan leiden dat ceo Sundar Pichai dat niet deed terwijl er al een rechtszaak liep.

Het ging ook mis bij een ander punt: Pichai gaf aan dat hij soms documenten als “privileged” markeert om te voorkomen dat ze in handen van de wederpartij komen. Privilege wil zeggen dat het vertrouwelijke communicatie tussen advocaat en cliënt betreft – daar mag de andere partij uiteraard geen inzage in hebben. Dat labeltje ergens op plakken is dus best wel een stap, en misbruik daarvan maken om spullen weg te houden zeer zeker niet de bedoeling.

Gezien de feiten snap ik best dat rechter Donato boos is. Hij spreekt van “een frontale aanval op de eerlijke rechtspraak”. “Ik ga tot op de bodem uitzoeken wie er verantwoordelijk is”, aldus Donato.

Wat hij precies kan doen om dat onderzoek uit te voeren is iets minder duidelijk. Hij heeft geen onderzoeksafdeling en kan ook de politie niet instrueren om iets te gaan doen. Hij kan wel dingen doen als als de advocaten van Google instrueren om nu álle documenten te geven en daar een onafhankelijk onderzoeker op zetten die zegt wat er echt advocaatcorrespondentie is, bij ieder onjuist gelabeld document krijgt de advocaat persoonlijk 1000 dollar boete. Hij kan ook een advies aan de beurstoezichthouder FTC geven dat die eens heel goed moeten kijken wat Google allemaal uitspookt, of de Orde van Advocaten aanraden dat ze alle Google-advocaten een fikse waarschuwing geven.

Arnoud
 

Rechter houdt parkeerboete na verdwenen inloggegevens in stand

Een man die de auto van zijn bezoek te laat aanmeldde omdat naar eigen zeggen de inloggegevens uit de bezoekersapplicatie op de telefoon waren verdwenen moet de door de gemeente opgelegde parkeerboete gewoon betalen. Dat las ik bij Security.nl. Je app achttien minuten te laat aanzetten is te laat, en de loginproblemen zijn jouw probleem?

Een bezoeker van de man parkeerde op een betaaldparkerenplaats om 14.51. De man meldde het bezoek echter pas om 15.09 aan via de bezoekersapplicatie op zijn telefoon. Om 15.01 had een parkeerambtenaar al gezien dat de auto zonder parkeerbelasting te hebben betaald was geparkeerd.

Juridisch is het zo dat als jij andermans parkeerbelasting betaalt, jij degene bent die de auto parkeert vanuit het perspectief van de Gemeentewet. Daarom kreeg deze man dus de naheffing en niet de persoon die feitelijk parkeerde. En waarom het misging? Uit het vonnis:

Eiser voert aan dat hem in redelijkheid niet kan worden verweten dat het voertuig niet eerder dan om 15:09 uur heeft aangemeld in de bezoekersapplicatie op de telefoon. Bij het openen van de app waren de inloggegevens verdwenen. Omdat het parkeerabonnement op naam staat van zijn partner, kon eiser het voertuig niet aanmelden zonder haar hulp en zij was op dat moment niet in de buurt. Na contact met zijn partner bleek dat de inloggegevens op haar telefoon ook waren verdwenen. Het wachtwoord moest via e-mail worden aangepast waardoor het uiteindelijk pas om 15.09 uur is gelukt om het voertuig aan te melden. Eiser heeft wel tijdig gepoogd om het voertuig aan te melden.
Wellicht dat er meer mensen dit probleem bekend voorkomt, bijvoorbeeld na een update van de app of een migratie naar een nieuwe telefoon. Maar juridisch is dat dus echt jóuw probleem.

Weliswaar zegt de wet dat je een redelijke termijn moet krijgen om de parkeerbelasting te betalen, maar dat is hooguit een minuut of vijf, en niet de twintig die hier werden overbrugd. Die termijn gaat grofweg over de tijd om naar een ouderwetse automaat te lopen en daar te betalen.

Wellicht had dit anders kunnen lopen als de bezoeker bij de auto was gebleven. De rechter merkt namelijk op:

Doordat er in geval van eiser niemand in of nabij het voertuig is gebleven, is het risico ontstaan dat er in de tussenliggende tijd een parkeercontrole plaatsvond. De gevolgen hiervan komen voor rekening en risico van eiser.
De bezoeker had na een paar minuten vruchteloos proberen kunnen zeggen, ik loop naar de automaat en betaal even voor een kwartier. Of de hele verwachte parkeerduur en dan onderling verrekenen.

De les is dus: controleer of de app het doet voordat je bezoek er is.

Arnoud


Rechter VS: Elon Musk en Tesla negeerden fatale fout in Autopilot

Elon Musk en Tesla wisten dat het Autopilot-systeem fouten bevat en hebben deze niet opgelost. Dat meldde AG Connect onlangs. Een rechter in Florida deed deze uitspraak met mogelijk verstrekkende gevolgen in een zaak over een fataal ongeluk in 2019, waarbij de Autopilot een belangrijke rol speelde. Het is geen eindoordeel maar wel een veeg teken.

De achtergrond van de zaak is even kort als luguber:

Bij het ongeluk in 2019 zat Jeremy Banner achter het stuur van een Tesla Model 3. Hij had de Autopilot aangezet op een weg zonder middenstreep. Op een kruising stak een voertuig met oplegger over, die door de Tesla-software niet werd gezien. De Tesla schoof onder de aanhanger en Banner kwam om het leven. Nabestaanden van Banner hebben toen een rechtszaak tegen Tesla aangespannen.
Al sinds 2016 is er heisa over dat “AutoPilot” van Tesla, die wel werd aangeprezen als “the car is driving itself.” Dat is niet helemaal waar; als bestuurder (hoi Vincent) moet je aan het stuur blijven om desgevraagd snel in te grijpen bij onverwachte gebeurtenissen zoals een overstekende vrachtauto van 25 meter lang.

Wat er precies van waar is en in hoeverre Tesla’s disclaimers en EULA meewegen, dat is iets waar de jury wat van moet gaan zeggen. Want dit is zoals gezegd geen eindvonnis. Tesla had bezwaar gemaakt tegen de eis tot punitive damages, zeg maar die miljoenen omdat er niet op de magnetron stond dat je er géén natte hond in mocht doen. Iets formeler: de aanvullende schadevergoeding die de jury redelijk acht vanwege het geschokte rechtsgevoel.

Om zo’n eis te mogen doen, moet je aannemelijk maken dat er een redelijke basis in de bewijsstukken is dat deze wel eens toegewezen kan worden. Dit omdat de procedure met die eis erbij een heel stuk langer duurt – en dus duurder is – wat je niet wilt als het nauwelijks kansrijk is.

De rechter zegt hier dus dat aan die eis van aannemelijkheid voldaan is. Er is genoeg informatie om in redelijkheid te kunnen concluderen dat Tesla inderdaad grof nalatig was met de marketing van haar Autopilot. Tegenbewijs is mogelijk, dus de uitkomst kan nog steeds zijn dat het uiteindelijk toch user error was, maar de kans daarop lijkt nu wel ietwat klein.

Arnoud


‘Deepfake’ pornovideo kwalificeert als afbeelding, joh

Een 39-jarige man uit Amersfoort is donderdag door de rechtbank in Amsterdam veroordeeld tot een voorwaardelijke taakstraf van 180 uur. Dat meldde het AD vorige week. Hij had een deepfakepornovideo van journalist en presentatrice Welmoed Sijtsma gemaakt, en dat blijkt dus strafbaar. Joh.
Bij de arrestatie blogde ik:

Een deepfake is een techniek voor het samenstellen van videobeelden met machine learning, meer specifiek een generatief antagonistennetwerk of generative adversarial network (GAN). Heel simpel uitgelegd bestaat een GAN uit twee AI systemen, de een genereert plaatjes en de ander probeert te zien of die gegenereerd zijn. Pas als die laatste ze niet herkent, zijn ze af. Maar los van de technische details, de omschrijving uit het AD “Mijn hoofd is op het lichaam van een pornoactrice gemonteerd.” laat prima zien waar het om gaat. Er zijn immers genoeg andere manieren om dit resultaat te bereiken, ze zijn alleen duurder of arbeidsintensiever dan een GAN.
Als we het zuiver juridisch bekijken, dan komt het neer op de vraag of dit een vorm van ‘wraakporno’ is, of iets preciezer of dit valt onder art. 139h Strafrecht:
Met gevangenisstraf van ten hoogste een jaar of geldboete van de vierde categorie wordt gestraft: a. hij die opzettelijk en wederrechtelijk van een persoon een afbeelding van seksuele aard vervaardigt; b. hij die de beschikking heeft over een afbeelding als bedoeld onder a terwijl hij weet of redelijkerwijs moet vermoeden dat deze door of als gevolg van een onder a strafbaar gestelde handeling is verkregen.
De discussie is dan of een deepfake een ‘afbeelding’ is: het is niet een via traditionele manieren gemaakte reproductie van de beeltenis van Sijtsma, het is de uitkomst van een statistisch proces.

De rechter ziet dat echter niet als een fundamenteel bezwaar:

  1. Op basis van een grammaticale interpretatie van de wettekst kan naar het oordeel van de rechtbank een deepfake pornovideo onder het begrip afbeelding van seksuele aard als bedoeld in artikel 139h Sr vallen. Het begrip afbeelding is een zeer breed begrip en daar valt naar normaal spraakgebruik, zeker in de huidige maatschappij met alle (online) digitale content, zonder meer een digitaal gemanipuleerde video onder.
  2. Bij de beoordeling van de reikwijdte van het begrip afbeelding van seksuele aard moet ook gekeken worden naar de bedoeling van de wetgever ten tijde van de invoering van de strafbaarstelling. … De wetgever heeft zich volgens de rechtbank echter niet slechts tot deze bovengenoemde rechtstreekse opnames willen beperken.
  3. [Tevens] is het artikel ondergebracht in een reeks van artikelen (138 Sr tot en met 139h Sr) die (in min of meerdere mate) de privacy van personen beoogt te beschermen, in dit geval seksuele privacy. … Het te beschermen belang bestaat er aldus uit dat seksueel getint beeldmateriaal niet tegen iemands zin vervaardigd mag worden, dan wel dat dit beeldmateriaal in de privésfeer moet blijven wanneer openbaarmaking nadelig kan zijn voor de afgebeelde persoon. Naar het oordeel van de rechtbank kan ook seksueel beeldmateriaal in de vorm van een deepfake-afbeeldingen onder dit te beschermen belang vallen.
De conclusie is duidelijk: ook deepfakes zijn ‘afbeeldingen’, zij het met de beperking dat
het beeldmateriaal in kwestie zodanig echt lijkt dat het op het eerste gezicht niet duidelijk is dat het gaat om beelden die gemanipuleerd zijn.
Een zelfgemaakte schetstekening zou dus geen ‘afbeelding’ zijn, en zelfs een realistisch schilderij niet. Het gaat erom of het publiek op het eerste gezicht zou denken dat de afbeelding echt is, zeg maar dat het een foto of video van de werkelijkheid is.

De ietwat opmerkelijke conclusie is dus dat als duidelijk is dát het een deepfake is, het niet strafbaar is. Maar alleen maar letterlijk dat erbij zeggen, is volgens de rechtbank dan weer niet genoeg:

De door verdachte gemaakte deepfake pornovideo van aangeefster kan naar het oordeel van de rechtbank daarom aangemerkt worden als een afbeelding van seksuele aard van een persoon. De door verdachte op de video geplaatste tekst dat het gaat om een deepfake maakt dat niet anders. Daarbij neemt de rechtbank in aanmerking dat de strafbaarheid van de gedraging ligt in de vervaardiging van het seksuele beeldmateriaal zelf.
Deze volg ik niet helemaal, want als het criterium is hoe het publiek het percipieert dan lijkt me een duidelijke disclaimer wel degelijk relevant bij de toetsing aan dat criterium.

Arnoud

Terugslag voor massaclaims miljoenen Nederlanders tegen TikTok, Meta, Google en Amazon

Claims voor immateriële schade bij privacyschending kun je niet voor veel gebruikers samen indienen, las ik bij Netkwesties. In oktober bepaalde de rechtbank Amsterdam namelijk dat zulke schade te persoonlijk is om te kunnen bundelen. Ook zet de rechtbank vraagtekens bij de vermeende commerciële motieven van de AVG-massaclaims, die immers allemaal met procesfinanciering worden gevoerd.
De kern van de discussie is natuurlijk of het juridisch wel de bedoeling is, dat een stichting namens een hele groep mensen een claim van zeg een tientje per persoon indient voor een AVG-overtreding. Met name vanwege die procesfinanciering: de partij die de stichting sponsort en de advocaat krijgt bij winst “veelal tussen 10 en 25 procent wat bij elkaar miljarden kan opleveren.”

Op zich is dit een legale constructie. Advocaten mogen niet op no cure no pay opereren, maar dat gebeurt hier niet, en als iemand andermans advocaat wil betalen en alleen bij een gewonnen zaak zijn investering (met winst) terugkrijgt, dan is daar niet direct een wetsartikel tegen.

Het idee van een massaclaim is alleen wel dat er massaal schade is geleden, zodat een hoop mensen tegelijk die gaan claimen en het dan efficiënter is dat met één zaak te doen. De schade is hier wat speculatief: hoe erg is het dat datafuik TikTok alles weet van je kind en een gedetailleerd profiel heeft opgebouwd? Welk schadebedrag zet je op zoiets?

De wet maakt onderscheid tussen materiële en immateriële schade. Het is die laatste categorie waar de rechter moeite mee heeft in een massaclaim: dan hebben we het over zaken als gederfde levensvreugde, angst, boosheid, stress en verontwaardiging. Dat is té persoonsgebonden, de een zal de schouders overhalen over dat profileren en de ander heeft hier langdurig last van.

Materiële schade is in beginsel op geld te waarderen, en daarmee wel geschikt om te bundelen. Dat kan ook bij gebruik van persoonsgegevens:

Deze persoonsgegevens hebben een zekere economische waarde voor degene die ze verkrijgt. … [I]ndien en voor zover persoonsgegevens worden verstrekt om daarmee een dienst te ‘kopen’, moet niet alleen worden gelet op de betaalde prijs (het verstrekken van de persoonsgegevens) maar ook op de daarvoor ontvangen tegenprestatie (de TikTok Dienst).
Dit vereist een nadere analyse van allerlei factoren (de rechtbank noemt er al zeven), maar je kunt niet op voorhand de stelling afwijzen dat er überhaupt materiële schade is geleden. En belangrijker: materiële schade is bundelbaar, al is het maar omdat er uiteindelijk een geldbedrag uitkomt per categorie slachtoffer en dat kun je dan optellen.

De claimstichtingen mogen dus door, mits ze maar focussen op materiële schade. Wel moeten ze nog eens goed kijken naar de constructie, want de rechtbank ziet daar wel vraagtekens bij de financiële onafhankelijkheid. Procesfinanciering mag namelijk niet als de financier zich inhoudelijk mag bemoeien met de procedure. Zo mag deze niet bepalen welke advocaten de zaak moeten doen.

Arnoud

Nee, de Data Act is nog niet aangenomen en dat duurt nog wel even

“The European Parliament has voted to approve the Data Act — controversial legislation that includes a stipulation necessitating smart contracts have the ability to be terminated.” Dat meldde Coin Telegraph onlangs. Ik ergerde me dood, vanwege dat “has voted to approve” en termen als “adopted”. Dit ging bij de AI Act ook zo, dus ik gebruik deze blog voor een lesje Europees staatsrecht.
De Data Act is een van de vele aankomende Europese regels om de data-economie wat meer onder controle te krijgen. Doel is het ontsluiten van de (niet-persoonlijke) data die uit apparaten komt, plus contractuele randvoorwaarden voor datadeelcontracten tussen bedrijven en zo nog het een en ander.

Het Europees Parlement heeft met 481 tegen 30 nu vóór gestemd. In Nederland zouden we dan zeggen, die wet is aangenomen en kan nu naar de Eerste Kamer. Die bestaat niet in Europa, maar er is wel de Raad van Ministers de Council of the European Union (niet te verwarren met de Council of Europe of de European Council). Vandaar taalgebruik als “is nu aangenomen en gaat naar de Raad”.

Alleen, het Europese systeem werkt iets anders. Het Parlement en de Raad zijn onafhankelijke organen die samen (inclusief de Europese Commissie) onderhandelen om tot een definitieve wet te komen. De Europese Commissie maakt een voorstel, dat parallel naar Raad en Parlement gaat. Die gaan er intern over delibereren en stemmen over een onderhandelmandaat, wat vinden wij belangrijk, waar zijn we flexibel en welke dingen zijn wel goed zo.

Als beiden zo’n mandaat hebben aangenomen, dan wordt er onderhandeld. De Raad kan er voor kiezen om gewoon over te nemen wat het Parlement heeft gekozen, en dan zijn we snel klaar. De Raad kan ook een eigen tegenvoorstel doen, en dan moet er dus worden onderhandeld om tot een compromistekst te komen. Dit heet de trilogue, omdat het een dialoog maar dan tussen drie partijen is.

De AI Act zit nu middenin die trialoog bijvoorbeeld. De triloog van de Data Act begint nu: de de Raad had al in maart haar onderhandelpositie aangegeven. Daarin staat ook al een smart-contracts clausule (artikel 30) met ongeveer dezelfde strekking: een smart contract moet een stop-functie hebben en interne controls om getermineerd te kunnen worden.

Mijn interpretatie is dat dit gaat om het kunnen ingrijpen bij op hol geslagen autonome algoritmes, zoals bij financiële handel, omdat dit grote maatschappelijke gevolgen kan hebben. Maar inderdaad is de clausule niet beperkt tot die specifieke randgevallen; ieder smart contract moet deze functie hebben. En de definitie is nogal breed:

(16) ‘smart contract’ means a computer program stored in an electronic ledger system wherein the outcome of the execution of the program is recorded on the electronic ledger; (17) ‘electronic ledger’ means a sequence of electronic data records which ensures their integrity and the accuracy of their chronological ordering;
De clausule blinkt ook niet uit in duidelijkheid: moet die killswitch intern geprogrammeerd zijn (als situatie X, sluit jezelf dan af), moet de eigenaar/beheerder van de software dit kunnen doen of zou een overheidsinstantie het kill-commando moeten kunnen geven? De ophef is dus niet geheel onbegrijpelijk.

Arnoud

Hoe verweer je je tegen de uitspraken van de ChatGPT detector?

Een lezer vroeg me:

Ik las over de ontwikkeling van een “ChatGPT detector” bij wetenschappelijke papers. Weliswaar alleen voor scheikunde, maar ik vroeg me toch al af: als mijn paper op de universiteit door zo’n detector als plagiaat wordt aangemerkt, wat kan ik daar dan tegen doen? Dit is een behoorlijk black box verhaal.
De aangehaalde publicatie betreft een tool ontwikkeld door twee scheikundigen. Op basis van een relatief kleine dataset met abstracts kan de tool zeer accuraat een abstract als handgeschreven versus “komt uit ChatGPT” aanmerken. Het idee erachter is dat je zo’n detector domeinspecifiek moet bouwen, omdat je dan domeinspecifieke terminologie, taalgebruik, stijl en dergelijke mee kunt nemen in de afweging.

Voor plagiaatcontrole zou je dus per faculteit een aparte dataset moeten maken, dat lijkt me een te overzien probleem. Dus laten we even aannemen dat zo’n ding bestaat en ingezet wordt in de al bestaande procedure van plagiaatcontrole op papers en scripties. Wat dan?

Plagiaatscanners werken op dit moment vrij rechttoe-rechtaan: ze matchen stukken tekst met externe bronnen en produceren een rapport met highlights. Het plaatje rechtsboven (van scanner Ephorus) laat daarvan een voorbeeld zien. Een examinator gebruikt dat als input om zelf de vergelijking te controleren en daar conclusies uit te trekken. Dat gaat dan bijvoorbeeld zo:

Tijdens de controle van het werk is door de plagiaatscanner een overlap geconstateerd tussen het werk van [appellant] en een medestudent. De overlap omvatte bijna 100 procent van het werk. … De examencommissie heeft ook geconcludeerd dat [appellant] zich schuldig heeft gemaakt aan plagiaat vanwege het letterlijk overnemen van informatie van websites. Omdat [appellant] geen gebruik heeft gemaakt van aanhalingstekens of een bepaalde vormgeving, zijn de citaten niet als zodanig herkenbaar. Verder heeft [appellant] bijna letterlijk informatie overgenomen zonder bronvermelding.
De “ChatGPT detector” werkt iets anders. Uit de Nature-publicatie:
Using machine learning, the detector examines 20 features of writing style, including variation in sentence lengths, and the frequency of certain words and punctuation marks, to determine whether an academic scientist or ChatGPT wrote a piece of text. The findings show that “you could use a small set of features to get a high level of accuracy”, Desaire says.
Hier komt dus de uitspraak uit “op basis van statistische analyse lijkt het er zeer sterk op dat deze tekst uit de tool ChatGPT komt”. Dat is wel even een ander niveau dan constateren dat stukken tekst uit het paper gelijk zijn aan stukken tekst uit een specifieke, na te lezen bron.

Juridisch gezien ligt de bewijslast bij de docent dan wel examencommissie dat sprake is van fraude (waar plagiaat of het inschakelen van hulplijnen onder valt). In dit Tilburgse voorbeeld uit 2021 werd door het College van Beroep een plagiaatbeschuldiging afgewezen omdat het aangedragen bewijs niet meer was dan “vraag 2d is opmerkelijk gedetailleerd beantwoord, in tegenstelling tot de rest”. Maar in de meeste gevallen is de plagiaat wel letterlijk en duidelijk.

Ik kon één geval vinden (uit Leiden) waarin de fraude zou zijn dat de student een derde had ingeschakeld om mee te schrijven. Dat lijkt nog het meest op het inzetten van ChatGPT: als docent zie je andere stijlvormen, een hoger niveau van redeneren, een heel andere wending dan in de eerder besproken onderzoeksopzet en concepten, zulke dingen.

Het kán natuurlijk dat je tussentijds ineens diepere inzichten verwerft (en discussie met anderen is legitiem om die te verwerven), maar als je dat niet kunt toelichten of laten zien als daarom gevraagd wordt dan kan men alsnog uitkomen bij fraude:

Het College overweegt dat niet het feit dat appellante een andere, ingewikkelde methode in haar scriptie heeft gebruikt kan worden aangemerkt als fraude, maar dat de verstrekte  toelichtingen van appellante over de door haar gemaakte keuzes in haar scriptie van dien aard zijn dat verweerder terecht en op goede gronden heeft geconstateerd dat het op juiste wijze vormen van een oordeel over de kennis, het inzicht en de vaardigheden van appellante geheel of gedeeltelijk onmogelijk is geworden en dus als fraude moet worden aangemerkt.
Ik vond één uitspraak uit Groningen over fraude (mede) vanwege de inzet van AI. De bewijslast werd volgens mij goed gedragen:
Appellante heeft in haar essay tenminste tien bronnen gebruikt die in het geheel niet bestaan. Daarnaast zijn er ook andere fouten gemaakt in de bronvermelding. Zo noemt appellante artikelen die niet in de door haar genoemde vakbladen zijn gepubliceerd en zijn er ook nog andersoortige fouten gemaakt.
Met dergelijke aanwijzingen onderbouw je je vermoeden van fraude prima, zeker als de studente daar weinig meer tegenover kan stellen dan dat het expliciete verbod op gebruik van AI pas van na haar afrondingsdatum was. Gebruik van tools om je werk te doen maakt dat het minder jouw werk is.

Van de zomer verscheen dit artikel waarin men een lichte toename signaleerde van fraudegevallen door GPT. Schokkend vond ik wel de daar gedane suggestie over detectie door ChatGPT zelf:

Bij vermoeden van plagiaat kan je aan het computerprogramma vragen of hij het geschreven heeft. ChatGPT geeft daar dan ‘eerlijk’ antwoord op. Die methode is niet altijd betrouwbaar, zegt Ferrantelli, dus uiteindelijk geeft het oordeel van de docent de doorslag.
Een methode die “niet altijd betrouwbaar is” lijkt me per definitie een methode die je niet moet gebruiken. Zeker als de makers van ChatGPT zelf hun eigen tool hiervoor offline halen omdat hij niet goed werkt.

(Meelezende afstudeerders-in-spe, wie hier een onderzoek van wil maken kan zich melden!)

Arnoud

In het moderatieteam van X heeft maar één persoon Nederlands als hoofdtaal, is dat erg

Het sociale medium X heeft één persoon in het moderatieteam van wie Nederlands de eerste taal is. Dat meldde Nu.nl onlangs op basis van de DSA-transparantierapporten die X née Twitter periodiek moet publiceren. Het moderatieteam telt 2.294 mensen, waarvan er eentje dus Nederlands spreekt.
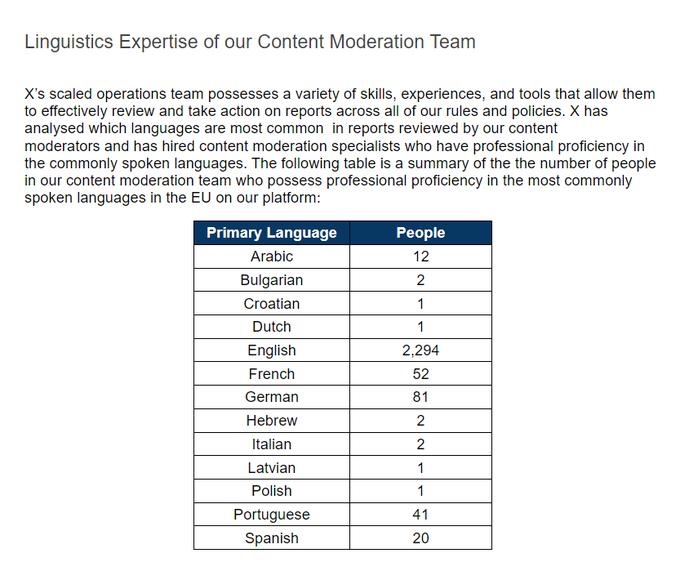
De Digital Services Act eist van zeer grote platforms zoals X dat ze regelmatig updates geven over allerlei aspecten van de dienst. Deze transparantierapporten moeten elke zes maanden uitkomen, en een van de verplichte elementen is het aantal “human resources” per officiële EU-taal en hun kwalificaties. Dat doet X dus zo:

Allereerst valt mij dan op dat ze van “rapporteren per taal” gaan naar “dit zijn de volgens ons meest gesproken talen in de EU”, maar goed als de rest 0 is dan snap ik het wel. Verder komt er dan een uitgebreide tekst over hoe goed het team dan wel niet is (ik ben te cynisch want ik ruik ChatGPT). Maar de vraag blijft: is dit erg?

Formeel heeft X aan de DSA voldaan: artikel 42 eist niet meer dan dat je vertelt hoe veel mensen per taal je hebt en wat hun kwalificaties zijn. “We hebben niemand en die halve paardenkop die er zit, kan niets” is een juist antwoord als dat de situatie is. Echter, artikel 16 eist dat je adequaat omgaat met klachten over content, en een onkundige halve paardenkop kan dat natuurlijk niet. Je cijfers zeggen dus wel iets over de kwaliteit van je moderatieteam.

Het aantal mensen (en hun talen + deskundigheid) past natuurlijk ook goed in een analyse van de systemische risico’s (artikel 34) waar je als VLOP naar moet kijken. Als je te weinig mensen hebt om het Nederlandse taalgebied goed te modereren, dan kunnen er dingen misgaan in Nederland. Dat is echter iets voor het risk assessment dat pas over een half jaar hoeft te verschijnen.

Arnoud


Honderden security-experts slaan alarm over EU-plan waarmee alle internetverkeer valt te onderscheppen

Honderden wereldwijde cybersecurity-experts, onderzoekers en wetenschappers hebben een open brief ondertekend waarin alarm wordt geslagen over de Europese eIDAS-verordening. Dat meldde AG Connect onlangs. Deze creëert een achterdeur waarmee internetverkeer grootschalig afgetapt kan worden.

De eIDAS-Verordening bestaat sinds 2018 en regelt onder meer de rechtsgeldigheid van elektronische handtekeningen, zegels en certificaten. Een voorbeeld van dat laatste zijn de SSL- of TLS-certificaten die door webbrowers worden gecontroleerd om na te gaan of websites echt zijn.

Om de echtheid na te gaan, moet je een vertrouwde entiteit hebben die zegt welke certificaatuitgevende instanties te vertrouwen zijn. Dit ging laatst mis bij DeGiro: die hadden niet de goede certificaten en wisten niet wie die vertrouwde entiteit was – de root certificate issuer, in jargon.

Dit is een bug én feature in het systeem: iedereen moet uitzoeken wie hij vertrouwt, er is geen bindende mededeling vanuit de overheid dat Diginotar partij X altijd geloofd moet worden. En de ophef is dus ontstaan over de voorgenomen wijziging aan de eIDAS-Verordening die dat wél gaat introduceren:

Under the eIDAS regulation, each member state of the EU (as well as recognised third party countries) is able to designate Qualified Trust Service Providers (Qualified TSPs) for the distribution of Qualified Website Authentication Certificates (QWACs). Outside the EU, these TSPs and QWACs are more typically known as Certificate Authorities (CAs) and TLS Certificates, respectively. Article 45 requires browsers to recognise these certificates.
Hiermee wordt het huidige proces van controle en vertrouwen opgeheven en vervangen door een controle door de overheid. Daar hebben velen moeite mee: een kwaadwillende overheid zou een certificaat onder valse naam kunnen uitgeven, waarna browsers de verkeerde site als authentiek aanmerken en men zo gegevens kan onderscheppen.

In de open brief wordt het iets concreter uitgelegd:

Concretely, the regulation enables each EU member state (and recognised third party countries) to designate cryptographic keys for which trust is mandatory; this trust can only be withdrawn with the government’s permission (Article 45a(4)). This means any EU member state or third party country, acting alone, is capable of intercepting the web traffic of any EU citizen and there is no effective recourse. We ask that you urgently reconsider this text and make clear that Article 45 will not interfere with trust decisions around the cryptographic keys and certificates used to secure web traffic.
Voor de duidelijkheid: het gaat dus niet om aftappen bij de internetprovider of vanuit de browser afluisteren, maar om het kunnen omleiden van argeloze internetgebruikers naar malafide sites om te zien wat ze daar doen. Omdat het certificaat als authentiek wordt gezien, zijn die sites niet meer van echt te onderscheiden – sterker nog, juridisch zijn ze de echte site.

Een echte oplossing hiervoor is er nog niet. DNS CAA is op papier een tegenkracht: een website kan in haar domeinnaamgegevens noteren welke autoriteiten voor haar certificaten mag uitgeven. Een browser zou dan kunnen zeggen “dit certificaat voor blog.iusmentis.com is weliswaar vertrouwd vanwege het root certificate van de Democratische Republiek Bordurië, maar iusmentis.com zelf geeft aan dat alleen het Nederlandse SIDN dit mag zeggen”. Het is alleen niet echt in gebruik.

Morgen is de stemming over dit voorstel, en de hoop is dat men op het laatste moment toch de onzinnigheid hiervan inziet.

Arnoud

Brussel onderzoekt of advertenties voor client-side scanning in strijd met DSA zijn

De Europese Commissie onderzoekt of een eigen politieke microtargeting advertentiecampagne op X, die steun voor het omstreden client-side scanning zocht, in strijd met de Digital Services Act (DSA) is. Dat meldde Security.nl onlangs.

Enige tijd terug tech-expert Danny Meki? dat de Europese Commissie op X een advertentiecampagne heeft gevoerd waarbij het via microtargetting zich richtte op mensen in Nederland, Zweden, België, Finland, Slovenië, Portugal en Tsjechië die wel eens tegen het voorstel zouden kunnen zijn. Deze kregen dan zeer gerichte tegenargumenten.

De ontdekking openbaar maken leverde Meki? – net als professor Armand Girbes – een shadowban op bij X: beperkt vindbaar gemaakt, zonder enige motivatie. Dat dát een DSA overtreding is, lijkt me duidelijk. Maar hoe zit dat met dat profileren zelf.

De DSA is gericht op reguleren en transparantie, maar verbiedt an sich niet zo heel veel dingen. Ook bij advertenties (artikel 26) wordt er met name gevraagd om dingen aan te geven:

  1. Duidelijk markeren dat iets een advertentie is;
  2. Van wie deze afkomstig is (en wie er voor betaalde, indien niet dezelfde entiteit);
  3. “Rechtstreeks en gemakkelijk toegankelijke nuttige informatie over de belangrijkste parameters die worden gebruikt om te bepalen aan welke afnemer de reclame wordt getoond en in voorkomend geval over de wijze waarop die parameters kunnen worden veranderd.”
(Over dat laatste blogde ik laatst.) Dit is gericht op transparantie, weten waarom je bepaalde advertenties krijgt. Maar als die informatie inhoudt “we hebben een profiel samengesteld dat bij jou en nog 10 mensen in de EU paste” dan is daar verder niets mis mee.

Een direct verbod zie ik verder niet. Van de zeer grote platforms zou je wellicht nog kunnen zeggen dat zij microtargeting moeten zien als een systemisch risico, en daar dan maatregelen tegen moeten nemen, maar dat is bepaald indirect.

Al sinds 2021 ligt er een voorstel voor een Verordening over transparantie bij politieke reclame. Van de zomer is dit stil komen te vallen, de redenen zijn onduidelijk. Maar de bedoeling hiervan is om targeting op basis van persoonsgegevens expliciet te verbieden (art. 12).

De verwijzing naar persoonsgegevens suggereert dat de AVG er ook wat van zou moeten vinden, maar een hard verbod ga je niet vinden in deze wet. Je kunt natuurlijk zaken aandragen als profileren, maar dat geldt bij álle advertenties en wordt niet anders omdat jij vrij specifiek eruit gepikt wordt.

Het enige echte argument uit de AVG betreft je politieke voorkeur: als de (micro)targeting gericht is op politieke tegenstanders, dan worden bijzondere persoonsgegevens verwerkt en dat is simpelweg verboden voor zo’n doel.

Arnoud