Bits of Freedom krijgt ook in hoger beroep gelijk over keuzevrijheid op Instagram

Photo by Zhivko Minkov on Unsplash

Nederlanders behouden de keuzevrijheid om zelf te bepalen hoe hun tijdlijnen op Instagram en Facebook eruitzien, zo meldde Nu.nl vorige week. In hoger beroep bepaalde het Gerechtshof Amsterdam dat Meta gewoon moet zorgen voor een keuze tussen een algoritmische en een ‘gewone’ tijdlijn. En dat dus dankzij Bits of Freedom.

Vorig jaar oordeelde de rechter dat Meta de gebruikerskeuze moet respecteren:

In dit geval ging het om wat het vonnis “aanbevelingssystemen” noemt, zeg maar je feed met berichten. Vroegâh was dat simpel omgekeerd-chronologisch: de nieuwste eerst. Nu gebruikt men termen als “for you”, “Most relevant” of “hot” en moet je maar hopen dat je alles ziet dat je wil zien.
Het probleem was toen niet zozeer dat er geen nieuwste-eerst feed was, maar dat die lastig aan te zetten was en ook nog eens vanzelf terugfloepte naar een algoritmische doomscrolling feed. Dat mocht dus niet van de Digital Services Act uit 2022 en och jeetje kermde Meta toen, dat kunnen wij écht niet in een paar weken inbouwen.

Dat leidde tot een executiegeschil een maand later, dat weinig opleverde voor het databedrijf. Daarop was men in hoger beroep gegaan, waar begin deze maand uitspraak werd gedaan. En ook hier blijft alles bij de originele uitspraak.

Vooruit, Meta kreeg gelijk dat haar “v-knopje” voor het keuzemenu wel degelijk voldoet. Volgens BoF was dat niet duidelijk genoeg, maar het Hof vindt dat het “v” symbool een gebruikelijk symbool voor een keuzemenu is.

Wel weer heel mooi: het Hof ziet dat dwangsommen voor Big Tech problematisch zijn, wat men eufemistisch “de financiële toestand van Meta Ierland” noemt. Meestal impliceert die term dat iemand te weinig geld heeft. Maar hier is de zorg dat de dwangsommen te snel het plafond raken en dat Facebook dan niets meer zal doen. Daarom verhoogt men dat plafond gelijk maar even naar tien (was vijf) miljoen Euro.

Arnoud


Waarom kun je ebooks niet gewoon kopen en meenemen?

Photo by Pickawood on Unsplash

Een lezer vroeg me:

Vroeger kocht je nog gewoon boeken. Die waren dan van jou. Nu koop ik ebooks, maar kennelijk worden die niet je eigendom? De aanbieder kan ze ineens weghalen of terugtrekken, en ze naar een ander platform overzetten is al helemaal niet mogelijk. Wat zit hier juridisch achter, waarom is dat niet gewoon gelijk getrokken?
Een oud motto van de Nederlandse overheid was altijd: wat offline geldt, moet ook online gelden. Maar helaas is dat een beetje verloren gegaan in de modernde tijd.

In de kern is het probleem dat het concept ‘ebook’ heel lang gewoon niet in een juridisch vakje te duwen was. Het begrip eigendom geldt alleen voor fysieke, tastbare dingen – dingen die pijn doen als ze op je voet vallen. Voor ontastbare dingen bestaat het begrip vermogensrecht, maar dat gaat vooral over hoe je het aan een ander geeft.

Een ebook is dus niet je eigendom simpelweg omdat de wet dat niet als zodanig ziet. En dan mag de aanbieder zelf de regels invullen, en dat gebeurt natuurlijk in hun voordeel. Je mag er bij, tot het niet meer mag. Kopiëren, printen, copypaste: alleen als wij dat toestaan. En oh ja, regels over het omzeilen van zulke restricties zijn wél wettelijk vastgelegd: het kraken van kopieerbeveiligingen is onrechtmatig (en bij software zelfs een misdrijf).

Sinds een paar jaar is dit in Europa iets beter geregeld. Tegenwoordig staan er wel regels in de wet over “digitale inhoud”, volgens de wet”gegevens die in digitale vorm worden geproduceerd en geleverd”. Ebooks zijn daarvan het klassieke voorbeeld. Hier heb je, net als bij fysieke aankopen, recht op een goed product en dus ook garantie als dat niet zo blijkt te zijn.

Het is niet helemaal hetzelfde. Zo is er geen plicht dat digitale inhoud altijd moet werken. De mogelijkheden, compatibiliteit en interoperabiliteit moeten vooraf duidelijk gemeld zijn en anders heb je recht op geld terug. Helaas is daarbij niet expliciet geregeld hoe lang je van die inhoud moet kunnen genieten, anders dan “een periode die is afgestemd op het doel waarvoor de informatie kan dienen”. Oftewel: een ebook moet werken zo lang als je mag verwachten dat ‘ie werkt.

Het gebrek aan regels op dit punt vind ik een van de grootste gebreken van de informatiemaatschappij. Maar helaas is er weinig aan te doen buiten de wetgever aansporen hier meer regels over te maken.

Arnoud

Mag een bedrijf mij in de voorwaarden verbieden ze negatief te recenseren?

Photo by Markus Winkler on Unsplash

Een lezer vroeg me:

Ik ben een kleine ondernemer. Recent heb ik een online cursus gekocht, waarvan de inhoud me zó tegenviel dat ik anderen er voor wilde waarschuwen. Daarop kreeg ik een mail van de cursusaanbieder dat ik de voorwaarden had geschonden en €150 boete moet betalen voor iedere dag dat die review nog online staat. Kan dat zomaar?
Een boetebeding in algemene voorwaarden kán op zich, zeker in een zakelijke overeenkomst. (Bij consumenten is meestal niet haalbaar.) De rechter kan boetes matigen, bijvoorbeeld als er geen totaal maximum bij staat of als de bedragen excessief zijn voor de overtreding.

Meestal worden boetes verbonden aan specifieke plichten, zoals geheimhouding schenden, het werk hinderen of medewerkers van de wederpartij in dienst proberen te nemen. Daar is op zich weinig mis mee, en je kunt er in principe vrij over onderhandelen.

Hier wordt de boete verbonden aan iets dat in principe los staat van de overeenkomst, namelijk klagen over de overeenkomst. Letterlijk verboden is dat niet, maar toch verwacht ik dat de rechter dit zal vernietigen als onredelijk bezwarend. Daarvoor zijn twee redenen:

  1. Er is geen redelijke grond om zo’n verbod op te nemen. Dit heeft niets te maken met de kwaliteit van het werk of daarmee samenhangende afspraken.
  2. Een klacht of recensie (binnen het legale en fatsoenlijke) betreft een uiting in het algemeen belang. Daarmee wordt een grondrecht van de klant geschonden.
Probleem is natuurlijk dat dit geen zekerheid is, en dat je dus naar de rechter zou moeten om hier een uitspraak over te krijgen. Daar kan ik alleen tegenover stellen dat ik eigenlijk nog nooit heb gezien dat er zakelijk werd geprocedeerd over zo’n recensie-boete.

Arnoud

Gaat AI het concept open source definitief verwoesten?

Photo by Claudio Schwarz on Unsplash

Het chardet-project heeft laten zien dat AI open source kapot gaat maken, aldus Bruce Perens. En hij kan het weten, want hij schreef de definitie van open source destijds. Chardet is van licentie veranderd na een AI-herimplementatie, en de vraag is dus of dat kan.

Chardet is een Python-bibliotheek die van een tekst aangeeft in welke codering (zoals UTF-8, Cyrillisch of Oost-Aziatisch) deze opgemaakt is. Handig ding, wel even opletten want de licentie is de bekende LGPL. Dus wijzigingen aan de library zelf kun je alleen onder LGPL verspreiden. (En dat verhaal over statisch en dynamisch linken.)

Sinds versie 7 is de bibliotheek ineens onder de MIT licentie beschikbaar. Dat scheelt, want de enige eis is dan dat je de auteursvermelding en licentietekst niet weghaalt uit de broncode. En dat je de auteur, in dit geval ene Dan Blanchard, niet aansprakelijk kunt stellen, maar dat terzijde.

Zoals Perens uitlegt:

Blanchard says he was in the clear to change licenses because he used AI – Anthropic’s Claude is now listed as a project contributor – to make what amounts to a clean room implementation of chardet. That’s essentially a rewrite done without copying the original code – though it’s unclear whether Claude ingested chardet’s code during training and, if that occurred, whether Claude’s output cloned that training data.
Probleem: hoewel Blanchard de code sinds 2012 onderhoudt, was hij niet de originele auteur. Dat was Mark Pilgrim, die rond die tijd van internet was gevallen maar nu ineens weer opdook met een boze ticket: No right to relicense this project.

Auteursrechtelijk klopt dat; zonder overdrachtsakte kan Blanchard code van Pilgrim niet onder een andere licentie plaatsen. Maar Blanchard stelt dus dat versie 7 een geheel nieuwe versie is, en roept daarbij dat zelfs een “clean room implementation” vormt.

Clean room reverse engineering is een oude techniek waar veel mythes omheen hangen. Kort gezegd: groep A analyseert iemands software en documenteert wat het moet doen. Groep B krijgt die documentatie en maakt software die dat doet. A’s analyse is legaal, en B kopieert de software niet dus handelt ook legaal.

Dit staat of valt met één cruciale aanname, namelijk dat B geen toegang heeft tot de software die A analyseert. Want als je wél kopieert, ga je nat. En toegang hebben en dan iets sterk vergelijkbaars maken levert op zijn minst een donkerbruin vermoeden van kopiëren op.

Clean room werkte om geheim gehouden software (zoals de IBM PC BIOS software) legaal te kunnen imiteren. Maar bij open source is het juridisch gezien absurd om van clean room te spreken. De broncode ligt letterlijk voor het oprapen. Dus hoe kun je dan met droge ogen beweren dat je een schone herimplementatie hebt gemaakt?

Oh ja, we deden het met AI. Blanchard zegt allereerst dat zijn nieuwe code vrijwel volledig anders is, wijzend op een software-plagiaattool die slechts 1,29% gelijkenis tussen de bronbestanden ziet. Dat komt dan weer omdat Blanchard aan de codegenerator van Anthropic’s Claude heeft gevraagd een nieuwe versie te maken:

For full transparency, here’s how the rewrite was conducted. I used the superpowers brainstorming skill to create a design documentspecifying the architecture and approach I wanted based on the following requirements I had for the rewrite […]
Hij gebruikte daarbij nadrukkelijk de opdracht “kijk niet naar de LGPL code”, wat voor mij net zo nuttig is als “maak geen fouten” in je prompt. Zeker omdat het volgens mij een publiek geheim is dat LLM-codegeneratoren getraind zijn op Het Hele Internet en dus ook op alles op Github. Waaronder de originele chardet.

Clean room is dit dus zeker niet te noemen. Tegelijk wordt het inbreuk-argument wel weersproken door de feitelijke ongelijkheid tussen de broncodes. Er moet wel iets aantoonbaar overgenomen zijn om van inbreuk te mogen spreken.

Uiteindelijk is dat het punt van Perens: als je dus tegen een AI kunt zeggen “herschrijf deze code” en de gelijkenis is lager dan X procent, dan is iedere OSS licentie te omzeilen door de software gewoon even door zo’n LLM-room te halen.

Arnoud


Kan ik aansprakelijk worden gesteld als ik gratis bouwtekeningen beschikbaar stel?

Photo by Amsterdam City Archives on Unsplash

Via Reddit:

Hobbymatig vind ik het leuk om gebouwen te ontwerpen en uit technisch uit te werken. Nu had ik het idee om deze te gaan delen via een website waar mensen de ontwerpen, technische tekeningen e.d. kunnen downloaden. … De stukken zullen achter een acceptatie van een disclaimer komen waarbij ik aangeef dat ten alle tijden de stukken door een professional gecontroleerd moet worden en dat zaken zoals een constructieberekening moet worden gemaakt. [M]maar ik weet niet of dat dan voldoende is.
Als het gaat om eigen tekeningen, dus niet van elders vandaan gehaald, dan zie ik niet direct hier een probleem mee. Het is niet verboden om gebouwontwerpen vrij te delen.

Praktisch haal je je veel gedoe op de hals. Mensen zullen je tekening aanzien voor een doordacht ontwerp, doorgerekend en conform bouwkundig advies. Oftewel: we kunnen hierop bouwen, en als het instort is dat jouw fout.

Mensen denken dan gelijk aan disclaimers, zoals ook hier:

alle downloads op deze websites zijn met uiterste zorg vervaardigd echter dienen deze door professionals gecontroleerd te worden op juistheid alvorens dat deze worden gebruikt. …

Met deze tekeningen kan niet zoals ze nu zijn worden gebouwd

Dat klinkt goed, en als je dit inbouwt in een downloadproces als verplicht vinkje dan zou je een heel eind moeten komen.

De vaste lezer van deze blog weet dat ik skeptisch ben over disclaimers. De voornaamste reden is dat ze meestal worden gecombineerd met grote beloften, en mijn mantra is nu eenmaal dat de kleine lettertjes niet kunnen afnemen wat de grote letters hebben toegezegd.

Een disclaimer is dus niet een oplossing op zich. Het is het sluitstuk van een website die overal ademt dat het vrijblijvende tekeningen-ter-inspiratie zijn, waar je zelf best mee kunt beginnen maar die je moet laten controleren. En dat vereist dus meer dan “Gratis bouwtekeningen downloaden punt ennel” en wat generieke teksten.

Arnoud

Kan ik vanwege NIS2 de directie van Odido persoonlijk aansprakelijk stellen voor mijn schade uit dat datalek?

Photo by Danielle Cerullo on Unsplash

Een lezer vroeg me:

Dankzij het Odido-datalek heeft mijn stalker me weer weten te vinden. Ik moet nu mogelijk noodgedwongen verhuizen, nieuw nummer nemen en wat al niet meer. Nu las ik dat onder de NIS2 Richtlijn de directie van een telecombedrijf persoonlijk aansprakelijk is voor schade door falende beveiliging. Kan ik een claim indienen?
Inderdaad bevat de NIS2 Richtlijn (2022/2555) een artikel dat een route biedt voor persoonlijke aansprakelijkheid van de directie. Artikel 20 lid 1 bepaalt namelijk:
De lidstaten zorgen ervoor dat de bestuursorganen van essentiële en belangrijke entiteiten de door deze entiteiten genomen maatregelen voor het beheer van cyberbeveiligingsrisico’s goedkeuren om te voldoen aan artikel 21, toezien op de uitvoering ervan en aansprakelijk kunnen worden gesteld voor inbreukendoor de entiteiten op dat artikel.
Doel hiervan is natuurlijk om de zorg voor goede cyberbeveiliging in de boardroom urgent te maken. De term “in privé aansprakelijk” is iets om je druk over te maken als bestuurder van een groot bedrijf.

Telecom (openbare elektronische communicatienetwerken of -diensten) is een essentiële entiteit, en het lijkt er sterk op dat de beveiliging van persoonsgegevens niet adequaat was bij Odido. Dus daarmee is dit artikel overdreven en kunnen we procederen, toch?

Niet helemaal. NIS2 is een richtlijn, geen verordening zoals de AVG of AI Act. Dat betekent dat deze pas rechtskracht heeft als Nederland een wet heeft aangenomen die NIS2 nader uitwerkt. Dat is nog steeds niet gebeurd, hoewel dat eigenlijk wel had gemoeten. Ik citeer de digitale overheid:

De Cyberbeveiligingswet treedt in werking nadat de Tweede en Eerste Kamer akkoord hebben gegeven. Naar verwachting is dat Q2 2026, maar dat hangt af van wanneer de behandeling in de Kamers is.
Totdat die wet er is, kun je je dus niet rechtstreeks op de bepalingen eruit beroepen. Zogeheten horizontale directe werking bestaat niet bij richtlijnen, zeggen juristen dan. (De overheid aansprakelijk stellen voor de te late implementatie is een theoretische optie, die bij de illegaaldownloadendiscussie werkelijk werd ingezet.)

Soms is er indirect wat mogelijk. Dat heet richtlijnconforme uitleg: kunnen we een wél geldende wettelijke bepaling zo lezen dat wat de richtlijn bedoelt, er ook onder valt. Dat kan alleen als er ruimte voor interpretatie is, je mag niet een wetsartikel tegen de letterlijke tekst in oprekken. Ook moet het wel redelijk blijven.

In het voorstel van wet van de Cyberbeveiligingswet staat in het geheel geen artikel dat persoonlijke aansprakelijkheid voor bestuurders regelt. De Memorie van Toelichting legt uit:

Het voorgaande brengt met zich mee dat de artikelen 20, eerste lid … NIS2-richtlijn reeds zijn geïmplementeerd in het Nederlands recht. … Ten overvloede wordt nog opgemerkt dat naast het voorgaande ook civielrechtelijke aansprakelijkheid van het bestuur jegens de entiteit een rol kan spelen in het geval van niet-naleving van de Cbw, onder andere op grond van artikel 2:9 BW.
Dat laatste wetsartikel verwijst naar wat wij interne aansprakelijkheid noemen. De organisatie kan een bestuurder aansprakelijk stellen als deze te kort blijkt te zijn geschoten in zijn bestuurstaak. Artikel 20 lid 1 NIS2 is dan niet meer dan een verduidelijking dat cyberbeveiliging regelen een bestuurstaak is, zodat de interne aansprakelijkheid nu al mogelijk is. Odido zelf kan dus haar directie aansprakelijk stellen voor de schade als blijkt dat er wanbestuur gepleegd is op dit gebied.

Als slachtoffer de directeur persoonlijk aanspreken heet externe aansprakelijkheid, en dat regelt NIS2 dus niet. Althans, in de Nederlandse lezing – ik ben er nog niet van overtuigd dat deze beperkte insteek ook de bedoeling van de Europese wetgever was. De meeste landen hebben in hun NIS2-implementatiewet simpelweg artikel 20 overgeschreven, zodat in het midden blijft wat nu de bedoeling was.

Arnoud

Mogen al die Odido-datalekcheckers wel opereren van de AVG?

Photo by Egor Komarov on Unsplash

Een lezer vroeg me:

Door een hack bij mijn telecomprovider zijn al mijn persoonsgegevens gestolen. Nu zijn er bedrijven die via een soort van lek-check laten zien wat er gestolen is en dit op naam, adres, email, iban etc zoekbaar aanbieden. Indirect verwerken en verspreiden zij zo opnieuw de gestolen data. Hebben zij daar een grondslag voor?
Om bij het begin te beginnen: het is strafbaar (art. 139g Sr) om gegevens te verwerven of voorhanden te hebben waarvan je redelijkerwijs kunt vermoeden dat ze uit misdrijf zijn verkregen. De Odido-datadump voldoet aan die omschrijving.

Vereist bij dit strafwetartikel is dat de gegevens “niet-openbaar” zijn, en daar kunnen we ondertussen over twisten. De gegevens zijn niet alleen te vinden via een specifieke .onion link of een in Nederland onbekende site, maar ook via vrij makkelijke kanalen, al moet je nog even nadenken over de Google-zoekopdracht. De wetgever was niet duidelijk over het criterium voor “niet-openbaar”.

Verder geldt een uitzondering voor een openbaarmaking die het algemeen belang dient, en daar beroepen alle datalek-checkers zich natuurlijk op. Dat is belangrijk, want zonder algemeen belang is het een strafbaar feit om de data te ontsluiten en daarmee verbiedt ook de AVG de verwerking (artikel 5 lid 1 onder a, geen rechtmatig doel).

Wat is dat algemeen belang? Naar zijn aard is dat vrij generiek. Het heeft maatschappelijk nut, de mensen vragen erom, er is behoefte in brede zin. Gezien de zeer beperkte communicatie vanuit Odido snap ik goed dat mensen concreet willen weten wat er gelekt is, en een checker komt aan die behoefte tegemoet. Dat is wel algemeen belang.

Daar staat tegenover dat er al diverse aanbieders zijn, waaronder het bekende en vertrouwde Have I Been Pwned. Ook onze politie heeft een kopie, dus je kunt (in theorie) een inzageverzoek onder de Wet politiegegevens bij ze doen. Formeel weegt “anderen doen het ook” niet mee bij een algemeen-belang afweging, want je zegt bij nieuws ook niet dat de nieuwswaarde vervallen is als drie kranten het al gebracht hebben. Maar ik vermoed dat dit hier zeker een discussie gaat zijn mocht dit bij de (straf)rechter komen.

Aangenomen dat de checker in het algemeen belang handelt, kom je bij de vraag welke grondslag. Er zijn er twee die relevant lijken:

  1. vitale belangen van de betrokkene
  2. gerechtvaardigd belang van de aanbieder of een derde
Punt 1 klinkt relevant, maar “vitaal belang” wordt zo beperkt uitgelegd dat je er niet aan komt tenzij het echt om leven en dood gaat. (En dan nog zijn er genoeg mitsen en maren.)

Gerechtvaardigd belang dus. Dit belang is dan gelijk aan het algemeen belang dat de aanbieder van de dienst nastreeft (en dus niet het belang van de betrokkene, want die is niet een ‘derde’ volgens dit artikel). Daar moet deze dan een belangenafweging bij doen: is voldoende rekening gehouden met de privacy van de betrokkenen die allemaal in die dataset zitten, had dit met minder ingrijpende middelen gekund en is het allemaal netjes ingericht?

Een eerste checkvraag voor mij is altijd hoe men de AVG-rechten van betrokkenen respecteert. Kun je zonder gedoe verlangen dat je uit de checker wordt gehaald? Ik heb vele van deze diensten gezien en zelden zit dat er netjes in.

Tweede vraag is hoe de dienst beveiligd is. Het is natuurlijk niet de bedoeling dat bezoekers de dataset kunnen downloaden of leegtrekken met systematische zoekopdrachten.

Derde is hoe en of je de data met derden deelt, zoals je websitebouwer of de plek waar je de eigenlijke dataset hebt neergezet. Ik weet van diverse partijen die de dienst door AI laten schrijven. Dat is nogal spannend, want dan geef je dus die data zonder voorbehoud aan een Amerikaanse partij die er alles mee mag doen. Dat ligt onder de AVG op zijn zachtst gezegd nogal gevoelig. Los daarvan is de kans groot dat je code niet zo veilig is als je zou hopen.

Een juridisch detail is nog of de AP zou mogen optreden tegen zo’n site. Vanwege het beroep op het algemeen belang is hier denk ik de uitzondering voor journalistieke doeleinden van toepassing (artikel 43 lid 1 Uitvoeringswet AVG). De AP is niet bevoegd op te treden tegen gebruik van persoonsgegevens in de media.

Arnoud

Nepwebshops sneller offline door samenwerking tussen politie en Thuiswinkel.org

Malafide webshops kunnen voortaan aanzienlijk sneller uit de lucht worden gehaald dankzij een nieuwe samenwerking tussen de politie en brancheorganisatie Thuiswinkel.org. Dat meldde ICT/Magazine onlangs. Dit is net even wat anders dan het begrip ’trusted flagger’ uit de DSA, maar het concept is hetzelfde.

Malafide webshops zijn een enorme plaag, en brancheorganisatie Thuiswinkel.org krijgt daar jaarlijks honderden klachten over. Vaak gaat het om eenvoudig te spotten kwesties, zoals een copycat van een echte webshop of misbruik van erkenningen zoals het Thuiswinkel-logo om consumenten te misleiden.

In het oude proces kon Thuiswinkel dan aangifte doen, maar dan moest de politie dat opnieuw onderzoeken en dat kost tijd en capaciteit die er niet is. (Meelezende politici: als je nou elke keer bij “ik moet een nieuwe wet maken” bedenkt “nee, de toezichthouder hiervoor moet meer budget” dan lossen we héél veel problemen sneller op.)

Thuiswinkel.org is door het Landelijk meldpunt internetoplichting van de politie aangewezen als trusted flagger. Daarmee wordt zij in de kern altijd geloofd als ze stelt dat een webshop strafbaar bezig is:

Door de samenwerking tussen Thuiswinkel.org, het LMIO en SIDN ontstaat een korter en effectiever keten, waarin sneller kan worden ingegrepen tegen online fraude. Wanneer het LMIO vaststelt dat sprake is van oplichting, volgt SIDN, de beheerder van het .nl-domein, een speciale procedure om de webwinkels gezamenlijk met het LMIO zo snel mogelijk offline te halen. Elk uur dat een malafide webshop langer online blijft, vergroot immers het aantal slachtoffers.
De term lijkt hier informeel te worden gebruikt, ik kan althans geen wettelijke regeling vinden (tussen politie en SIDN bestaat een convenant). In de Digital Services Act (DSA) staat dit concept wel gedefinieerd (artikel 22):
Aanbieders van onlineplatforms nemen de nodige technische en organisatorische maatregelen om te verzekeren dat meldingen die zijn gedaan door betrouwbare flaggers die binnen hun aangewezen expertiseterrein werken via de in artikel 16 genoemde mechanismen prioritair en onverwijld worden verwerkt en afgehandeld.
Oftewel: meldingen van deze partijen moeten met voorrang en onder aanname van juistheid worden opgepakt. Je moet dan wel specifieke expertise en bevoegdheid hebben, en daarna wordt je door de toezichthouder (de ACM) aangewezen. Eind 2025 gebeurde dat bijvoorbeeld voor stichting Brein en Meld Online Discriminatie. Dit betreft echter dus flaggers die bij grote platforms (zoals Facebook) meldingen doen, niet bij de politie of SIDN.

Arnoud


Mijn ebook heeft geen paginanummers zoals de papieren editie, heb ik recht op mijn geld terug?

Photo by Spencer on Unsplash

Via Reddit:

Afgelopen zomer heb ik een ebook gekocht voor school bij een grote webshop. Nu moet ik dit ebook gebruiken om me voor te bereiden op lessen, en de docenten geven dan paginanummers die ik moet lezen (dus niet hoofdstukken). Het probleem is dat die paginanummers niet overeen komen met het fysieke boek (zelfde boek en druk). Ook worden de pagina’s op onlogische plekken opgesplitst wat niet fijn leest. … Heb ik hier recht op geld terug, of had ik zoals de verkoper aangeeft het probleem eerder moeten melden?
Die laatste bijzin gaat over het punt dat de verkoper een annulering van de koop weigert, omdat deze meer dan 30 dagen geleden is gedaan. Dat is een eigen uitbreiding op de wettelijke retourregels voor ebooks.

Hier gaat het echter niet om een retour zonder reden, maar om een klacht dat het product niet conform de verwachtingen zou zijn. Bij een boek verwacht je pagina’s met tekst, en ik zie hoe het een verrassing kan zijn dat een ebook bij pagina 23 niet hetzelfde laat zien als de papieren editie.

De al wat oudere lezer denkt bij ebooks wellicht aan pdf-achtige structuren (zoals je krijgt bij mijn boeken), die inderdaad 1-op-1 overeenkomen met de drukversie. Dat is immers gewoon de drukversie in lage resolutie.

Voor echt prettig online lezen worden vaker formaten zoals Epub en Mobi gebruikt. Deze bieden de content als een soort stroom aan, waarbij pagina’s meer zijn “het volgende stukje content dat past op het scherm, gegeven het gekozen lettertype en -grootte”. Maar inderdaad kun je dan niet makkelijk pagina 23 tot en met 48 bestuderen, die koppeling ontbreekt.

Bij ebooks heb je recht op een product (“digitale inhoud”) dat voldoet aan de gewekte verwachtingen (art. 7:50ad BW), net zoals bij fysieke producten. Artikel 7:50ae noemt een aantal aspecten zoals beschrijving, hoeveelheid en kwaliteit, functionaliteit, compatibiliteit en interoperabiliteit. Dat gaat over het ebook an sich, niet over hoe het zich verhoudt tot papieren boeken.

Uitleg hierover is moeilijk te vinden. Bij de grote blauwe vrienden van Bol staat dit bekende zelfhulpboek bijvoorbeeld zowel als paperback, ebook als Kobo ebook te koop. Maar ook bij enig rondspitten bij de klantenservice kan ik niet vinden dat een ebook wel eens andere pagina-structuren zal hebben dan het papieren boek. Is dat dan als algemeen bekend verondersteld, of gewoon niet relevant?

Voor mij weegt hier wel zwaar dat het om een studieboek gaat. Bij een roman is “aantal pagina’s” totaal niet relevant, zeker niet in de vergelijking tussen de hardcover en de paperback. Natuurlijk zal dat afwijken.

Bij een lesboek zie ik dit eerder als problematisch, juist omdat je daar niet lineair leest maar eerder bladert, heen en weer springt of op instructie naar een pagina gaat voor een stukje informatie. Denk alleen al aan de index achterin. Ik ben dus geneigd dit hier inderdaad een conformiteitsprobleem te noemen.

Arnoud


dat voldoet


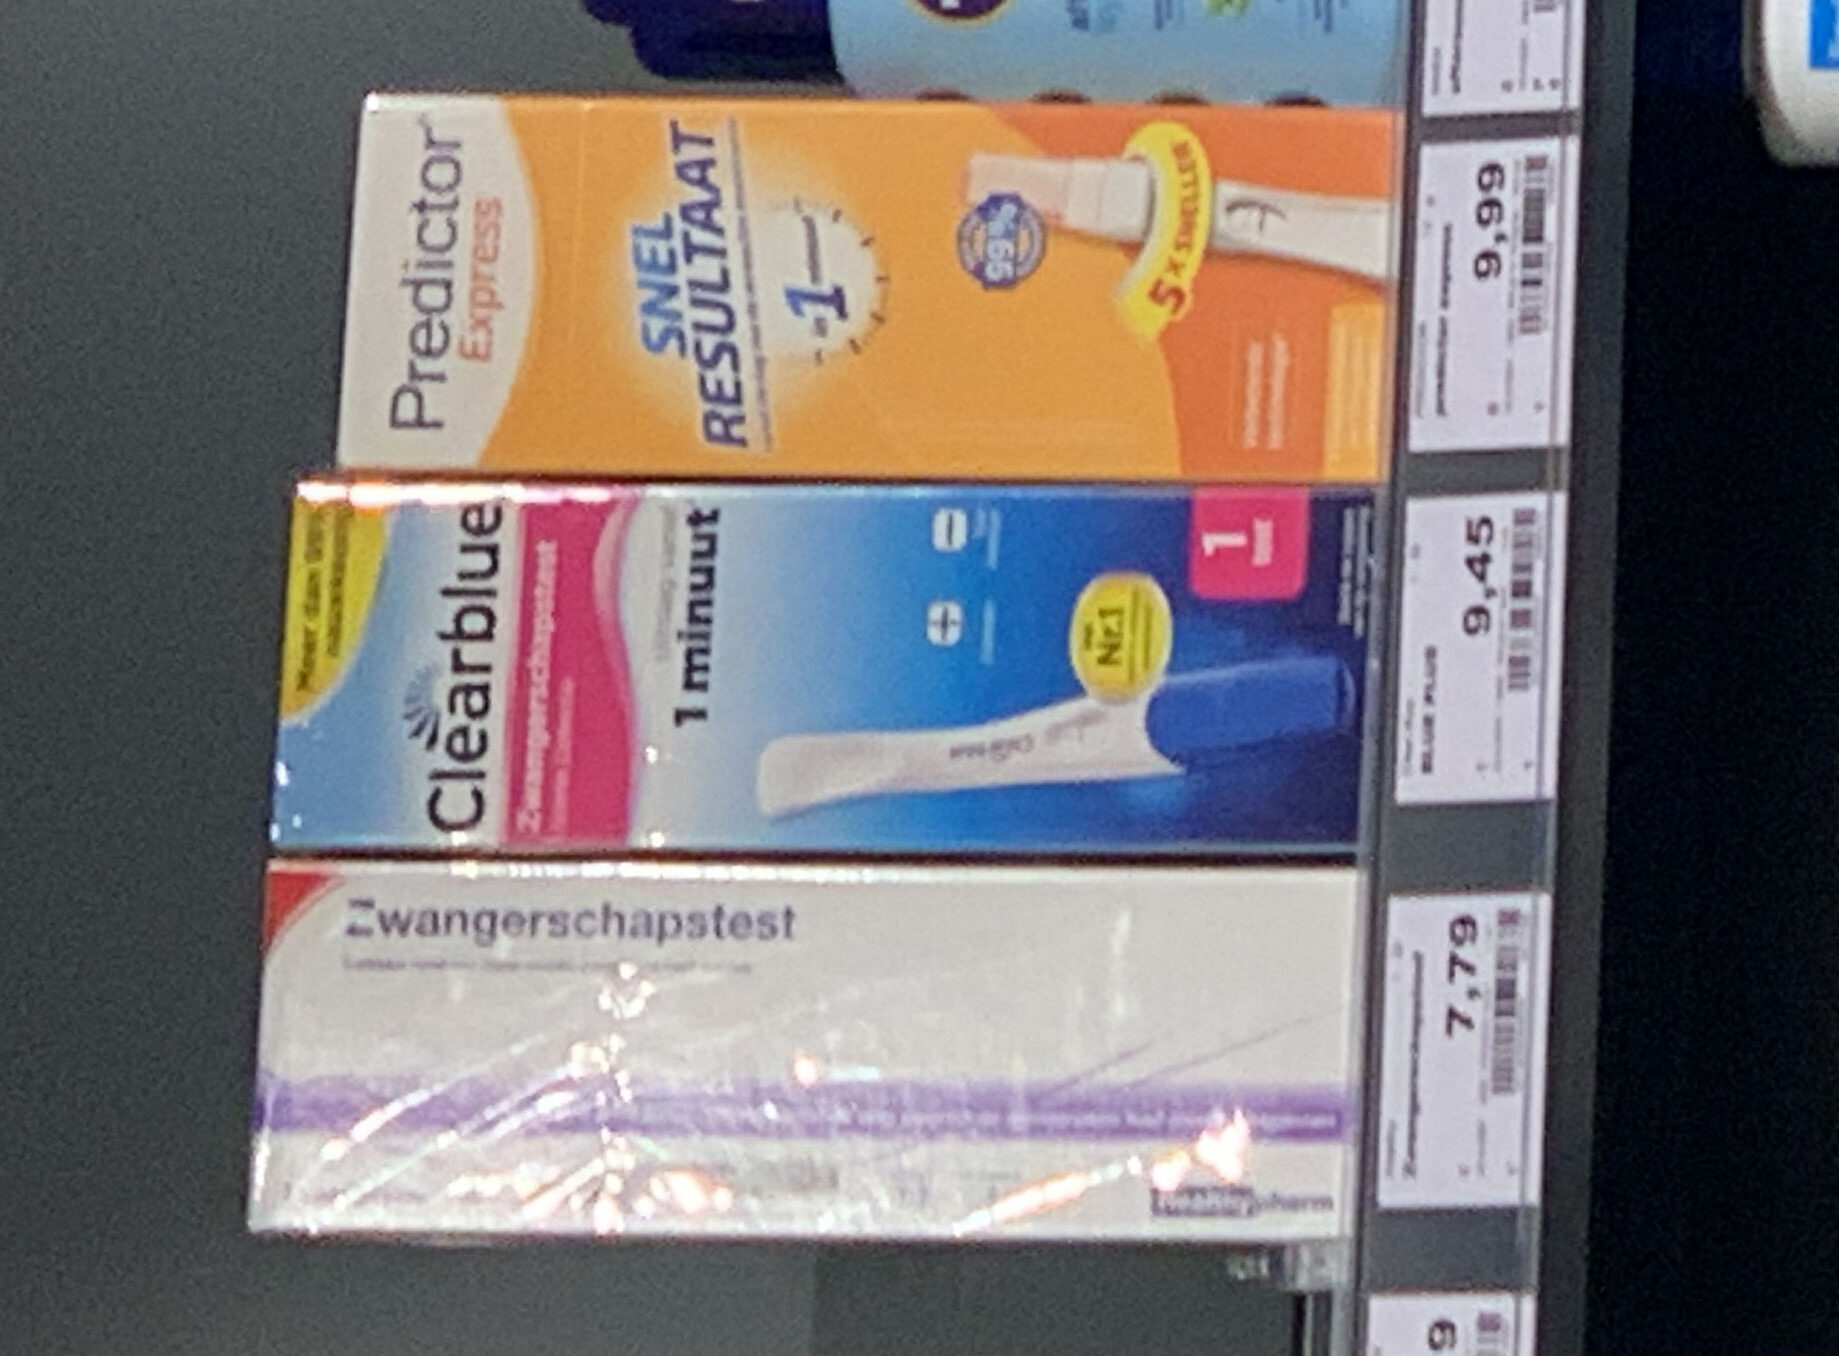
Nederlandse supermarkten lieten big tech weten dat je zwangerschapstest koopt

Foto: Milliped, Wikimedia Commons

Nederlandse supermarkten en drogisterijen bleken massaal data over interesse in of aankopen van zwangerschapstesten door te sluizen naar grote techbedrijven als Google en Meta. Dat meldde Tweakers vorige week op basis van onderzoek van de Groene Amsterdammer en Investico. Mag niet, maar heel kwaadaardig voelt het ook weer niet.

Bij Investico leggen ze uit:

De drogisten hebben zogenoemde ‘tracking cookies’ op hun website staan, waarmee Google, Meta en Tiktok gebruikers van de homepage tot in het winkelmandje kunnen volgen. ‘Die cookies bevatten codes die uniek zijn voor jouw computer of browser’, zegt Güne? Acar, computerwetenschapper aan de Radboud Universiteit. ‘Als je ergens bent ingelogd bij bijvoorbeeld Google, Youtube, Facebook of Instagram, kunnen ze de zwangerschapstest meteen linken aan de rest van de informatie die ze over je hebben. Zo volgen ze je over het hele internet.’
Heel bijzonder is dit niet: heel ecommerce-internet hangt aan elkaar van de tracking cookies, pixels en serverside technieken om maar zo veel mogelijk over datapunten, pardon consumenten te weten te komen.

Dus tsja, als jij na je pak melk of beautyproduct ook een zwangerschapstest in je mandje doet, dan gaat dat via hetzelfde kanaal naar dezelfde Big Tech partijen. Het is geen  gericht besnuffelen op zwangerschap of andere gezondheidszaken, maar gewoon wat gebeurt als je als winkel tracking aanzet.

Tegelijkertijd: nee, mag niet. Want zwangerschap is (hoewel geen ziekte) een gezondheidsgegeven, en dus een bijzonder persoonsgegeven onder de AVG. Dat mag niet worden verwerkt behalve in bijzondere gevallen die hier niet opgaan. Ook niet als het in je cookiebanner staat, als je het had kunnen weten of als je “ja (uitdrukkelijk)” klikt op de banner.

Alleen: is “bezoeker thx1137 koopt een zwangerschapstest” wel een persoonsgegeven? Drogist DA meent van niet, aldus het Tweakers-artikel:

“Het bestellen van een zwangerschapstest in een webshop leidt niet tot bijzondere persoonsgegevens. Een dergelijke bestelling kan namelijk bedoeld zijn voor iemand anders of voor een onzekere toekomstige situatie. Dit betekent dus dat dergelijke informatie niet met zekerheid iets zegt over de gezondheidstoestand van de klant. De koop van een zwangerschapstest vormt een persoonsgegeven, maar geen bijzonder persoonsgegeven zoals bedoeld in de AVG”, meent DA.
“Onzekere toekomstige situatie”, da’s er eentje voor naast “geen actieve herinnering”. Maar de kern van het argument is: is iets een bijzonder persoonsgegeven als het kan wijzen op gezondheid, of pas als we zeker weten dat het daarover gaat?

Dit argument kwam in 2024 aan de orde in het Lindenapotheke-arrest van het Hof van Justitie (C-21/23). Dat ging over de vraag of concurrenten elkaar van AVG-schendingen mochten betichten, maar onderliggend was de kwestie of de verkochte producten (apothekerswaren) raakten aan bijzondere persoonsgegevens.

Ook hier kwam het argument langs dat je dat niet 100% zeker weet, omdat je geen doktersrecept hebt. Maar het Hof van Justitie wijst dat scherp af (punt 78):

Gegevens over de aankoop van geneesmiddelen die het mogelijk maken om conclusies te trekken over de gezondheidstoestand van een geïdentificeerde of identificeerbare persoon, moeten dus worden aangemerkt als gegevens over de gezondheid in de zin van artikel 4, punt 15, AVG.
Genoeg hiervoor is dus dat het kan. Natuurlijk kan die conclusie dan onjuist zijn (niet Marietje is zwanger maar haar zus, voor wie zij de test kocht). Maar dat maakt expliciet niet uit:
Dit principiële verbod staat los van de vraag of de informatie die bij de betrokken verwerking aan het licht komt al dan niet juist is en of de exploitant het doel nastreeft om [de bijzondere persoonsgegevens] te verkrijgen (…).
De achterliggende gedachte is dat het om zeer zwaarwegende redenen verboden is om die gegevens te verwerken als ze gezondheidsgegevens zijn, en dat we willen uitsluiten dat die gegevens verwerkt worden met slappe-hap argumenten als “het kan anders liggen” of “onzekere toekomstige omstandigheden”.

Dus nee, dit mag niet. Ook niet als het bijvangst is van ‘gewone’ Analytics of tracking die werkelijk geen interesse heeft in medische informatie. (Verplichte link naar dat Big Data-verhaal uit 2012.)

Hoe het anders moet? Een zwarte lijst met gezondheidsproducten die uitgesloten moeten worden van de tracking. Ik weet niet of dat technisch kan. Wat ook wel weer wat zegt over Adtech: niemand weet echt hoe het werkt.

Arnoud